Meta 的组织级第二大脑构建方法:让专家隐性经验成为 AI 能持续使用的能力
从三个专业判断痛点,到知识、流程、评测与反馈改进的完整设计。
- 专家经验包含适用条件、判断顺序和例外边界;只留下最终结论,AI 仍难以复用。
- Meta 将组织知识与分析流程分开保存,让每个阶段按需读取依据,无需为知识更新重新训练模型。
- 专家纠正经过归因、修改、原案重放和回归检查,批准后同时留下更新与测试案例。
Meta 写了一篇技术博客,分享他们如何为合规等专业领域构建一个“组织级第二大脑”(Organizational Second Brain)。
它要把领域专家脑子里没有完整写下来的“隐性经验”沉淀下来,让 AI 学会按照内部专家的判断方法开展分析,并且不需要重新微调或训练大模型,就能通过专家的日常反馈持续改进。
这件事要解决的,是企业使用 AI 时一个很实际的问题:文档已经接进去了,为什么做判断时还是得找专家?专家纠正过一次,为什么下次还可能答错?
当下的核心痛点:
在合规评估中,找到一条规定,只是工作的开始。真正费时间的是判断:这条规定适不适用于当前产品?公司过去如何处理类似情况?哪些条件必须满足?什么情况需要交给专家决定?
Meta 在合规领域遇到的困难,集中在三个方面。
第一,专家知道怎么判断,但文档没有把“为什么”写清楚。
“隐性经验”包括专家习惯先看什么线索、怎样排列因素的重要性、旧结论在什么条件下有效,以及什么时候应当停止推断、找人讨论。有时专家已经熟练到不会主动解释这些步骤,历史记录便只留下了最终结论。
例如“允许小范围试用”是一条结论,却还没有告诉后来的人:试用面向谁、使用什么数据、出了问题能不能撤回。下面用一组教学规则把这些隐藏条件具体化:只有内部测试、模拟数据、可回退三项同时满足,才进入常规试用评审;其他情况转专项人工评审或补材料。 这是帮助理解的虚构规则,不是 Meta 的内部制度。
内部测试、模拟数据、可回退三项同时满足。这里决定评审路径,常规评审仍需完成,并不等于已批准上线。
改变试用人数,未必改变评审路径;把模拟数据换成真实用户信息,即使人数不变,也可能需要另一种评审。专家经验里包含的正是这种取舍:什么只是表面相似,什么才会改变判断。
将这些经验写下来,也不只是给旧文档做摘要。摘要可能仍是“项目获准试用”;可复用的知识则要保留适用条件、排除情形、判断依据和未决问题。原文介绍了从文档中离线提炼、再用专家反馈更新的办法,但没有公开完整提炼算法;文档中没有出现、专家也从未表达的经验,不能被默认视为系统已经知道。
第二,大模型懂一般知识,却不知道这家公司采用什么标准。
同样一项业务,行业里可能有几种处理方式,但公司已经基于历史经验、业务方向或风险承受能力,确定采用其中一种。
通用模型可以列出几种方案,却不知道公司已经做过这个选择。它给出的建议未必没有道理,但仍需要内部专家重新判断、修改。
缺的就是组织自己的立场:面对这个问题,我们采用什么解释,又有哪些不能越过的边界。
第三,RAG 能找资料,却不能省掉每次重新梳理判断依据的工作。
RAG,也就是检索增强生成,可以在回答前查找相关文档。但检索结果可能同时包含旧项目记录、现行规则和只适用于特殊情况的例外。
如果没有提前整理,AI 每次都要重新判断:哪份材料优先?哪些条件适用?几份资料之间有什么关系?
这既费时间,也容易导致同类问题得出不一致的结论。专家纠正了一次,如果纠正只留在聊天记录中,没有进入知识或流程,下一次分析仍可能重走同一条错路。
所以,Meta 要补上的两项能力很明确:把专家使用的判断条件提前写清楚;把后续纠错真正更新到系统中,并检查更新是否有效。
系统核心设计:四大支柱
Meta 将系统拆成四层,让判断依据、执行步骤、验收标准和反馈更新各有明确职责。

知识层保存公司采用的判断标准;推理层规定怎样完成分析;评测层检查修复和副作用;改进循环把专家反馈变成待验证的修改。
这四层相互依赖:知识有明确的文件边界,才能精确修改;分析有明确步骤,才能定位失误;评测决定修改能否通过;改进循环则把结果更新回知识和流程。
知识层:把专家每次都要解释的内容,提前整理好
Meta 先对原始文档进行离线处理,提炼其中的组织判断,整理出 200 多个结构化文本文件。
这些文件分成四类:
- 立场文件: 公司对某个问题采用什么解释,适用条件和限制是什么。
- 分类与词汇文件: 团队使用的术语分别是什么意思,避免同一个词被理解成不同概念。
- 路由索引: 根据当前任务的特征,找到适用的规则和分析流程,减少仅凭文字相似度选资料。
- 入口检查文件: 先判断当前任务是否属于某类专业分析的适用范围,避免一上来就套错规则。

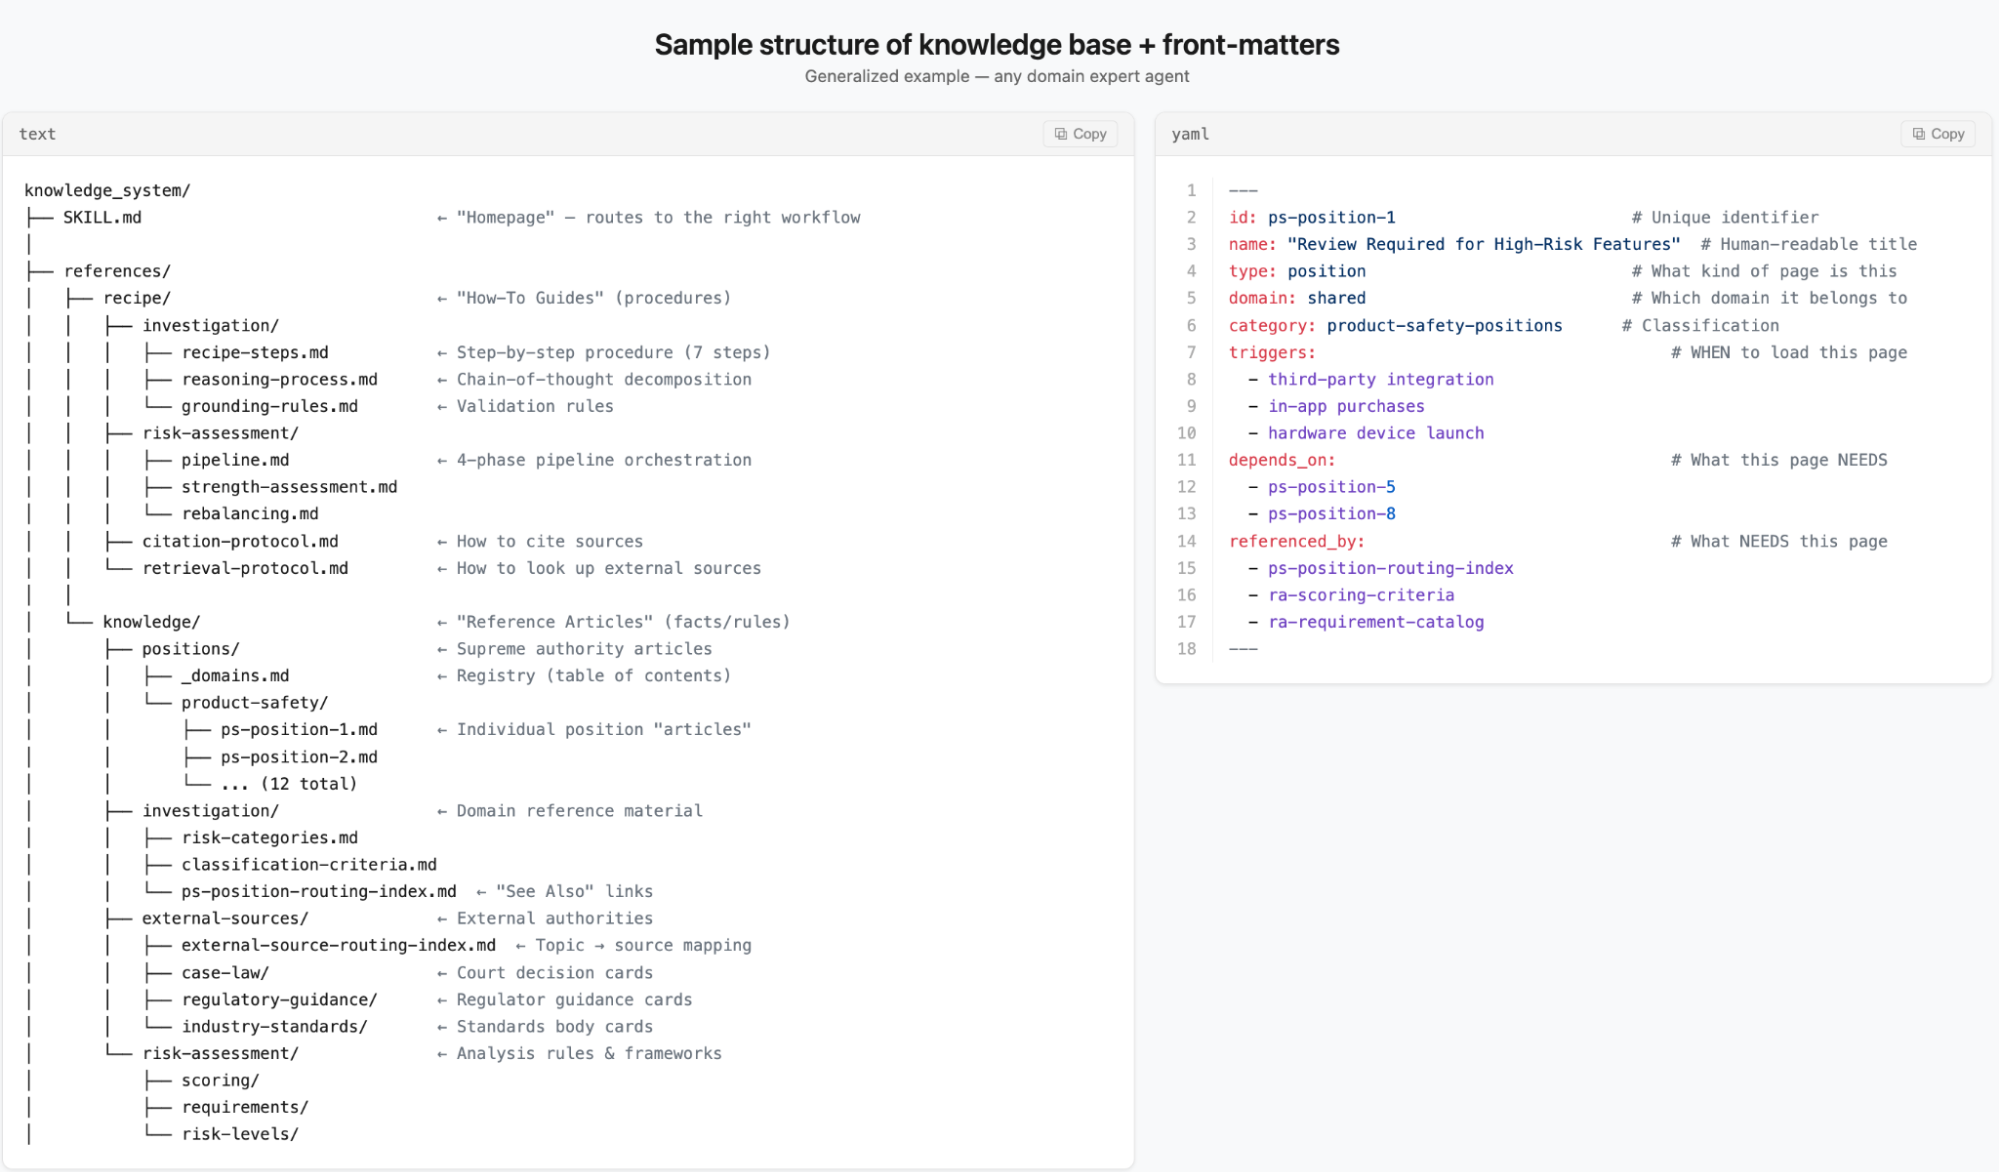
这张泛化示例把分析步骤放在 recipe 目录,把立场和事实放在 knowledge 目录。右侧文件头中的 triggers 标注何时加载,depends_on 标注依赖哪些依据,referenced_by 标注哪些流程或规则会使用它。YAML 是这些结构化字段的书写格式。
入口检查先回答“当前任务是否属于这个分析范围”;路由再回答“进入之后该使用哪些规则”。一段文字很相似,不代表它适用于当前任务;明确的触发条件让选用依据有据可查。
沿用试用例子,一份可用的知识卡可以写成:
组织立场:满足内部测试、模拟数据、可回退,进入常规试用评审。
适用范围:功能试用申请。
排除情形:对外开放、使用真实用户信息,或无法回退。
信息不足:先补齐材料,不猜测条件已经满足。
依据:教学例子中的专家补充说明。
使用者:试用评审流程、材料检查清单。
这些文字是教学知识卡,原图中的目录和字段值也标注为泛化示例。这里要看清的是结构:规则、边界、依据与使用者都能单独检查。
资料也不必全部塞进 Wiki。Meta 按信息密度与使用频率分工。信息密度可以理解为:一段材料里,有多少内容直接帮助作出当前判断。经常使用的提炼规则放在 Wiki,具体产品规格和历史细节按需检索。
一份很长的历史材料也可能同时承担两种用途:从中提炼的通用判断进入核心知识,原始细节继续作为按需查找的证据。常用不等于整份文档都要常驻上下文。
推理层:把专家的分析方法写成步骤
有了正确知识,AI 仍可能用错顺序、漏查条件,或者过早下结论。
因此,Meta 另外建立了称为 Recipes 的分析流程,规定先检查什么、在哪一步加载哪些知识,以及什么才算完成分析。
知识文件告诉 AI“采用什么标准”,流程文件告诉 AI“怎样用这些标准完成这次任务”。 流程引用知识文件,不把领域事实重复写进步骤;知识文件陈述立场,不规定操作程序。
顶层流程根据任务调用不同的子流程,每个子流程负责一个分析阶段。新增组织立场时,主要更新知识和路由;分析方法有问题时,则重点修改流程。
分阶段执行时,每一步只加载当前需要的指令和资料。以教学案例为例,入口阶段先确认是不是试用申请;查标准时拿立场文件;核实条件时再查这次产品的数据范围和回退材料。
- 流程文件 · 怎么做
- 入口检查流程:检查申请类型,决定是否进入试用评审。
- 核心知识 · 用什么标准
- 入口文件 + 分类词汇:界定“试用”在此任务中的含义;暂不加载无关领域立场。
- 按需证据 · 这次的事实
- 申请摘要:本次要评什么。此时不必读取完整产品规格和历史项目记录。
入口检查 → 触发试用路由 → 路由调用适用流程。
这让“改知识”和“改流程”有了不同对象。评审标准变了,更新立场文件;标准已经写清,但助手漏查数据范围,则修改材料核实步骤。两者通过引用连接,减少把同一条标准重复写进多个流程后改漏一处的风险。
人机协同:该让专家介入的地方,明确停下来
Meta 保留了两种人工介入方式,它们贯穿分析过程。
检查点(Checkpoints)设在预定的分析节点。AI 展示中间判断,专家确认后再继续,也可以当场纠正方向。
升级转人工(Escalations)用于无法可靠判断的情况,例如必要信息缺失,或者证据支持多种合理解释。此时由专家决定接下来怎么处理。
专家的介入既帮助完成当前任务,也留下了可供系统改进的反馈。通过观察中间判断和不确定之处,专家还能逐步判断哪些工作可以放心交给系统。
最亮眼的机制:这个“自进化飞轮”是怎么运转的?
系统真正积累经验的地方,是专家纠正之后发生的事情。
一句“这个结论不对”,不能直接变成可靠的知识更新。文件之间存在依赖,一处修改可能影响其他规则。系统必须查清原因,找到修改位置,再验证修改有没有解决问题。
Meta 指出,人工梳理依赖、检查影响并验证修复,可能耗费数周。
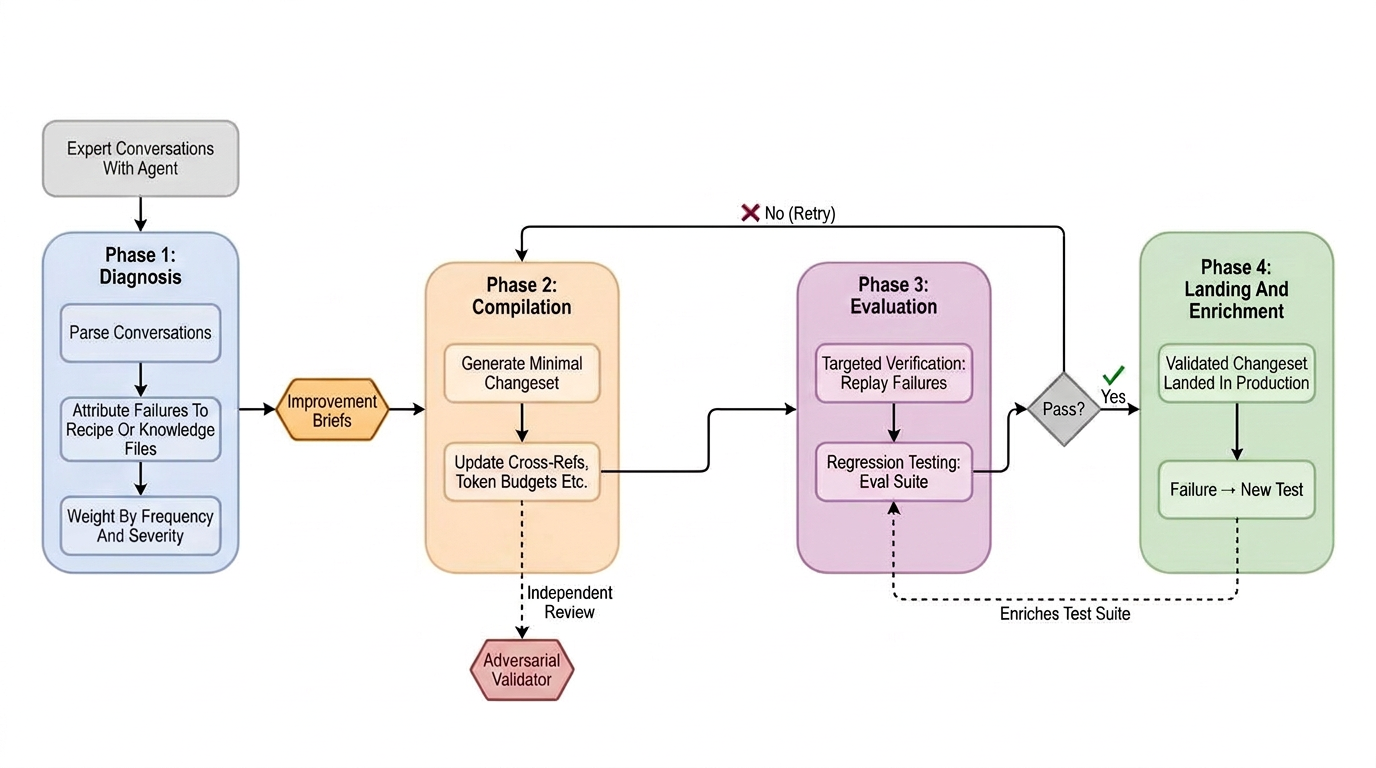
Meta 把这项维护视为“编译”:将自然语言反馈转成精确、可检查的文件修改。整个过程分成四步。

1. 根因归因:到底是缺知识,还是用错了知识?
团队早期尝试按专家说话的形式分类:补充信息就算知识缺口,纠正方向就算流程问题。但同一句纠正可能指向不同根因,这个办法失败了。
后来,系统先从对话中提取专家的实质反馈,再查看 AI 当时实际加载了哪些文件、何时加载、怎样使用,并阅读对应内容。
随后回答一个关键问题:凭当时拿到的材料,AI 本来能不能得出正确结论?
- 资料缺答案补知识
- 资料有答案却出错改流程
- 专家有分歧人工讨论
继续用试用例子:如果实际加载的规则根本没写“仅使用模拟数据”,需要补知识;如果这条条件已经在材料中,AI 却没核实数据类型,就需要改流程;如果专家对真实用户信息的处理方式没有共识,应先交给人讨论。
这里检查的是实际执行时使用的材料。只看整个知识库中“有没有某句话”,不足以解释一次具体失误。
系统还会按问题出现的频率和严重程度加权,帮助确定处理重点。
这一步避免把所有错误都处理成“再加一条规则”。
2. 手术刀式编辑与对抗审查:改动尽量小,影响要查清
确定原因后,系统把问题转成具体文件修改。
多个子代理分别检查:改动是否与旧立场冲突、引用关系是否受到影响、有没有重复内容、是否超出文本预算,以及测试是否覆盖相关情况。
接着,一个处于全新上下文的独立审查代理检查修改差异。它不接收提案者的解释,专门寻找矛盾和被破坏的边界条件。
此外,确定性的检查程序负责发现失效引用、标识符冲突、文件超限和依赖循环等结构错误。
语义上的问题交给独立审查,格式与结构上的问题交给程序检查。
3. 两阶段防退步测试:既要修好这道题,也不能改坏其他题
第一阶段是原案例盲测重放。
系统重新运行触发专家纠正的情境。执行任务的 AI 不知道自己正在接受测试;独立评判者根据原专家反馈评价新输出,同时不知道具体改了什么,以减少围绕修改意图给出有利评价的偏向。
第二阶段是回归测试。
系统运行领域内已有的基准案例,检查此前正常的判断有没有退步。对于可能存在多个合理答案的分析任务,评价依据是判定标准,而非答案措辞是否完全一致。
两种测试解决不同问题:原案例重放检查这次错误是否修复,回归测试检查修改的副作用。任何一阶段失败,都要返回修改环节。回归失败时,系统把退步案例、原问题和已经尝试的修改一起交回,作为返工依据。
4. 资产入库与滚雪球:把一次修复,变成以后持续检查的标准
验证通过后,系统生成一份包含具体差异和审计记录的变更请求(PR),交给专家审阅。
专家批准后,知识或流程才正式更新。同时,最初失败的情境和验证后的正确答案,会自动加入回归测试集。
这样,一次纠正留下两份成果:
- 更新后的知识或流程,供后续任务使用。
- 新增的测试案例,用于检查未来修改是否破坏了这项已确认的行为。
下面把同一个教学案例落到具体修改上。旧流程只核实试用对象和回退方案,漏掉了数据类型;专家纠正后,补丁应该增加数据核实,而不能把所有试用一律升级为专项评审。
修改材料核实流程:增加“核实数据类型;未知则补材料”,继续引用原有试用立场。
原案 · 内部、真实数据、可回退 → 专项人工评审。通过:修复了漏查数据导致的误放行。
回归案 · 内部、模拟数据、可回退 → 常规试用评审。通过:原本正确的路径被保留。
形成待审变更:流程差异 + 检查记录。此时尚未更新正式文件,也没有新增正式回归案例。
“全部转专项评审”的补丁可能修好了这一次误放行,却让本来符合常规条件的任务也被升级。回归案例正是用来发现这种副作用。批准后保存的是更新后的流程和测试;模型权重没有随这次纠正改变,新的任务通过读取这些文件使用经验。
实际落地成效
Meta 报告,经过三个开发迭代、共六周,系统取得了以下结果:
- 单次评估从数天缩短至数分钟。 AI 承担了大部分分析工作,专家把更多精力用于有歧义的判断。
- 输出可用性明显提升。 专家认为结果几乎总是有用,相比早期经常需要大幅返工的状态有所改善。
- 每轮 Token 消耗约降低 80%。 Token 是模型处理文本的计量单位。这项收益来自分阶段按需加载,减少每轮输入的无关材料。
- 知识维护也得到加速。 自动改进流程能产出经过验证的知识修改,这类工作此前需要完整的工程开发迭代。
- 在所述改进周期中未观察到回归。 每次修复还会扩充测试集,为后续更新增加检查依据。
这些是 Meta 对内部特定领域的结果描述。“零回归”对应已经运行的检查,并不保证所有未来任务都不会出错。其他组织仍需要用自己的案例验证效果。
通俗启示:它对企业 AI 落地的参考价值
这套实践给企业提供了一个具体方向:让 AI 学会专业判断,需要同时保存判断依据、执行方法和验收标准。
只有文档,AI 可能不知道怎么使用;只有流程,遇到组织特有的问题仍然缺少依据;只有纠错记录,却没有更新与测试,类似错误仍可能反复出现。
Meta 把这些环节连接起来,让每次反馈都有明确去向:该补哪条知识、该改哪个步骤、怎样证明修改有效,以及由谁批准。
知识与流程保存在人和 AI 都能阅读的文本文件中,每次更新都能比较差异、保留版本,并在需要时回退。复杂的改进过程最终留下的是可以审阅的具体改动。
这种方式尤其值得用于专业经验集中、同类评估需要保持一致、任务量超过专家处理能力,而通用模型分析又达不到要求的工作。合规、财务风险、安全审查和工程标准评估,都可能具备这些条件,具体规则和测试仍需由各领域建立。
采用它需要同时准备有明确边界与关联的知识库、与知识分离的分析流程、持续扩充的评测集,以及与领域风险相称的人工检查点。
组织级第二大脑的价值,就是让专家花时间纠正一次之后,后续任务能够使用这次经验,并持续检查它有没有被正确保留下来。
Meta 的组织级第二大脑
让专家纠正一次,组织以后用得上
资料接进去了,判断仍离不开专家
Meta 在合规等专业领域遇到的问题:AI 能找到文档,却未必会用公司的标准作判断。
四个支柱,把判断变成可维护的系统
标准与步骤分开写;每个阶段只读取当前需要的规则和证据。
先查当时实际加载了什么
凭当时的材料,本来能否得出正确结论?
纠错必须穿过验证与批准
专家在预定检查点确认方向;信息不足或解释有歧义时,升级转人工。
- 小范围修改独立审查矛盾,程序检查引用与结构。
- 两道测试原案盲测重放查修复;回归测试查副作用。
- 专家批准审阅具体差异与审计记录,再正式更新。
- 留下两份资产更新知识或流程;修复原案加入回归集。
专家纠正之后,AI 怎样真正记住?
助手上次允许试用,这次也可以?
历史记录只留下结论,AI 便想照搬到新任务。
专家等等!这次用的是真实用户信息。
以下试用规则均为教学假设,并非 Meta 内部政策。
专家内部测试 + 模拟数据 + 可回退
标签满足才进入常规评审,不等于上线批准。
条件要同时满足;条件未知先补材料,不能猜。
知识知识:采用什么标准
流程流程:按什么步骤核实
查实际加载的材料:没写条件就补知识;写了却漏查就改流程。
助手补上:核实数据类型。
专家有分歧或无法判断,停下来交给人。
此处假设规则已写清,问题是旧流程漏查数据。
原案真实数据 → 专项人工评审
旧案模拟数据等条件满足 → 常规评审
坏补丁全部转专项,会改坏原本正常的案例。
先盲测重放原案,再做回归测试;任一失败,返回修改。
专家批准这份修改。
通过验证的变更交专家审阅;批准后更新文件,原案加入测试集。
助手下一次,我会先查数据。
结语纠正一次 → 留下可复用、可检查的经验。
更新的是知识、流程和测试,模型权重没有随纠错改变。
An Organizational Second Brain: Building an AI That Learns From Experts
- We’ve built an AI agent that acts as a secondary expert for a given domain, making deep specialist knowledge readily available and preserved for anyone in an organization to access, share, and build upon.
- This is not a typical domain-specific agent. Its novelty comes from integrating two layers: A structured, auditable knowledge architecture separates what the agent knows from how it reasons. A self-improvement loop then compiles expert feedback into verified, regression-tested updates without model retraining.
- Together, these two layers turn one-off expert corrections into permanent, compounding institutional memory, and the pattern is designed to generalize to other domains governed by retrievable text rather than model weights.
- This system is saving domain subject matter experts (SME)s at Meta substantial time, allowing them to focus more on the work where their knowledge matters most.
Many large organizations have the same problem when it comes to specialist knowledge. While some of it is written down in the form of models, playbooks, checklists, and frameworks, the most valuable specialist knowledge lives in people’s heads and rarely gets captured anywhere durable. In compliance domains, for example, the same types of questions can arise across hundreds of product reviews, expert assessments take days of manual research, and inconsistency between assessments creates real organizational risk.
It’s not uncommon for experts to spend more time answering routine questions than on genuinely novel and ambiguous work where their judgment matters most. We need systems that can capture how an organization’s experts reason and make that knowledge available to everyone who needs it, so that expertise is easier to share, build on, and preserve. We set about solving this challenge by codifying institutional intelligence into an AI agent for a specific compliance domain. The agent combines a knowledge system that acts as the organization’s “second brain,” a reasoning layer that mirrors how domain experts actually think, and an automated improvement pipeline that compounds expert effort permanently. The patterns generalize to any enterprise domain with deep specialist knowledge, whether that is finance, security, or engineering.
The Architecture at a Glance
Off-the-shelf LLMs provide a strong foundation, but they often need deeper institutional context to be fully effective in specialist domains. Without that grounding, a general purpose model has limited value given it will not be able to distinguish between what an organization could do (a summary of general information) and what it should consider doing (based on historic positions, company direction, business context, etc.). In high-stakes domains, closing this gap requires supplying the model with the organization’s own knowledge and priorities so its analysis reflects how the organization actually reasons.
The system we’ve designed has four layers, each solving a distinct problem:
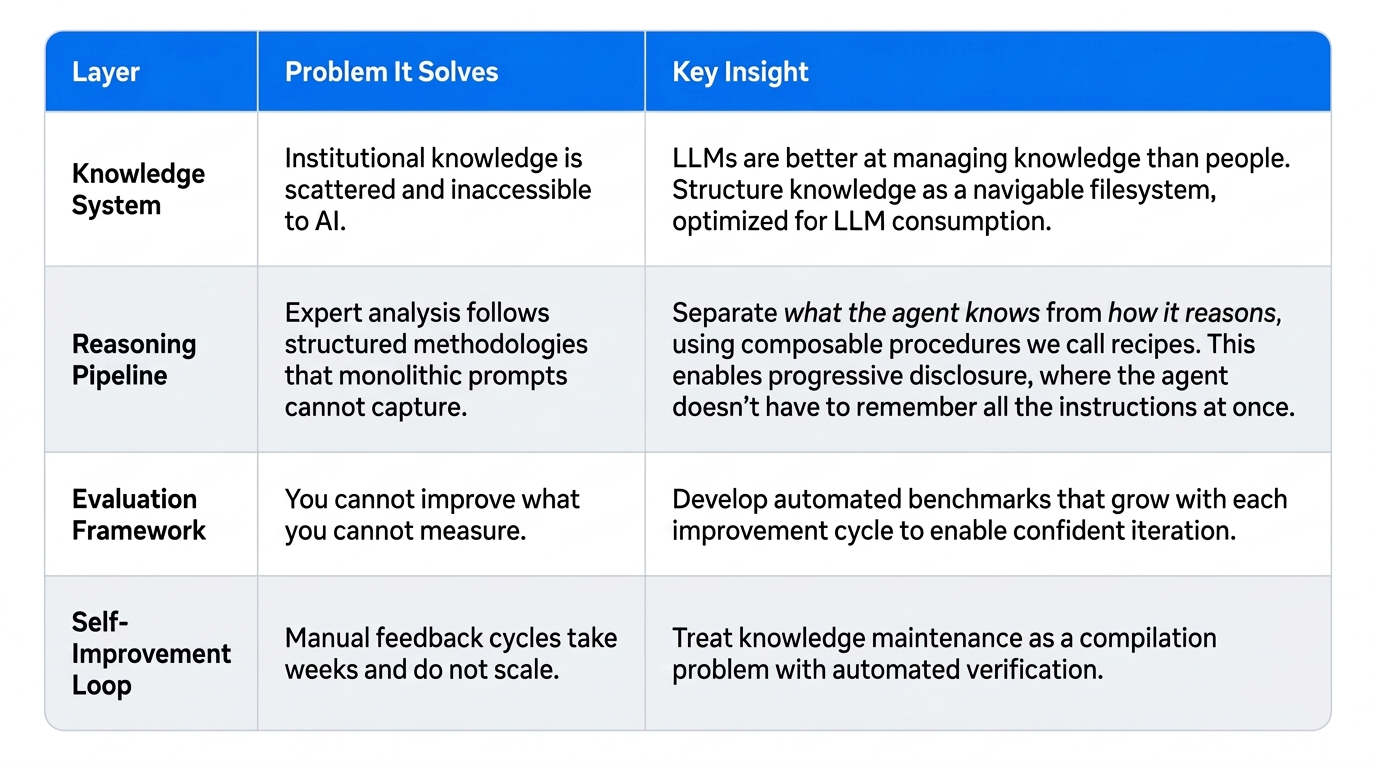
These layers depend on each other. The knowledge system’s file structure makes automated editing possible. The reasoning layer’s explicit procedures make failure attribution tractable. The evaluation framework gates every change. And the improvement loop feeds back into both knowledge and reasoning. Remove any one layer and the others degrade.
Large organizations can accumulate thousands of documents as a byproduct of expert work. It is tempting to treat those documents as organizational knowledge, but the real knowledge is implicit: how experts reason, what they prioritize, and how they resolve ambiguity. An agent that retrieves document chunks at inference time has to re-derive that reasoning from raw sources on every run, which is slow, error-prone, and inconsistent.
We make that implicit knowledge explicit ahead of time. A long-running offline process reasons through source documents and distills them into structured knowledge files – curated statements of how the organization interprets its domain, with constraints, boundaries, and routing implications made machine-readable.
Most significantly, that knowledge then forms the basis of a feedback loop that allows the agent to learn from and implement feedback from human experts without the underlying model having to be retrained.
The industry has converged on a similar idea. Andrej Karpathy’sLLM Wiki structures agent knowledge as a navigable graph of files, and Google’s Open Knowledge Format standardizes this for cross-agent interoperability. The shared insight is that knowledge should be pre-extracted, explicitly structured, and progressively disclosed rather than re-derived on every query. We extended these principles into a system where citation fidelity and institutional consistency are non-negotiable, organizing 200+ files into a strict taxonomy:
- Position files capture authoritative organizational stances: how the organization has decided to interpret a given domain question, along with its constraints, boundary conditions, and machine-actionable routing implications that tell the reasoning layer when to apply it.
- Taxonomy and vocabulary files act as an authoritative glossary for the terms the organization uses to describe its domain, such as entity types, activity categories, and classification tiers. Each is maintained as a single source of truth so the agent and the organization use language consistently.
- Routing indexes map input characteristics to the relevant positions and procedures, determining which files apply without relying on embedding similarity alone. This makes retrieval deterministic and auditable.
- Gateway files define threshold tests the agent must pass before entering an analytical domain, preventing it from applying specialized knowledge where it does not belong.
Every file declares its dependencies (depends_on) and consumers (referenced_by) in YAML frontmatter, forming a bidirectional dependency graph. When one file changes, you can trace exactly what else might be affected, which matters when the self-improvement loop proposes automated edits.
Organizing Knowledge by Density and Usage Frequency
A key architectural decision is how to partition knowledge between the curated wiki and supplementary retrieval (RAG). We split on information density and expected usage frequency.
High-density, frequently referenced sources go into the wiki: Distilled files capturing how the organization reasons, such as positions, decision frameworks, boundary examples, and strategic interpretations. The agent consults these on nearly every turn. Because they encode the organization’s evolving thinking, they need to stay current, and the wiki structure makes them easy to update, version, and validate.
Sparse, situationally relevant sources are served through semantic or lexical search (RAG): documents that matter deeply when they apply but are not needed in detail on most runs, such as detailed reference material, individual product specifications, historical decision records, and niche external knowledge. Loading all of them into the wiki would bloat the system and dilute attention.
The result is that the agent’s core reasoning is always grounded in the most refined, current organizational knowledge, while it can still reach for supporting evidence when a scenario demands it. The combination produces an organizational second brain that encodes how the organization interprets and applies information, rather than only where to find it.
Expert Reasoning via Composable Recipes
Knowledge alone is not enough. Domain experts do not simply recall facts, they follow structured methodologies: a financial analyst works through a valuation model step by step, a security engineer follows a threat modeling procedure. The challenge is capturing those methodologies in a form an LLM can execute reliably.
We solve this with composable procedures we call recipes. Where knowledge files are declarative, recipes are imperative. Each one prescribes a multi-step analytical workflow, specifying what to examine first, which knowledge to load at each step, what decision procedures to follow, and what constitutes a complete analysis.
The critical design choice is separating what the agent knows from how it reasons. Recipes reference knowledge files but contain no domain facts; knowledge files state positions but prescribe no procedures. This means:
- Adding an organizational position means adding a knowledge file and updating a routing index. No recipe changes.
- Fixing a flaw in the agent’s methodology means editing a recipe. No knowledge files change.
- Failures attribute cleanly to one layer. Was the knowledge wrong, or the procedure?
Recipes compose into pipelines, much like a head chef’s master recipe for a dinner service delegates to sub-recipes for each component (the sauce, the protein, the garnish) without containing those details itself. Our top-level routing recipe examines the input and selects which downstream recipes to invoke, each handling one analytical phase.
This is also what enables progressive disclosure. Rather than front-loading a monolithic instruction set covering every possible scenario, each recipe step carries only the instructions and knowledge relevant to that phase. Early versions used a single flat instruction file and loaded all sources via semantic search, pulling a large volume of mixed-relevance files into the context window on every run. After restructuring into recipe-driven stages, each query touches only a small, targeted subset, cutting tokens consumed per turn by around 80%. Context windows are finite and attention degrades with volume, so delivering the right instructions at the right time directly improves reasoning quality.
Keeping Humans in Control
Human experts stay in control of this system throughout. The agent accelerates and structures their work; it does not replace their judgment or their authority over the outcome.
We enforce this through two mechanisms:
Checkpoints are defined points in the analysis where the agent surfaces its intermediate reasoning for expert review before proceeding, and the expert can confirm, correct, or redirect.
Escalations trigger when the agent hits genuine ambiguity, whether from underspecified inputs or evidence that supports more than one defensible reading. Rather than forcing a resolution, it hands the question to the expert, whose choice determines the path the analysis takes.
Checkpoints and escalations serve three purposes simultaneously:
- Quality and direction control: Experts catch errors before they compound downstream, and keep the analysis on the path they consider most relevant.
- Training signal: Every correction and every escalation becomes input for the self-improvement loop.
- Trust calibration: Experts build confidence incrementally by observing the agent’s reasoning rather than just its final output, and by seeing it flag uncertainty instead of masking it.
The more consequential the decision, the more this matters, which is why we recommend keeping a human in the loop by default across domains like compliance, financial risk assessment, security review, and engineering safety.
The Self-Improvement Flywheel
We consider the self-improvement flywheel to be the most distinctive part of this system. While the structured knowledge system and composable recipes produce a system that is legible by humans and agents, testable, and modular, the number of interdependent files make manual maintenance impossible to scale. When domain experts provide feedback to an agent that feedback has to be translated into precise file edits. This process can take weeks because it requires understanding the full dependency graph, verifying nothing else breaks, and validating the fix actually works.
There has been a large body of work – from RAG memory systems to model-weight knowledge editing – devoted to addressing how agents store, retrieve, and update knowledge. But much less attention has gone toward keeping a document-based institutional knowledge base correct as it grows and as expert positions evolve. Agents that auto-draft their own fixes are increasingly common; but we haven’t seen this level of validation rigor applied to a structured knowledge base without model retraining.
We treat that maintenance as a compilation problem and automate it. Every expert correction moves through four phases:
- Diagnose expert feedback into actionable issues with their root cause.
- Compile issues into minimal verified edits.
- Validate that fixes work without regressions.
- Have domain experts review them.
Once the loop completes, the regression test suite is enriched with the issue that was just fixed so that future updates preserve this behavior.
Diagnosis: Attributing Each Correction to a Root Cause
Raw expert feedback comes from conversation traces where domain SMEs interacted with the agent and provided corrections. The diagnosis phase extracts structured signals from these conversations.
Our first approach classified feedback by conversational form. If the expert provided information, it must be a knowledge gap; if they redirected the agent, it must be a procedure problem. This heuristic failed because conversational form is a poor proxy for root cause. An expert correcting a conclusion might be exposing a knowledge gap, a recipe flaw, or a genuine ambiguity.
The working approach separates extraction from classification. First, extract every substantive signal from the expert alongside the agent’s full knowledge manifest (every file loaded, when, and how used). Second, read the actual knowledge files and apply a single attribution test: Could the agent have reached the correct conclusion from its source materials?
- If the materials contained the right answer but the agent still erred: recipe problem.
- If the materials did not contain the right answer: knowledge gap.
- If experts themselves disagree on the right answer: ambiguity, flagged for human discussion.
Compilation: Surgical Multi-Agent Edits
The compiler translates each diagnosed issue into minimal file edits. Sub-agents analyze impact in parallel, examining cross-references, conflicts with existing positions, token budget impact, test coverage, and duplication risk.
Two design choices make this trustworthy:
Independent adversarial review. A separate agent, running in a fresh context with no knowledge of the improvement rationale, receives only the proposed diffs to the knowledge base. Its job is to find problems such as contradictions introduced, edge cases broken, or positions undermined. Because it shares no context with the proposing agents, it cannot inherit their blind spots.
Deterministic structural validation. A linter catches issues programmatically, dangling cross-references, file size budget violations, identifier collisions, and dependency cycles. This layer is not probabilistic. It passes or fails.
Evaluation: Proving the Fix Works
Every proposed change goes through a two-stage validation:
Targeted replay runs the agent on the original scenario that triggered the feedback. The agent does not know it is being tested. A separate judge evaluates the new output against the original expert feedback without knowing what was changed. This deliberately blind design prevents confirmation bias. If targeted replay fails, compilation is retried.
Regression testing runs multiple benchmarks for that domain, which are usually structured test suites of Q&A pairs. For analytical domains whether there might be multiple correct answers, an independent LLM judge gives each test case a pass/fail based on certain criteria. The agent is run in parallel, independent sessions against the benchmark questions, and regressions in performance are detected. If regression testing fails, compilation is retried with an updated prompt describing where the agent regressed, along with the original issue and attempted fix.
Landing and Enrichment: Compounding Returns
The output of the pipeline is a pull request (diff) with a complete audit trail. A human expert reviews a proven fix rather than debugging a raw failure. Once approved and landed (the knowledge file or recipe is updated), the original failing scenario and its validated correct answer are automatically added to the regression test suite. This means every fix permanently raises the bar and future changes to the knowledge system must preserve the behavior that was just corrected.
Results
After three development sprints spanning six weeks, the system achieved:
- Domain SMEs rated agent outputs useful almost all the time, a significant improvement from early versions where outputs frequently required substantial rework.
- Days to minutes reduction in individual assessment time.
- Automated self-improvement producing validated knowledge edits at a rate that previously required full engineering sprints.
- Zero regressions across improvement cycles, with every fix automatically strengthening the regression suite.
- Domain experts consistently reported the agent handles the vast majority of the analytical work, allowing them to focus on the genuinely ambiguous cases that require human judgment.
Applying This Architecture
The specific domain we built this for required synthesizing dozens of sources (both internal positions and external material) into risk-weighted assessments. But the architecture is domain-independent. It applies wherever:
- Specialist knowledge lives as tribal knowledge in experts’ heads.
- Consistency across assessments matters.
- The volume of work exceeds available expert capacity.
- Off-the-shelf LLMs produce inadequate analysis.
Concrete domains where this pattern fits include regulatory compliance, protocol adherence, financial risk assessment, security review, engineering standards compliance, and procurement evaluation. The common thread is that organizations need AI systems with genuine institutional expertise, not just general knowledge.
The requirements for adopting this architecture are:
- A structured knowledge system with explicit file boundaries, cross-references, and a dependency graph (the organizational second brain for the domain).
- A procedural layer that separates domain knowledge from analytical methodology (recipes).
- An automated evaluation suite that grows with each improvement cycle.
- Human-in-the-loop checkpoints calibrated to the domain’s risk tolerance.
The deeper principle is straightforward: keep the complexity in text files that are readable by both humans and agents, rather than fine-tuned model weights. Every improvement is a text edit that a domain expert can review in 30 seconds. Every change is version-controlled, diffable, and reversible. The compilation pipeline is sophisticated, but its outputs are always transparent.
The goal is a system where expert effort compounds permanently. Every expert interaction makes the system better. Every correction persists as a verified improvement. The organization’s collective knowledge stops being trapped in individuals and starts being available, consistently and at scale, to everyone who needs it.
Acknowledgements
The authors would like to express our gratitude to the contributions of the following people, who have played a crucial role in developing this system. In particular, we would like to extend special thanks to (in last name alphabetical order): Cecilia Baek, Philipp Kaufold, Cat Hughes, Suzanne Leijten, Michael Marcusa, Jordi Mola, Timothy Neo, Elliott Prentiss, Laia Reyes, John Ross, Julio Santil, Taylor Wilson Thomas, Mansi Tripathi, Nikhil Shanbhag, Madeleine Vos, and Jackie Zajac.