同一个 AI 模型,换个 Agent 框架,为什么表现差这么多?
把小模型放进 Claude Code、Codex、OpenCode 等真实 Agent 工具里训练,既学习完成任务,也学习少走弯路。
Hugging Face 与 Liquid AI 团队发表了一篇技术指南:《The ultimate guide to multi-harness RL》。
它要解决做 AI Agent(智能体)时的一个现实问题:同一个大模型,放进不同的 Agent 框架(Harness)里,表现可能差很多;针对某个框架训练好之后,换到另一个框架,能力也未必能直接迁移。
指南不仅解释这种差异从何而来,还展示了怎样把 Claude Code、Codex、OpenCode 等现成工具接入强化学习,让模型在多种真实工具中练习完成任务、减少不必要的操作。下面先讲清问题,再拆解训练方法与实验结果。
同一个大模型,换个壳为什么判若两人?
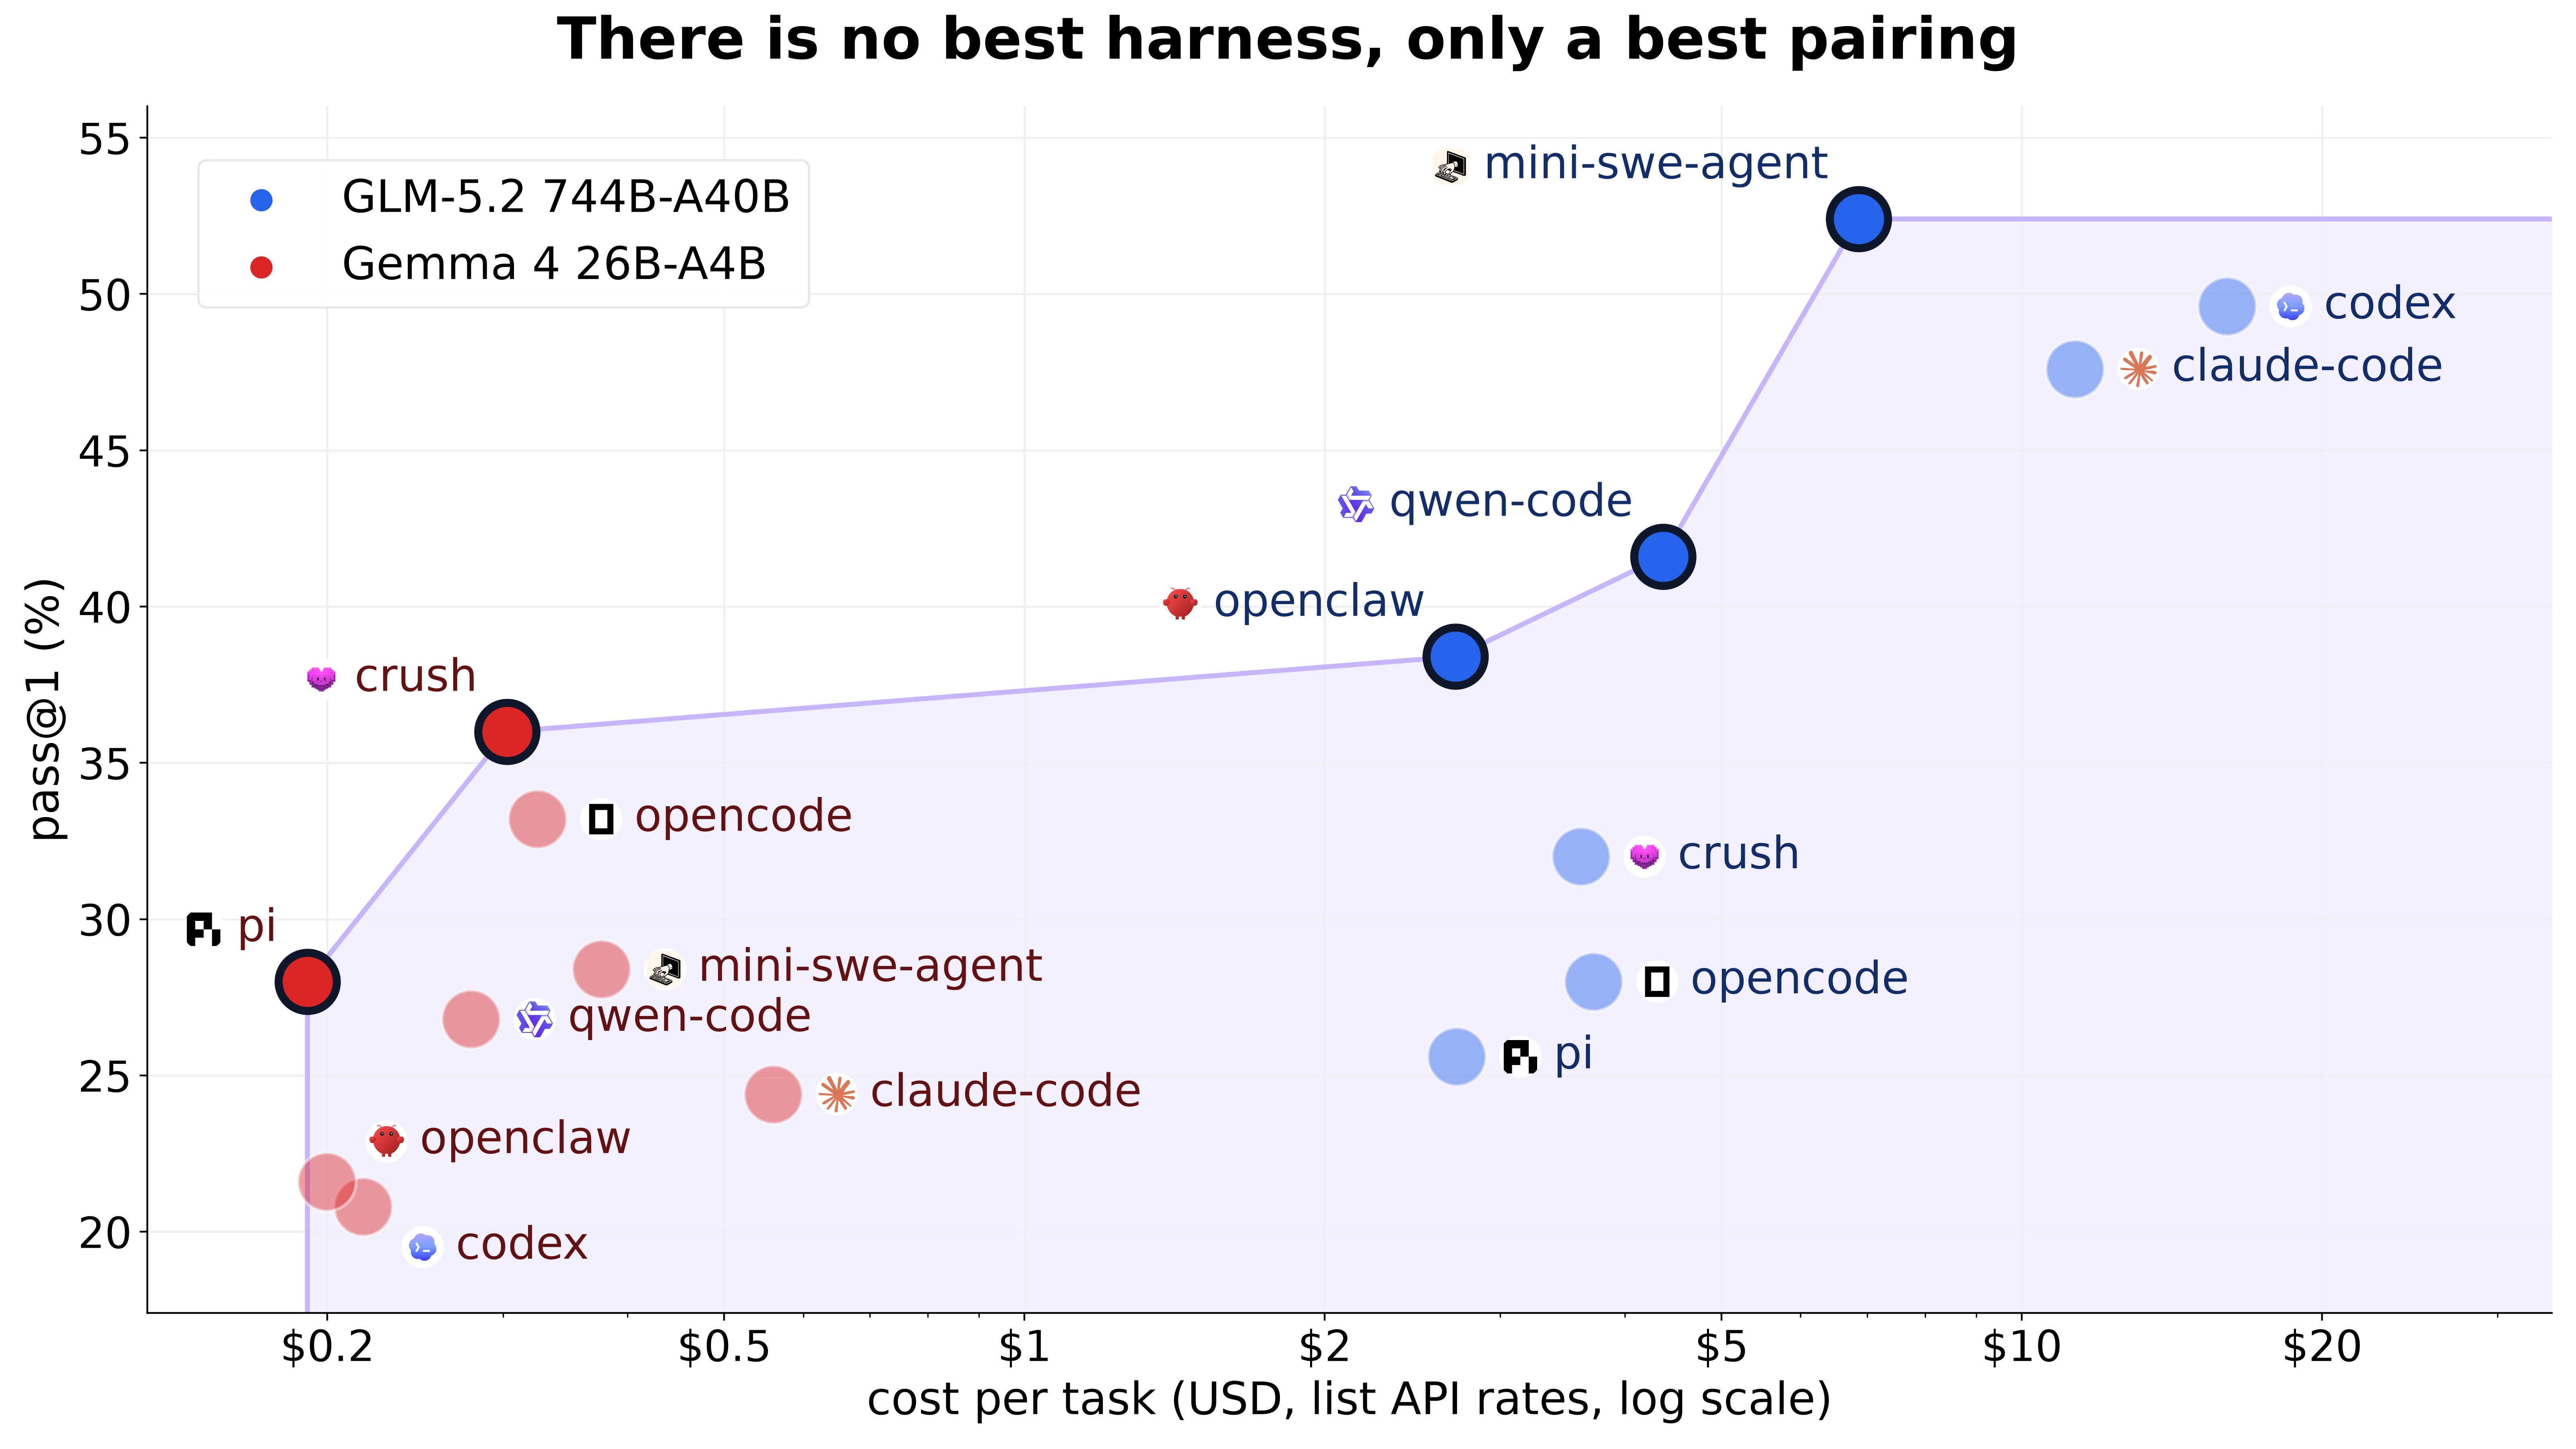
在测试中,研究者 Joel Niklaus 拿同一个 GLM-5.2 模型在 SWE-bench Pro 代码基准上做横向评测:换了外层程序,同一模型的任务解决率就明显改变。 更令人惊讶的是,工具的优劣排名无法在不同模型间直接套用——在十种脚手架中,Codex 是 GLM-5.2 的第二强搭档,但换成 Gemma 4 26B-A4B 时,Codex 却排到了倒数第二(第九名)。

读这张图要分别追踪蓝点与红点:GLM 的最佳搭档是 Mini-SWE-Agent,Gemma 的最佳搭档却是 Crush。向上代表做对更多,向左代表每题成本更低;高成本也不保证更高解决率。因此,所谓“工具最好用”要连同模型一起判断,横轴也不能当作这篇 RL 实验的训练费用。
指南还引用了一项控制变量的评测:同样的 100 道 SWE-bench Verified 题,同样的容器、50 步操作预算与超时,只改变 Harness 配置。最简版没有压缩和重试;改进版精简工具、加入压缩和重试;完整版再加自检、漂移检查与回滚。
| 模型 | 最简版 | 改进版 | 完整版 |
|---|---|---|---|
| GLM-5.1 | 52.5% | 56.5% | 65.5% |
| GPT-5.4 | 55.0% | 58.5% | 63.5% |
| Kimi K2.6 | 52.0% | 59.0% | 60.5% |
三个配置下的第一名分别是 GPT、Kimi、GLM。这个例子把“模型排名也受 Harness 影响”讲得更具体:榜单上更高的模型,放进你自己的执行循环里未必仍更高。数据来自指南引述的 Zhang 等人的 Table 2。
这种包裹在底层大模型外面的程序,在学术界和工业界被称为 Agent Harness(智能体脚手架)。
搞清几个容易混淆的角色
为了讲清楚背后的机制,我们先把几个常见的概念排个序:
- Policy(策略 / 底座模型):纯粹的模型权重。它的输入是提示词,输出是生成的文本或 Token,没有跨调用记忆;模型选择工具与参数,外层程序负责执行。
- Harness(脚手架):模型身外的程序外壳。它负责构建上下文提示词、给模型暴露哪些工具、拦截并执行工具调用、解析模型吐出的参数、处理报错并决定何时重试或结束。
- Agent(智能体):Policy 穿上 Harness 外衣后的整体。用户实际打交道的就是这个跑在循环里的完整程序。
- Sandbox(沙箱):工具真正跑代码的隔离环境,比如 Docker 容器、轻量虚拟机或远程 Linux 会话。
- Benchmark(基准测试):一套固定的测试题库加上打分判定规则。
模型提出工具调用或结束回答,Harness 实际执行操作、组织下一轮上下文,并按自身规则重试或停止。换了脚手架,模型读到的信息与可调用的工具就变了。
还要区分 RL 环境与 Harness:环境保存任务状态,接收动作、改变状态、返回观察,并在满足条件时给出奖励;Harness 负责让模型持续与它交互。比如文件与计算结果属于环境中的状态,何时读文件、何时再问模型、何时停下来则由 Harness 的循环安排。
为什么只练一种工具容易偏科?
自己部署开源模型时,仅有权重并不保证它能适应所选工具的接口:
快手 KwaiKAT 团队在 KAT-Coder 研究中指出,如果智能体强化学习只在一个固定的脚手架里训,模型学到的往往不是“怎么解决问题”,而是“如何迎合这个脚手架的特定规矩”。他们总结了三种过拟合:
- 动作格式过拟合(Format):工具调用的接口方言(API Dialect)千差万别。有的用标准 OpenAI 格式,有的用 Anthropic 结构,还有的像 Aider 直接要求模型在普通文本里输出特定的代码编辑块。更关键的是工具名:A 叫
bash,B 叫terminal,C 叫execute_command;一旦模型把 A 的参数名字背熟了,到 B 里就会因为参数不合规被系统直接拒绝。 - 上下文结构过拟合(Context):脚手架怎么压缩历史记录?是用 Markdown 拼装上下文,还是维护结构化消息列表?模型习惯了某种排版后,换一种格式就可能抓瞎。
- 控制流过拟合(Control Flow):有的脚手架提供较多自动容错,自动帮你做语法修复、提供重试保护;有的脚手架则很严苛,错一次直接退出。依赖这些容错机制的模型,一旦离开熟悉的环境可能难以继续。
Orchard 论文曾记录过一次“明显退步”:把在 OpenHands 环境里精调出来的 OpenSWE-32B 拿去另一个极简工具 Mini-SWE-Agent 里跑,解决率掉了 7.5 个百分点;放到没见过的 Kimi-CLI 里跑,在 SWE-bench Verified 上的得分直接从 60% 级断崖式下跌到 3.6%,在 Terminal-Bench 2.0 上得分为零。同一论文还观察到另一个系统 Scale-SWE 离开原生工具后无法产生有效工具调用。解决率下降与格式失效是两种不同问题。
指南梳理的 Poolside Laguna、Kimi K3、Qwen 与小米 MiMo 等工作,都在增加训练接触的 Harness 种类。但它们做法不同:Poolside 在监督训练中混入外部工具轨迹,后续 RL 只用生产工具 pool;Kimi 通过模块组合形成不同执行配置;Qwen3-Coder-Next 在六种工具里生成编码数据。所谓“多工具训练”,还需要看它发生在收集数据、监督微调还是强化学习阶段。但摆在所有开源开发者面前的难题是:市面上的成熟工具都是别人写好的独立程序,根本不是为了训练而设计的,我们怎么把强化学习接进去?
驯服“黑盒脚手架”的底层技术坎:为什么不能只看最终文本?
在传统强化学习里,环境通常是一个标准函数库(比如经典的 Gymnasium 接口)。微软 Agent Lightning 团队形象地将这种差别划分为白盒环境与黑盒环境:
- 白盒环境(训练器主控循环):训练引擎自己说了算。它每吐一个 Token、每调用一次环境的
env.step(),都在训练器的完全掌控下。TRL 这类训练框架原本也是这么预设的。 - 黑盒环境(脚手架主控循环):像 Claude Code 或 Codex 这种真实工具,一旦启动就在沙箱里跑自己的逻辑:自己压缩上下文、自己静默重试、自己修补格式残缺的 JSON。训练器在外面根本插不上手,只能眼睁睁看着它向模型接口发来一串串 HTTP 请求。
这里的白盒、黑盒按“谁负责交互循环”区分。其他报告有时用它们区分是否压缩历史,含义不同;一个内部循环很简单的 Harness,也可以由它自己主控任务。
面对这种黑盒脚手架,一个直观想法是:等工具跑完,把屏幕上打印的完整对话文本存下来,拿去给模型算奖励不就行了?
答案是:对这套需要精确采样记录的策略梯度训练而言,文本与最终分数不足以可靠重建生成时发生的事。
关键的 Token 漂移与对数概率缺失
强化学习里的策略梯度算法(如 PPO、GRPO)要算出正确的参数更新方向,必须精准依赖两样东西:
- 生成时到底采样了哪些具体的 Token ID?
- 模型当时以多大的概率生成了它们?Logprob 是这一概率的对数。
如果只存文本,事后再用分词器重新编码(Re-tokenize),会引发一系列关键漏洞:
- 分词不唯一(Token Drift):同一串英文字符和空格,在不同的上下文边界下重新分词,切出来的 Token ID 可能完全不同。训练器可能对不是模型实际采样的 token 计算更新。
- 脚手架“善意修补”的污染:很多脚手架为了提高容错率,在把历史送进下一步之前,会自作主张清理空格、修复漏掉的括号、甚至补齐错误的 JSON 字段。如果你拿最终文本去算损失,相当于在强行让模型为“它自己根本没生成过的正确答案”承担责任。
- 异步训练下的比率失效:在大规模强化学习中,生成轨迹和反向传播是异步并行的。当训练器准备更新参数时,手头的模型权重已经比生成这条轨迹时更新了几个步长。我们必须拿“现在的概率”去除以“生成当时的真实概率”(重要性采样)。如果不记录生成当时的对数概率,强行用当前权重去重算,新旧概率比值就会变成失去区分作用的 1,它就失去了修正新旧策略差异所需的信息。
这项工作选择保留推理引擎返回的原始 Token ID 与生成时的 Logprob,避免从文本猜回去。原文也介绍了通过请求响应重建样本的 OpenForgeRL,它同样报告了有效结果;精确记录是本文采用的路线,并不等于其他方法已被证明无法训练。
看起来一样的文字,token 边界却变了
原文的边界示意:每个格子是一个 token。从第三格起,两条序列不再一致。
上排把模型采样的两个 token 与模板后缀分别保留;下排把换行与特殊标记合并成了别的 token。文本相同,不代表生成时的 token ID 相同。示意展示分词边界,不列具体词表 ID。
根据原文 Figure 7 的 token drift 图本地化。
三件套破局方案:OpenEnv 抓包代理、Harbor 任务沙箱与 TRL
为了打通“未经修改的现成工具”与“严格的强化学习训练”,本研究组合了一套开源三件套架构:
OpenEnv 提供环境、Harness 与训练器共同使用的接口和服务,采集代理是它的一个部件。奖励来自任务验证器,参数更新由 TRL 执行;把通信接起来,本身并不会教会模型完成任务。
一次任务中,Harbor 在隔离沙箱里启动真实 Harness。每次模型请求先经过 OpenEnv 采集代理,再送到 vLLM 或 SGLang。代理保留生成记录,把回复转回 Harness 所需格式。结束后,训练器取得代理导出的轨迹和 Harbor 给出的评分,再由 TRL 更新权重。
这条路径能保留现成工具,是因为所有 Harness 都必须调用模型接口。每次 rollout 获得独立的采集会话,Harness 使用代理的 base URL,并把会话 ID 当作 API key。代理据此将并发请求归入各自任务,工具仍按自己的规则执行、重试和整理上下文。
工具照常干活,训练器从旁记录
架构示意:上方是一次模型调用,下方是训练所需的两路数据。
同一训练器可接不同 Harness;每个八次尝试的组使用同一种 Harness,组与组之间切换。
抓包代理(Capture Proxy)的巧妙设计
抓包代理是整个架构的关键部分,它充当一个兼容多协议的模型网关:
- 多方言动态翻译:现成脚手架各说各的语言——有的发 Anthropic Messages,有的发 OpenAI Chat Completions,有的发 Gemini 格式,还有 OpenAI Responses。代理通过请求路径、Header 和 Body 自动识别,利用集成自 NVIDIA Polar 网关的转换器,把它们全部归一化为标准的补全请求。无论前端工具怎么折腾,送往底层推理引擎的永远是统一格式。
- 整包拦截与假流式回放:工具如果要求流式输出(Streaming),代理并不会真去推理引擎那里分块抓取残缺的 Delta 包,而是等引擎把完整回复一口气吐完、妥善记录下全部 Token ID 和原始对数概率后,再由代理充当打字机流式推送给脚手架。Harness 仍收到所需协议格式,不过等待第一个 token 的时间会变长。
- 消除采样偏差:代理强制推理引擎在
top_p=1.0(全分布)下采样,并启用processed_logprobs。如果在推理时截断低概率词,会导致模型生成的分布被外力扭曲,进而引发强化学习中的“熵崩溃”。实验证明,把top_p设为 1.0 后,重要性采样比率从有偏的 0.985~0.993 接近 1,达到 0.9984~0.9999。 - 把网状调用梳理成“训练树”:真实的编码任务绝非一问一答,工具会重试报错、会召唤子智能体、会在超出限制后压缩历史。代理通过寻找最大 Token 公共前缀,把每一次模型调用连成有分支的图:
- 失败后放弃的重试,是树上没有后继的分支;
- 子智能体有独立的系统提示词,自动开辟为一棵新树的根节点;
- 最终从根节点到叶子节点的每一条连通路径,被干净地导成一条训练序列,给工具自己输入的上下文打上 Mask=0(不计算损失),只对模型自主生成的步骤打上 Mask=1(计算梯度)。
Harbor 与 TRL 的衔接
- Harbor 的任务沙箱调度:Harbor 原生支持 40 多种主流脚手架和 26 种沙箱执行后端(如 E2B、Daytona、本地 Docker 等)。每个任务目录提供指令、运行环境配置和验证脚本,实际使用哪种 Harness 与沙箱后端在运行时选择。在训练时,每次 Rollout 只需要单条指令指定“跑什么任务、用什么工具、在什么沙箱跑”,实现了任务与工具的解耦。
- 与官方轨迹(ATIF)双重核验:为了防止通信异常导致的漏训,系统会将抓包代理记录的 Token 序列与 Harbor 自带的 ATIF 轨迹文件逐步对账(核对每步的 Token 长度与步数)。之前团队就曾抓到过某工具发送空工具数组触发 400 报错、导致轨迹中途悄悄被掐断的问题。
- TRL 异步 GRPO 训练:利用 TRL 的
AsyncGRPOTrainer,生成轨迹和训练反向传播完全异步解耦。两张 H100 显卡分工明确:一张卡跑 vLLM 专职推理生轨迹,另一张卡吃进训练序列专心算梯度,生成与训练并行,减少等待最慢 Agent 的时间。轨迹通常来自两步之前、最多四步之前的权重,因此生成时的概率必须保留。
环境服务器与训练器之间还隔着 HTTP 边界。早期把 Harness 放进训练进程,异常可能令一个进程崩溃,其他进程一直等它同步。现在失败返回 ok=False、reward=None,由训练器处理失败状态;验证器没有运行,不会被误当成“答案错了,奖励 0”。
代理会探测推理后端能力:能回答不等于能提供训练数据。若托管接口不返回精确 token 与对应概率,仍可评测工具,却不能用于这条训练路线。缺失或不对齐概率的调用只留作上下文,不当作训练目标;历史压缩也可能产生新的调用图根节点。
小模型放进四种工具里练,究竟改善了什么?
团队把 Liquid AI 的 LFM2.5-2.6B(26 亿参数)作为起点,在从 Kaggle notebooks 构建的 SmolDataEnvs 数据分析题上训练。题目要求模型查数据、执行计算、读取结果并提交可验证答案。一个从开始到结束的尝试叫 rollout,包含多轮工具操作,而非一句回答。
原文展示的一道中等难度题是:“全部足球比赛中,平局占多少百分比?”沙箱提供 database.sqlite,题面要求先查看数据,再计算,把单一数值写入 /workdir/answer.txt,然后停止。预设参考答案是 25.4%,通过任务配置交给验证器;模型要从输入数据算出来并提交文件。这样,测试的不只是能否说出一个数字,还包括能否读对数据、调用工具、遵守提交格式,并让验证器取得答案。
训练池选择 1,000 题,400 个中等难度、600 个高难度。两组按同一任务顺序各训练 1,000 步:一组只用 OpenCode;另一组在 OpenCode、Claude Code、Codex、Mini-SWE-Agent 之间切换。同一道题的八条 GRPO 尝试都使用同一种工具,组与组之间再切换,避免把工具本身的差异当成动作优劣。
评测使用留出的 250 题,与训练数据在 notebook、问题和指令上不重叠。每题在四种工具下各尝试一次,共 1,000 个评测单元。Pass@1 表示第一次可评分尝试是否答对;这些是数据分析任务的结果,不能直接当作修复真实代码仓库的成功率。
答对才有效率奖金,答错不能靠少操作拿分
早期 Qwen 实验只奖励正确与否,一些过程变得越来越长。LFM 因此加入小额效率奖励:答错为 0;答对为 1 + 1.5 ÷(15 + 工具调用次数)。效率加分最多 0.1,调用越多,加分越少。
GRPO(群组相对策略优化)比较同题八次尝试的奖励,用它们相对组平均值的高低来产生学习信号。若八次全对,单纯 0/1 奖励使八次都是 1 分,没有奖励差异。效率奖金使较短的正确过程得到更高分,较长的正确过程得到较低分。若答错,哪怕只调用三次,仍是 0 分。
在贡献给保留训练更新的组中,OpenCode-only 有 97/555 组(17.5%)、多工具有 155/686 组(22.6%),可评分尝试全部正确但调用次数不同;奖金是这些组唯一的奖励差异来源。这里统计的是组,并非优化步数。
八次尝试全做对,模型还能学什么?
原实验中的真实一组:Claude Code,第 80 步,同一个难题。只看答对与否,八次都是 1 分;加入效率奖励,调用更少的尝试得到更高分。
八次全部答对,奖励相同,组内没有可用的奖励差异。
| 尝试 | 结果 | 工具调用 | 奖励 | 相对组均值 |
|---|---|---|---|---|
| 1 | 正确 | 10 | 1.0000 | 0.0000 |
| 2 | 正确 | 4 | 1.0000 | 0.0000 |
| 3 | 正确 | 6 | 1.0000 | 0.0000 |
| 4 | 正确 | 4 | 1.0000 | 0.0000 |
| 5 | 正确 | 9 | 1.0000 | 0.0000 |
| 6 | 正确 | 8 | 1.0000 | 0.0000 |
| 7 | 正确 | 5 | 1.0000 | 0.0000 |
| 8 | 正确 | 9 | 1.0000 | 0.0000 |
原实验公式:正确时奖励 = 1 + 1.5 ÷(15 + 调用次数);错误时为 0。这里展示奖励减去组均值的差,方便看方向;实际 GRPO 还会按组内标准差归一化。无脚本时保留上方默认对照。
先看每种工具,再看总体平均
最终第 1,000 步的结果如下。基线有 998/1,000 个单元完成评分,最终两组均有 1,000 个。
| 工具 | 基础模型 | 仅 OpenCode 训练 | 四工具训练 |
|---|---|---|---|
| OpenCode | 33.6% | 58.0% | 49.6% |
| Claude Code | 33.2% | 42.0% | 48.8% |
| Codex | 40.0% | 43.2% | 53.6% |
| Mini-SWE-Agent | 62.1% | 66.0% | 64.8% |
| 总体 | 42.2% | 52.3% | 54.2% |
同一基础模型,在 Mini-SWE-Agent 中能做对约六成,在 Claude Code 中只有约三成。这就是模型与工具搭配的影响。训练只用 OpenCode,最大增益也落在 OpenCode;训练四种工具,则四种接口下都超过基础模型,Claude Code 与 Codex 下还优于单工具训练结果。
但总体 54.2% 与 52.3% 只差 1.9 个百分点,原文判断差距在噪声范围内,不能凭此宣称多工具训练总体正确率显著更好。Mini-SWE-Agent 的 64.8% 与 66.0% 接近,也不是精确相等。多工具组测试的是已参与训练的四种接口下的新任务,尚未检验完全未见过的 Harness。
曲线补上了终点表格看不到的信息:两组主要在前 200 步涨分,随后虽有波动,提升总体保持到第 1,000 步。每个检查点在每题每工具下只跑一次,一两个百分点的起伏不能直接当成能力变化;这里更有意义的是整段走势。

调用次数还出现了一个看似矛盾的现象:多工具组在训练时平均调用更多,评测时却在四种工具下都比单工具组调用更少。训练平均混入了 Claude Code、Codex、Mini-SWE-Agent,它们原本就比 OpenCode 调用更多;评测时两模型都跑相同四种工具,才能在同一接口下比较。训练平均反映的是不同工具组合,不能单独用来判定谁更省操作。
做对的题更省操作,但“省 31%”有明确分母
只比较基础模型与训练后模型都答对的同一任务与工具配对,多工具训练最终减少约 31% 的工具调用,单工具约 11%。多工具在 OpenCode 下减少 32.8%、Claude Code 下减少 28.3%、Codex 下减少 53.0%、Mini-SWE-Agent 下减少 16.2%。
减少调用也减少每轮反复发送的历史,输入 token 随之下降。这里的 31% 是匹配任务上调用总量的相对减少,不是全体任务平均值,也不是账单或耗时节省比例。单工具训练在 Claude Code 下的正确率上升了,但最终调用和输入 token 反而更多;第 500 步的输出 token 曾多约 62%。准确率与执行效率要分别看。

| 工具 | 单工具组匹配题数 | 多工具组匹配题数 | 多工具组输出 token 节省 | 多工具组输入 token 节省 |
|---|---|---|---|---|
| OpenCode | 74 | 66 | 37.9% | 27.2% |
| Claude Code | 55 | 69 | 16.8% | 24.8% |
| Codex | 71 | 89 | 39.7% | 45.9% |
| Mini-SWE-Agent | 137 | 132 | 16.6% | 11.2% |
调用、输出与输入是三种不同工作量。以 Codex 为例,调用减少 53.0%,输出 token 减少 39.7%,输入 token 减少 45.9%,所以“少调用一半”不能直接替换为“所有计算都少一半”。
LFM 没有去掉效率奖励的对照,无法把全部节省单独归因于奖金。两组的训练曝光也不相等:单工具与多工具实际见到 555、626 个不同任务,监督 token 为 12.5M、18.7M,处理 token 为 162M、451M。Claude Code 会重写历史,每条轨迹平均生成约八条训练行,其他工具约一条。每种设置只有一个随机种子,这是观察性比较。
模仿大模型成功的过程,这次得到了什么?
团队还用 Qwen3.8-27B 做教师:每题每种工具最多尝试三次,保留第一个被验证器判定正确的过程,得到来自 888 题的 3,189 条成功轨迹。SFT(监督微调)把此前对话和工具输出作为上下文,学习教师的下一条响应;RL 则从小模型自身尝试的奖励学习。
单工具 SFT 使用 801 条 OpenCode 轨迹,多工具 SFT 混合全部轨迹,没有按工具平衡。两者都训练两轮。
一条成功轨迹也不是一个训练样本:每个 assistant 回合都展开成“此前上下文 → 下一次响应”,只训练这次响应。原文使用学生 LFM 自己的聊天模板分词。这与前面的 RL 记录要求并不冲突:SFT 学教师答案在学生模型下的概率;本文的 RL 则要对齐学生当时真正采样的 token 与生成概率,才能比较新旧策略。
| 训练方式 | 综合 Pass@1 | 双方答对任务的调用节省 |
|---|---|---|
| 基础模型 | 42.2% | 基准 |
| 单工具 SFT,两轮后 | 47.5% | 8.5% |
| 多工具 SFT,两轮后 | 43.1% | 24.2% |
| 单工具 RL,第 900 步 | 52.4% | 13.2% |
| 多工具 RL,第 700 步 | 54.6% | 26.7% |
多工具 SFT 改善了 Claude Code(33.2% → 42.4%)、Codex(40.0% → 46.8%)和 OpenCode(33.6% → 38.0%),却让 Mini-SWE-Agent 从 62.1% 降到 45.2%。这抵消了其他工具的收益,使总体 43.1% 与基础模型 42.2% 接近。单工具 SFT 主要改善 OpenCode:33.6% → 51.6%;Claude Code 保持 33.2%,Mini-SWE-Agent 降到 58.8%。团队尚未解释为什么 SFT 损伤了 Mini-SWE-Agent。

本次 RL 的正确率更高,却不能由此归结为“SFT 只会背答案,RL 才会纠错”。两者的目标、数据来源、任务池与算力不同,每种设置只跑一次;多工具 SFT 的监督 token 约为单工具的七倍。表中 SFT 是两轮后的结果,RL 使用测试集上挑出的最佳检查点,会略偏向 RL;这些 RL 检查点与最终第 1,000 步总体成绩都相差不到半个百分点。
另一个观察是,SFT 没有工具效率奖励,多工具 SFT 仍减少 24.2% 的调用,且四种接口下都减少。效率改善可以出现在不同训练路线中,不能仅凭调用下降反推某项奖励必然是原因。
团队计划的后续对照也针对这些混杂因素:比较“先 SFT 再 RL”与“从基础模型直接 RL”,检验模仿得到的起点是否有帮助;在教师四种工具都解出的 692 题上比较不同混合,减少任务选择差异;再让各工具的监督 token 数相等,减少样本量差异。这些尚待开展的实验,才能更清楚地回答收益来自哪些变化。
Qwen 为什么先涨分,后来又掉下去?
早期 Qwen3.5-2B 使用较容易的 1,000 题池,奖励只有正确与否。多工具组从 14.6% 升到第 500 步的 37.0%,OpenCode-only 在第 700 步达到 39.5%,但两组到第 1,000 步都回落到约 26%。另一组独立 OpenCode 环境实验走势不同,缓慢上升,到第 1,000 步达到最佳 29.8%。

轨迹暴露出不同问题:
- 多工具组训练允许最多 16,384 个输出 token,评测只允许 4,096。后期回答越来越长,常在该计算时输出长篇解释,触及上限的评测单元从 9 个增到 556 个。训练养成的输出习惯,被评测预算截断;放宽后能否答对这些题,没有在这组结果中得到验证。
- OpenCode-only 继续操作却不提交。训练时调用约从 10 次升到 20 次;评测中从 17 次升到 21 次。有提交记录的单元中,交出答案的比例从 69% 降到 41%。
- 多工具组第 684 步重启后,几乎都取到已见过的旧题,改变了后期接触的数据。但下降从第 500 步已开始,不能由重启 Bug 解释起点。
还有两项容易被“轮流训练”掩盖的现象:35%—58% 的优化步里,各组都没有奖励差异;四种工具各占约四分之一的轨迹,Claude Code 却贡献 77% 的训练行、35% 的监督 token。均分轨迹并不等于均分实际训练量。换一批更难的新题续训,也没有恢复多工具组的峰值。
后续 LFM 同时调整三件事:加入效率奖金,任务池改为中等与困难题,并把训练和评测输出上限都设为 4,096。LFM 的提升保持到第 1,000 步,但三项同时改变,不能分离各自的贡献。训练预算、评测预算、是否提交和组内奖励差异,都要一起检查,单看训练奖励上升不够。
开发者可以从中带走什么?
首先,Agent 表现由模型与运行程序共同决定。选型时应在自己的工具、任务、上下文管理与预算下评测,而不是只看脱离 Harness 的模型排名。更换模型或工具,都可能改变整个系统的表现。
其次,这项工作提供了一条开放的工程路径:保持真实 Harness 的工具与循环,通过模型接口收集训练需要的证据,让同一训练器接入不同工具。它支持使用相应模型 API 的程序,仍需兼容推理后端、适配配置和可验证任务;并非给任意程序加一层代理就自动具备训练能力。
奖励也必须对应真正目标。原文记录过一次“提交任何东西就加 0.2 分”的尝试:模型学会立即提交,训练奖励看起来正常,留出任务正确率却从 74.0% 降到 17.8%。正确性与效率的关系要写进目标,不能让省步骤、提前提交替代完成任务。
这次 LFM 实验每组使用两张 H100,单工具约 32 小时、多工具约 46 小时,不含评测、排队与重启;完整费用没有统计。小模型原型证明了一类数据分析任务上的可行性,还没有建立所有模型、任务与工具混合方式的一般排名。
复现入口:先确认能采到训练数据
原文的入口是 OpenEnv 的四个命令:info 检查后端、任务与工具能力,rollout 先独立跑任务,serve 提供环境服务,push 部署同一服务。先让单次任务与记录核对通过,再接训练器,能把工具执行问题和服务层问题分开定位。
依赖包括 Python 3.12、OpenEnv 的 Harbor 扩展与 typed TrainingTrace API,以及 TRL 的 HarnessRolloutWorker。原文发布时,TRL 该 worker 在主分支的实验模块中,尚未进入当时正式版;复现应按配套示例核对依赖。
vLLM 需启用 --return-tokens-as-token-ids 与 --logprobs-mode processed_logprobs。原文称 SGLang 非流式 token 返回从 v0.5.17 起支持,但团队实际只测试 main 构建;这些 vLLM 参数不能照搬给 SGLang。仅完成普通聊天调用,不能证明 token 与概率已完整采集。
还要让服务容量容纳一整组尝试:原文环境服务的 max_concurrent_envs 默认是 4,而一组 GRPO 有 8 条 rollout,超出限制会返回 CAPACITY_REACHED,训练前需按实际并发配置。采集代理本身是单进程,团队曾观察到约 200 个并发会话时健康检查受压、320 个时崩溃;这是该次运行的观测,扩容前仍要测自己的负载。
完整 SmolDataEnvs 训练集约 5,000 题,本实验选择其中 1,000 题。历史实验沙箱使用 E2B,当前教程使用 Daytona,并包含独立 OpenCode 环境比较,所以当前教程不是历史实验的精确重放。
模型与数据合集集中提供实验产物;LFM 多工具 RL 模型默认对应第 1,000 步,step-700 分支是最佳测试检查点;训练比较面板可查看原始曲线;SFT 数据集提供按工具拆分与预分词配置。新运行应使用 Harbor 的 OpenCode 适配,原文保留的独立 opencode_env 已标为历史比较入口。
import Image from "../../components/Image.astro"; import joelPlot from "../assets/image/joel-harness-pairing.png";
Introduction
If you use AI to write code, you have probably used the same model through more than one tool: Claude models in Claude Code, Cursor, Pi, or Cline. And you may have noticed it doesn't behave the same way in each. It plans differently, reaches for different tools, and finishes tasks in one that it gets stuck on in another.
The difference can be measured, and it comes from the program wrapped around the model, called an agent harness. It runs the loop, decides which tools the model gets, writes the context the model reads, makes sense of what the model sends back, and decides when to stop. Change the harness, and you change what the model sees and what it is allowed to do, so the results change too. On SWE-bench Pro, Joel Niklaus measured the same model, GLM-5.2, at 23% in one harness and 52% in another. The ranking doesn't carry over between models either: Codex was the second-best of ten harnesses for GLM-5.2 and the ninth for Gemma 4 26B-A4B.
<Image src={joelPlot} width={2200} format="webp" quality={90} data-zoom-src={joelPlot.src} alt="Pass@1 against cost per task on SWE-bench Pro for GLM-5.2 and Gemma 4 26B-A4B, each run under several coding-agent harnesses. The harnesses that do best differ between the two models." caption="Pass@1 against cost per task for two models across coding-agent harnesses on SWE-bench Pro. Plot by <a href='https://x.com/joelniklaus/status/2085725862142623875'>Joel Niklaus</a>." zoomable />
The harness matters most for the open-weight models you run yourself. A model that was never trained in your harness can struggle there. It calls tools the harness doesn't have, or writes output the harness can't read. Training it in one harness doesn't fix this either, because it then learns that harness's habits and struggles in the others.
The fix is to train the model inside the harnesses themselves, with reinforcement learning on multi-step tool use, which is called agentic reinforcement learning (agentic RL). The question behind this work is whether you can take a small open model, train it that way inside the harnesses people actually use, such as Claude Code, Codex and OpenCode, and see it improve across all of them. The harnesses run exactly as they ship: none of them was written with training in mind, and we don't change their code. This article introduces an open framework that makes it possible, built on OpenEnv, with Harbor supplying the tasks and sandboxes and TRL as the trainer.
The article has two parts. The first is a guide: the basics of harnesses, agentic RL and RL environments, then why models need training across harnesses, with what recent papers and model reports show. The second is our own work: how the framework works, and what happened when we used it to train a small open model, LFM2.5-2.6B, across four harnesses at once. Trained across all four, it went from solving 42% of held-out tasks to 54%, averaged over the four harnesses, and used 31% fewer tool calls on the tasks it already solved. The same model trained in OpenCode alone improved mostly in OpenCode, and much less in the three harnesses it never trained in. We also compare RL with supervised fine-tuning (SFT) on a larger model's successful rollouts, which helped less. Our earlier runs with Qwen3.5-2B are in a collapsible section of the training chapter.
import HtmlEmbed from "../../components/HtmlEmbed.astro"; import Note from "../../components/Note.astro";
The basics
What is a harness?
A 2026 position paper on benchmark disclosure defines an agent harness as "the software layer between the model and the task that constructs the context the model sees, mediates its tool calls, validates its outputs, and decides when to retry, escalate, or stop" [@zhang2026stopcomparing]. To the model, the harness is its interface to the task. To a trainer, it is a program someone else wrote, which the trainer cannot change.
A few neighbouring terms are easy to mix up with it, so this is how the article uses them:
- The policy is the model being trained: the weights that turn a prompt into a completion, with no loop and no memory between calls. We also call it the model.
- The agent is the policy running inside a harness, the whole program that plans, calls tools and decides when to stop.
- The sandbox is the isolated place where actions actually run, such as a container, a VM or a tmux session.
- A benchmark is a fixed task set plus a protocol for comparing results on it.
Hugging Face's agent glossary covers the same terms in more detail.
The model chooses the tool and its arguments. The harness executes the call and adds the result back into the model's context before asking it what to do next.
{/* VIZ: d3-harness-anatomy: one harness opened up. Its own loop, its own tool surface, its own sandbox, and exactly one wire leaving it toward an OpenAI-compatible endpoint. Everything inside the box is the harness's business; the single wire is the only surface a trainer can stand on. */} <HtmlEmbed src="d3-harness-anatomy.html" title="Inside a harness" desc="The loop, the tools, the sandbox, and the one model endpoint that leaves it." frameless />
What is agentic RL?
Agentic RL is reinforcement learning for a model that acts over many steps. The actions are tool calls, the observations are tool results, and the reward comes from a grader that looks at the finished trajectory. A single rollout has this shape: write, run, read the result, decide what to try next, and eventually submit something a grader can score. The trainer runs a group of these rollouts for each task and learns from how their rewards compare.
<HtmlEmbed src="d3-llm-rl-coding.html" frameless />
What are RL environments?
An RL environment is the stateful system a policy acts on. The environment takes an action, updates its internal state, returns an observation, and at some point returns a reward. So the environment owns the state, the transitions and the reward, while a harness runs the loop.
The figure below puts the training loop, which samples, scores and updates, next to the environment it acts on.
{/* Carried over from the previous guide so the two articles share one picture of the anatomy. */} <HtmlEmbed src="d3-anatomy-hero.html" frameless />
The environment box holds a task set, a prompt template, tools, observations, an execution backend, world state, a reward rule and a termination condition. Frameworks do not always give each piece a name. In the box labelled "Tools / Harness", harness means the tool surface, not the whole agent program. This figure and the rollout above come from The ultimate guide to RL environments, which covers each component with an example if you want to go deeper.
White-box vs black-box RL environments
Who actually drives the rollout?
In a white-box environment, the trainer owns the loop. The trainer samples an action, calls env.step(), reads the observation, and then samples again. The environment waits to be called. Every token the policy produced is already in the trainer's hands, because the trainer is the one that sampled it. All six frameworks compared in the earlier guide work this way, and it is what TRL's GRPOTrainer expects when you hand it an environment factory.
In a black-box environment, the harness owns the loop. It starts inside a sandbox, runs its own loop, calls its own tools, compacts its own context, and stops when it decides to. It is an agent program that was never written with training in mind. The trainer is outside that box. All it sees is a sequence of calls arriving at a model endpoint.
Microsoft's Agent Lightning team named the two modes [@he2026agentlightning]:
"In traditional agentic RL, the training engine owns the environment interaction loop. In harnessed agentic RL, the harness owns this loop, while the training engine observes only a sequence of LLM request-response pairs."
Harnesses differ wildly on the inside, but every one of them has to call a model, and the model API is the one interface guaranteed to exist outside the harness. Everything else, the harness's state and the environment's, is hidden from the trainer.
<Note variant="info" title="Two uses of white-box and black-box"> The KAT-Coder report [@kwaikat2026katcoder] uses these terms to describe how a harness organises its trajectories. It calls Mini-SWE-Agent white-box because it has a simple loop without trajectory compression, and Claude Code, Codex, OpenClaw and OpenHands black-box because they compress and reorganise their context. In this article, the distinction is who owns the rollout loop: the trainer or the harness. Context handling and ownership of the loop are separate choices. </Note>
Moving the loop into the harness changes two things. The first is who makes each call, and in what order.
{/* VIZ: d3-who-drives: sequence diagram, toggled between the two architectures. Arrow colour is the initiating actor and the right rail marks whether the trainer observes each event, so the asymmetry shows up as a count rather than as an assertion. */} <HtmlEmbed src="d3-who-drives.html" title="Who makes the call" desc="Who initiates each call, under both architectures." frameless />
The second is what the trainer ends up recording. A harness could report events the trainer did not cause, but nothing obliges it to. The figure below shows one rollout three times: as it happened, and as each architecture records it.
{/* VIZ: d3-trainer-record: the same episode as three columns, ground truth against the record each architecture leaves. Hatched rows never reach the trainer; dashed rows survive only as text echoed into the next prompt. */} <HtmlEmbed src="d3-trainer-record.html" title="What the trainer records" desc="One rollout, as it happened and as each architecture records it." frameless />
Why rewards are not enough
An on-policy policy gradient [@williams1992reinforce] needs two things per token: which token was sampled, and the probability it was sampled with. A harness that hands back text and a score gives you neither.
Different token sequences can produce the same text. If you save only the text and tokenize it again, you can get different token IDs from those the model sampled. TRL's write-up puts it directly: "in RL, you optimize on the exact tokens the model produced" [@gallouedec2026tito].
When a harness builds the next prompt, it may add role markers or change whitespace in a tool call. Some harnesses also repair malformed JSON. If the trainer learns from this edited text, it may update the model using a response it never generated.
The probabilities need to be recorded during generation too. In asynchronous RL, the model may have been updated since a rollout was sampled. Recomputing log probabilities with the current weights does not recover the probabilities used during that rollout. Importance sampling compares the current probability with the one used during generation; using the current value for both would make their ratio 1 even when the policies differ.
<HtmlEmbed src="d3-token-drift.html" title="Why re-tokenising is a guess" desc="The same characters, tokenised two different ways." frameless />
To avoid both errors, the sampler must return token ids and per-token log probabilities, and the trainer must keep them. Never re-encode text you decoded. Keep the sampled ids and append the template's suffix by id concatenation. This works because most chat templates extend token for token when a tool message is appended, and eighteen of the nineteen models tested in TRL's write-up do so unmodified. It is also why a system that wants the exact tokens has to intercept at the model endpoint rather than at the text boundary.
Other teams keep exact tokens from the trainer's side instead. Prime Intellect's renderers library turns a model's chat template into Python code that renders messages to token ids and extends a multi-turn rollout without re-rendering what the model sampled. It needs the trainer to own the loop, and its announcement warns that harnesses which repair tool calls or compact their history break it, which is the case the capture proxy is built for.
Not everyone agrees the token-level machinery is necessary at all. OpenForgeRL builds the same proxy architecture and reconstructs training samples from the prompt and response pairs the proxy collects. The paper never mentions token ids or log probabilities, and it still reports the strongest multi-harness results published so far [@yu2026openforgerl]. This article takes the token-faithful side, and the question is not settled.
import HtmlEmbed from "../../components/HtmlEmbed.astro";
Why train across harnesses
Benchmark scores now come with a harness attached
Model cards have started saying which harness a score came from. GLM-4.7 promises "significant improvements on complex tasks in mainstream agent frameworks such as Claude Code, Kilo Code, Cline, and Roo Code" [@zai2025glm47]. Kimi K2 reports Terminal-Bench [@merrill2026terminalbench] twice: 25.0 under Terminus and 30.0 under Moonshot's own framework [@kimi2025k2]. MiniMax M2 names a harness for almost every benchmark it lists [@minimax2025m2card]. DeepSeek-V3.2's thinking mode wouldn't run under Terminus at all, so its Terminal-Bench number had to come from a different harness [@deepseek2025v32].
The harness can even change which model comes out ahead. @zhang2026stopcomparing took three models that sit within three points of each other on a public coding leaderboard: GLM-5.1, GPT-5.4, and Kimi K2.6. They ran all three on the same 100 SWE-bench Verified [@jimenez2024swebench] tasks under three harness configurations, with everything else held fixed. The configurations build on each other: Minimal has verbose tools, no context compression and no retries, Improved trims the tools and adds compression and retries, and Full adds self-checks, drift checks and rollback.
<HtmlEmbed src="d3-scaffold-reversal.html" title="Same models, same tasks, three harness configurations" desc="Each of the three models is the best model under a different harness configuration." frameless />
Each model comes out on top under a different harness. Swapping the harness moved GLM-5.1 by 13 points, while swapping the model inside the same harness moved the score by only 2.5 to 5. Joel Niklaus found the same across ten harnesses on SWE-bench Pro.
You can see the same thing outside a controlled test. Claude Opus 4.5 scores 45.9% on SWE-bench Pro [@deng2025swebenchpro] on Scale's SEAL leaderboard and 55.4% inside Claude Code, with the same weights [@zhang2026stopcomparing].
When a model leaves the harness it was trained in
A model can perform well in the harness it was trained in and struggle when moved to another. The Orchard paper measured this transfer across harnesses [@peng2026orchard]. It took two open coding models trained with one or two harnesses and ran them under three, including Kimi-CLI, which none of the systems compared had used in training. Orchard's own model ran alongside them. It was fine-tuned on trajectories from OpenHands and Mini-SWE-Agent, then trained with RL in Mini-SWE-Agent.
<HtmlEmbed src="d3-harness-lockin.html" title="What training in one or two harnesses costs" desc="Resolve rates for three systems, each run under three harnesses." frameless />
Moving OpenSWE-32B from OpenHands, the harness the paper treats as its native one, to Mini-SWE-Agent costs 7.5 points. Under Kimi-CLI, it drops 58.8 points, to 3.6% on SWE-bench Verified, and scores zero on Terminal-Bench 2.0. Scale-SWE stops producing valid tool calls anywhere but its home harness. Orchard's model stays between 45.0 and 64.3 on SWE-bench Verified across all three.
The paper calls these a degraded resolve rate, where the model still works but solves less, and a catastrophic format failure, where its output stops being usable at all. Each row of that figure is one fixed model, and each benchmark uses the same tasks under every harness, so the drop comes from the harness.
Why models overfit to a single harness
The KwaiKAT team names the cause [@kwaikat2026katcoder]:
"In agentic RL, if training relies solely on a single fixed harness, the model often learns not 'how to solve the task' but 'how to solve the task under that particular harness's interface conventions.'"
They split it into three kinds of overfitting: to the harness's action format, to its context structure, and to its control flow, the retries and stop conditions the model learns to lean on.
<HtmlEmbed src="d3-overfit-modes.html" title="Three ways a model overfits to its harness" desc="What the model anchored to, and what breaks when that changes." frameless />
Harnesses differ along exactly those lines. They speak different API dialects, meaning the request and response format they use to talk to a model server: OpenAI chat-completions, OpenAI Responses, Anthropic Messages, Google Gemini. They differ in whether they use tool calling at all, how they compact context, and how much of the control flow they take away from the model.
{/* VIZ: harness-ecosystem-matrix: scannable HTML table. Columns: harness, then the API dialects it speaks, and whether it uses tool calls. */} <HtmlEmbed src="harness-ecosystem-matrix.html" title="The harness landscape" desc="The model APIs each harness speaks. Hover a harness for its maker and what sets it apart." frameless />
Mini-SWE-Agent's README lists avoiding scaffold overfitting as a reason for its simple design. Aider uses a different interface: it asks the model to write edit blocks in prose instead of structured tool calls. A model trained on tool calls has to learn that output format too.
In practice, the failure often shows up as an error rather than a lower score. A model trained in one harness calls a tool by that harness's name for it, with that harness's argument names, and a harness that spells them differently rejects the call before the tool ever runs.
<HtmlEmbed src="d3-format-mismatch.html" title="What harness overfitting looks like" desc="One tool call, accepted by the harness the model trained in and rejected by one it never saw." frameless />
The list of harnesses keeps growing. Harbor 0.22.0 ships adapters for more than 40 of them, and OpenEnv has validated ten end-to-end, so a model trained on a few will keep meeting ones it never saw.
Frontier labs now train across harnesses on purpose
KwaiKAT's answer, which they call harness scaling, is to vary the harness during training. Poolside's Laguna report does this [@poolside2026laguna]:
"To encourage generalization across diverse agent harnesses, our training data includes trajectories from external frameworks such as OpenHands, OpenCode, and Mini-SWE-Agent."
They added 1.3 billion tokens of these trajectories to their supervised training and kept each harness's own habits in on purpose. Reinforcement learning then runs only in the harness they ship in production, pool, and the report doesn't say why the other harnesses stop there.
Kimi K3's RL environment builds harnesses such as Claude Code and Codex from composable modules, so the model trains on many harness configurations instead of one [@kimi2026k3]. Qwen3-Coder-Next generates its agentic coding data in six different harnesses [@qwen2026codernext], and MiMo-V2.6 trains on a pool of task-adapted mini-harnesses [@xiaomi2026mimov26]. Liquid AI does the same at a much smaller size. For LFM2.5-2.6B, the model we train later, Liquid picks a harness at random for each training task. Their release post gives the reason: "training directly inside Hermes Agent, OpenClaw, and other harnesses exposes the model to their tools, system prompts, and interaction patterns, helping it work reliably across agent environments."
OpenForgeRL checked whether that variety costs peak performance. It trained the same model on one harness and on three, and the three-harness model scored higher even on the single harness's home turf, 48.5 to 46.0, and almost twice as high under Codex [@yu2026openforgerl].
{/* VIZ: paper-receipts: tabbed excerpt viewer. Each tab shows a real crop from the official PDF of the passage being cited, with page reference and a link. Crops live in app/public/papers/, with provenance in that folder's README. */} <HtmlEmbed src="paper-receipts.html" title="The claims, in the papers themselves" desc="Eight 2026 reports, at the page cited." frameless />
Model reports have only recently started saying which harness a number came from. In 2025, most named none or one per benchmark. By 2026, every report on the timeline below trains across several.
<HtmlEmbed src="d3-posttraining-timeline.html" title="From naming no harness to training across several" desc="Recent model releases over time, by the most each report says about harnesses. Hover or tap a dot for details." frameless />
What is missing
What is still missing is an open, reliable way to do this with any harness. It has to capture everything RL training uses from harnesses you don't control, and plug into whichever trainer you already use.
It also doesn't take a frontier-sized budget. Agent Lightning takes Qwen3.5-9B from 41.8% to 56.4% on SWE-bench Verified with roughly 6,000 training examples [@he2026agentlightning]. The same paper names the hard part. The harness owns the loop, so the trainer only sees requests and responses going past, and turning those back into training samples is still an open problem.
We built this on OpenEnv [@openenv2026], around a capture proxy that sits between the harness and the model. Every call the agent makes passes through the proxy, which records the prompt and completion tokens as the model saw and produced them, with their log probabilities. It speaks the API formats coding agents use, so Claude Code, Codex, and OpenCode run unmodified, and a custom harness only has to point at it. Because it all sits behind OpenEnv's open environment interface, the same setup can feed different trainers, and ours was TRL [@trl].
On top of that, the Harbor integration [@openenv2026harbor] serves Harbor's containerized tasks as OpenEnv environments, so the harness and the sandbox become settings you choose per rollout.
import Accordion from "../../components/Accordion.astro"; import HtmlEmbed from "../../components/HtmlEmbed.astro";
How the framework works
The framework has three parts. OpenEnv is the interface the harness, the environment and the trainer all connect to, and its capture proxy records the tokens. Harbor supplies the tasks and the sandboxes. TRL trains on what the proxy recorded. This chapter follows one rollout through all of them, then covers each part in turn.
OpenEnv
OpenEnv is a standard interface for RL environments [@openenv2026]. It offers Gymnasium-style reset, step, and state over a client and server transport, with typed actions and observations, packaged as Docker and publishable to the Hub. It began as a Meta PyTorch and Hugging Face collaboration and now lives at huggingface/OpenEnv, steered by a committee of twelve organisations, under BSD-3-Clause.
In this article, OpenEnv is the shared interface that the harness, the environment, and the trainer all connect to. It does not train anything or define rewards. The capture proxy records what RL training needs from any agent that calls a model API. The Harbor integration [@openenv2026harbor] serves Harbor's containerised tasks as OpenEnv environments, with the harness and sandbox chosen per rollout.
Training through the typed TrainingTrace API needs OpenEnv 0.7.0 or later and Python 3.12 for the Harbor extra. On Python 3.10 or 3.11, openenv[harbor] does not install the Harbor dependencies. The harbor_env package also comes from the repository's envs/ directory, not the OpenEnv wheel. For a checkout from main:
# Run in a Python 3.12 virtual environment.
git clone --depth 1 --branch main https://github.com/huggingface/OpenEnv.git
python -m pip install -e './OpenEnv[harbor]'
export PYTHONPATH="$PWD/OpenEnv/envs${PYTHONPATH:+:$PYTHONPATH}"
See TRL's Harbor example for the trainer and inference-server dependencies and the two-GPU launch commands.
One rollout, end to end
Before looking at each part, here is the whole path. The figure follows one rollout, three turns long, of a task from SmolDataEnvs, our suite of data-analysis tasks built from real Kaggle notebooks, through every part of the system. Switching the harness changes only how Harbor wires it to the proxy, the format of its model calls and replies, and the names of its tools.
<HtmlEmbed src="d3-openenv-system.html" title="One rollout through OpenEnv" desc="One three-turn rollout, from the trainer’s request to the weight update, step by step." frameless />
The trainer and the inference server, vLLM [@kwon2023vllm], each get their own GPU. The OpenEnv server can run next to them or on a Hugging Face Space, and every rollout gets its own sandbox. The hardware for our runs is in the training setup. The harness inside the sandbox never talks to vLLM or to the trainer. It reaches the model only through the capture proxy, and the only credential it holds for that is a session id.
The capture proxy
A harness finds the proxy the way it would find any model provider, through a base URL and an API key. The API key is a capture session id minted for that rollout, which is how one proxy on one port serves every concurrent rollout. A call carrying a key the proxy never registered gets a 401.
<HtmlEmbed src="d3-capture-proxy.html" title="The capture proxy" desc="One model call, step by step, through the capture proxy." frameless />
Harnesses speak four different model APIs, as the harness table shows. The proxy works out which one a request uses from its path, then its headers, then the shape of its body. It converts the request to chat completions with converters vendored from NVIDIA's Polar gateway [@xu2026polar], and replays the answer in the caller's own format.
<HtmlEmbed src="d3-dialects-funnel.html" title="Four API dialects, one shape" desc="The same request in the four formats coding agents speak, and the one shape the trainer sees." frameless />
The call to the engine never streams. The proxy waits for the whole completion, stores it, and replays it to the harness as a stream if the harness asked for one. Apart from a later first token, the harness cannot tell the difference, and the proxy never has to parse partial deltas.
What gets recorded
For each call the proxy asks the engine for the prompt's token ids, the sampled token ids and a logprob for every sampled token. It also samples from the full distribution, with no top_p or top_k. Truncating the distribution biases what the policy samples away from what it would sample on its own, which in RL is a known route to entropy collapse, and vLLM computes its processed logprobs after the truncation, so they would not match the policy either. In our runs, moving top_p to 1.0 took the importance ratio from 0.985–0.993 to 0.9984–0.9999. On vLLM this needs two server flags:
vllm serve <model> --return-tokens-as-token-ids --logprobs-mode processed_logprobsSGLang works too.[^sglang]
[^sglang]: SGLang returns the sampled token ids from v0.5.17 for non-streaming requests, and v0.5.20 adds them for streaming. The proxy never streams from the engine, so v0.5.17 or later should work, though we only tested a build from SGLang's main branch.
The proxy does not take any of this on trust. The first time it sees an engine it sends a probe and grades the result, and it also checks whether the logprobs are raw or processed. An engine below the tokens level still serves rollouts, but they are marked as evaluation only, and asking for training data from one raises an error. Hosted APIs such as OpenAI, Anthropic and Hugging Face Inference Providers land there, so they can evaluate a harness but not train through it.
<HtmlEmbed src="d3-capture-levels.html" title="Three levels of capture" desc="Only one of them can be trained against." frameless />
From calls to training sequences
Harnesses retry, spawn subagents and compact their context, so a rollout is rarely one clean conversation. The proxy stores each model call as a node and links it to the earlier call whose prompt and completion form the longest exact token prefix of its own prompt. A retry shows up as a sibling that never continued. A subagent has its own system prompt, so its first call extends nothing and starts a new root, and a compacted context does the same.
<HtmlEmbed src="d3-rollout-graph.html" title="The rollout graph" desc="A trace as a graph of model calls, and its trainable branches." frameless />
Each path from a root to a leaf becomes one training sequence. Context tokens get a loss mask of 0 and sampled tokens get 1. A turn whose logprobs are missing or misaligned stays in the sequence as context and is never used as a target. These checks run as each call arrives rather than at export, because a misaligned turn is easiest to diagnose while the proxy still knows which turn it was.
<HtmlEmbed src="d3-token-contract.html" title="What a rollout returns" desc="What one rollout hands back, turn by turn." frameless />
Capturing your own harness
Nothing in the proxy is specific to Harbor, so any program that calls one of the four APIs can be captured. Start the proxy, mint a session with POST /sessions, give your agent the proxy's URL as its base URL and the session id as its API key, and read the rollout back from GET /sessions/{id}/rollout.
python -m openenv.core.harness.capture.server --llm-url http://127.0.0.1:8000 --model <model>The proxy binds to localhost by default. On any other interface it needs an admin key, which guards the routes that mint and read sessions.
The proxy is a single process. In our runs its health check started to starve at around 200 concurrent sessions, and the process crashed at 320. A rollout that hits its model-call budget is also stopped by the proxy itself, so that final reply is never part of the training data.
Harbor
Harbor, from the team behind Terminal-Bench [@merrill2026terminalbench], runs agents against containerised tasks and keeps the task, the harness and the sandbox independent of each other. Version 0.22.0 ships adapters for more than 40 agent harnesses and 26 execution backends, from local Docker to Daytona, Modal and E2B. About 80 task datasets already use its format, including Terminal-Bench and SWE-bench [@jimenez2024swebench]. Any harness can attempt any task on any backend, so one task set can be trained against many harnesses, and a run is one command that names the dataset, the agent and the backend. Adithya wrote about why it is the right abstraction for coding RL in RL Coding Environments 101: Why Harbor Exists.
A Harbor task is a directory with an instruction, an environment and a test script. The ones below come from SmolDataEnvs, the task suite used for every run in this article. Its questions come from Kaggle notebooks in the jupyter-agent dataset, each with an automatic grader. Pick a task and a file to read it as the agent and the verifier see it.
<HtmlEmbed src="d3-harbor-task.html" title="Three SmolDataEnvs tasks, file by file" desc="The six files of a Harbor task, taken unedited from the training set, and how the reward gets out." frameless />
The task names no harness, sandbox backend or trainer, because those are chosen when it runs. The Harbor visualiser opens the whole training set the same way, all 5,000 tasks.
<iframe src="https://huggingfaceh4-harbor-visualiser.hf.space/?dataset=FineEnvs/SmolDataEnvs-harbor-train" title="Harbor visualiser showing the SmolDataEnvs training set" width="100%" height="640" loading="lazy" style={{ border: "1px solid var(--border-color)", borderRadius: "10px", margin: "14px 0" }}
</iframe>
Note: Harbor calls its sandbox backends environments. In this article, sandbox means the box the agent runs in, and environment means the OpenEnv server.
Serving Harbor through OpenEnv
Harbor already runs an agent against a task and returns a score. A trainer also needs the tokens the policy generated and their probabilities. Harbor's RL documentation lists two ways to get them: intercept the tokens at the inference server, or have the harness return them with its result. The second needs a harness that puts its tokens in the result metadata, and the docs say that support is still being added to Terminus 2, Harbor's own harness. The integration takes the first, through the capture proxy, so it works with any harness that calls a model API.
The trainer talks to the environment over HTTP instead of running rollouts in its own process. An earlier in-process version let an exception from inside someone else's agent reach the training loop, where one crashed rank left the others waiting at the NCCL barrier indefinitely. Now nothing raises across that boundary. A failed rollout comes back with ok=False and reward=None, and the trainer handles a value instead of catching an exception.
The four commands
| Command | What it does |
|---|---|
openenv harbor info | Reports what this machine can run: whether the engine returns token ids, which sandbox backends have working credentials, which datasets resolve and how many tasks each holds, and which harnesses are validated. Starts nothing. |
openenv harbor rollout | Runs rollouts without an environment server. If a rollout works here and fails under serve, the fault is in the serving layer. |
openenv harbor serve | The environment server: a Task API, a run_rollout tool over MCP, a web UI and the capture proxy. |
openenv harbor push | Deploys the same server to a Hugging Face Space, with configuration as Space variables and credentials as secrets. |
openenv harbor info    --llm-url $LLM --dataset org/train,org/eval
openenv harbor rollout --llm-url $LLM --dataset org/train --task-index 0 -n 5 --harness opencode --sandbox e2b
openenv harbor serve   --dataset org/train,org/eval
openenv harbor push    --llm-url $LLM --dataset org/train,org/eval --repo-id you/harbor-env
rollout requires --llm-url and has no default, because a stale endpoint produces rollouts that look fine and carry no token ids. serve can start without one, because each rollout names its own engine. That let one deployment serve both training, pointed at the trainer's vLLM, and evaluation. Here -n 5 (or --n-tasks 5) runs tasks 0 through 4 once each, starting at --task-index 0. It does not sample five attempts at one task. The E2B example matches the reported experiments; the companion tutorial uses Daytona. A rollout prints one line when it finishes:
[opencode / e2b] task 0: 0000_369_369503_qa_1 ...
   ok    reward=1.00  turns=9  roots=2  multi-turn  tokens=1043  atif=match  48s
<HtmlEmbed src="d3-serve-flow.html" title="From serve to rollout" desc="What happens once at start-up, and what happens on every rollout." frameless />
The next two parts cover how each harness is wired to the proxy and how rewards and captures are checked. The Harbor page of the OpenEnv docs has the full reference.
<Accordion title="Wiring each harness, picking the reward, and checking the capture">
Wiring each harness
Harbor already knows how to install and launch each harness. OpenEnv adds only the place each one reads its model URL and API key from, kept as one table entry per harness, so supporting a new harness means adding an entry rather than writing a new environment. Ten harnesses have passed the capture contract and the trace check described below, across 16,000 rollouts on the SmolDataEnvs test set.
<HtmlEmbed src="harness-seams.html" title="How each validated harness reaches the proxy" desc="Where each harness gets the proxy's URL and its session id from." frameless />
Most harnesses read environment variables, and OpenEnv sets those for the agent's run only. The session id Codex receives as OPENAI_API_KEY therefore never reaches the verifier, which may need a real key of its own. Claude Code and Gemini CLI also read the variables in the server process, so they get them there too. OpenCode and Pi take a config file written into the sandbox, and Terminus 2 runs on the host and is handed the URL and key directly.
Picking the reward, and checking the capture
Harbor's verifier can return several named scores, and GRPO [@shao2024deepseekmath] needs one number per rollout. The integration uses the only score if there is one, or the one named reward, and otherwise asks the caller to choose. It never combines scores itself, because whatever weighting it picked would become the training objective. An earlier run had a +0.2 for submitting anything term. The policy learned to submit immediately, and held-out accuracy fell from 0.740 to 0.178 while training reward still looked healthy. When the verifier never runs, the reward stays None all the way to the trainer, so a sandbox that died is not scored as a wrong answer.
The proxy's own checks can only look at data it captured. As an independent check, each rollout is also compared with the trajectory file Harbor writes itself, in its ATIF format, call by call: the number of turns, the completion tokens per call, and which calls count as agent steps. Any mismatch fails the rollout.
ATIF completion_tokens : [37, 36, 104, 264, 255, 119, 32, 27]   total 874
intercept turn_lengths : [37, 36, 104, 264, 255, 119, 32, 27]   total 874
ATIF step-1 prompt_tokens 7990  ==  intercept prompt_len 7990
This caught a harness that sent an empty tools array, got a 400 from the inference server and was cut short, leaving a rollout graph that looked well formed. The proxy now drops empty tools arrays before forwarding.
Deploying it and training against it
On one machine, serve listens on two ports, one for trainers and the web UI and one for the capture proxy. Sandboxes usually run somewhere else, so the proxy reaches them through a tunnel, set with --expose and Gradio by default. When the server itself runs on a Hugging Face Space, it has only one port, so the proxy is mounted at /capture. That Space has to be public, because the agent in the sandbox cannot send the auth header a private Space requires. It stays safe because the proxy only answers registered session ids, and minting one needs an admin key. The sandboxes themselves stay on E2B or another Harbor backend, one per rollout.
Before training, raise the server's concurrency limit, max_concurrent_envs. It caps how many rollouts one server runs at once, and the default of four is fewer than the eight rollouts in each of our GRPO groups. Past the limit, serve rejects new rollouts with CAPACITY_REACHED.
OpenEnv's HarborSessionFactory produces sessions in the shape TRL's HarnessRolloutWorker expects when the agent owns the loop. The worker was merged in TRL #6947 and lives under trl.experimental. As of 1 October 2026, it is on main but not in the latest release, v1.14.1. Install TRL from main until the next release:
python -m pip install 'trl @ git+https://github.com/huggingface/trl.git@main'Each session requests one rollout, waits for it, and returns a typed TrainingTrace through fetch_training_trace(), with token IDs, behavior logprobs and loss masks. TRL consumes that object directly. Given a prepared task dataset and the model's tokenizer, the worker wiring is:
from functools import partial

from harbor_env.harness import HarborSessionFactory
from trl.experimental.async_grpo.openenv_harness import HarnessRolloutWorker


def correctness_reward(outcome):
    return outcome.env_reward  # None keeps a failed verifier unscorable.


def make_rollout_worker(dataset, tokenizer, server_url, vllm_url, model):
    factory = partial(
        HarborSessionFactory,
        server_url=server_url,
        split="FineEnvs/SmolDataEnvs-harbor-train",
        llm_url=vllm_url,
        model=model,
        harness="opencode",
        sandbox="daytona",
        reward_key="correctness,reward",
    )
    return HarnessRolloutWorker(
        harness_session_factory=factory,
        harness_adapter=None,
        rollout_reward_fn=correctness_reward,
        model_name=model,
        dataset=dataset,
        processing_class=tokenizer,
        reward_funcs=[],
        num_generations=8,
        max_inflight_tasks=8,
        vllm_server_url=vllm_url,
        max_tokens=4096,
        temperature=1.0,
        top_p=1.0,
        top_k=-1,
        chat_template_kwargs={"enable_thinking": False},
    )
Pass this worker as rollout_worker to AsyncGRPOTrainer. The worker calls the factory with sampling= before generation, so the capture policy matches training. harness_adapter=None lets the harness run its own loop. This minimal callback forwards correctness; the training setup adds the tool-efficiency bonus. The full TRL example also shows task discovery, AsyncGRPOConfig, the trainer and checkpoint saving.
In our runs every rollout in a GRPO group used the same harness, so the advantage compared actions rather than harnesses. The sampling temperature sent with each rollout also matched the one the trainer used to recompute logprobs.
Try the SmolDataEnvs Harbor Space. Choose a task, connect a model and run a harness to inspect its rollout and traces. The training tutorial includes the same environment source and commands for HF Jobs or a local cluster.
import Accordion from "../../components/Accordion.astro"; import HtmlEmbed from "../../components/HtmlEmbed.astro"; import Note from "../../components/Note.astro";
Training small models across harnesses
We trained LFM2.5-2.6B with the setup from the previous chapter, once in OpenCode alone and once across four harnesses, and then compared both runs with supervised fine-tuning on a larger model's rollouts. Our first runs used Qwen3.5-2B. They shaped the LFM setup, and they are in a collapsible section at the end.
Setup
- Tasks. 1,000 SmolDataEnvs training tasks, 400 medium and 600 hard, in one fixed order shared by both runs. The test set is 250 held-out tasks with no overlap in notebook, question, or instruction.
- Two runs. One trains in OpenCode only. The other is multi-harness (OpenCode, Claude Code, Codex, and Mini-SWE-Agent), where each GRPO [@shao2024deepseekmath] group of eight rollouts uses one of the four harnesses.
- Evaluation. Both runs are evaluated the same way, including under the three harnesses the OpenCode-only run never trained in. Every 100 steps, each of the 250 test tasks runs once under each of the four harnesses, 1,000 cells in all. A cell counts as solved when its first graded attempt is correct.
- Recipe. Async GRPO in TRL for 1,000 steps. Async means generation and training run apart. One H100 trains while a second serves the policy with vLLM [@kwon2023vllm] and keeps producing rollouts, so training never waits for the slowest agent. The price is that rollouts come from weights usually two optimizer steps old, and never more than four.
- Hardware and time. Two H100s per run on the Hugging Face cluster, and one E2B sandbox per rollout with 1 CPU and 4 GB of memory. Training took about 32 hours for the OpenCode-only run and 46 hours for the multi-harness run, not counting evaluation, queueing and restarts. We did not track the full cost closely enough to quote it.
The companion tutorial has readable multi-harness and native OpenCode training scripts, plus HF Jobs and Slurm instructions. The reported LFM runs used Harbor for both policies and E2B sandboxes. The current tutorial uses Daytona and includes native OpenCode as a separate comparison, so it is not an exact replay of those historical runs.
Each cell runs once, so a point or two between neighbouring checkpoints is noise. Trust the trend across checkpoints over any single one.
Where the base model starts
<HtmlEmbed src="d3-train-results.html" config={{ view: "baselines", only: "lfm" }} title="LFM2.5-2.6B on the test set before training" desc="Pass@1 by harness before any training." frameless />
The baseline evaluation already shows the problem from the earlier chapters. The same weights solve 62% of tasks under Mini-SWE-Agent, but only 33% under Claude Code. LFM2.5-2.6B was not trained in our four harnesses, as far as its release says: Liquid AI names Hermes Agent and OpenClaw as its training harnesses.
What we rewarded
We rewarded LFM for two things:
- Correctness: 1 for a correct answer and 0 for a wrong one.
- Tool efficiency: a small bonus, at most 0.1, for a correct answer that takes fewer calls. A wrong answer still scores 0, so the model can't earn the bonus by giving up early.
The bonus comes from the Qwen runs, which were rewarded for correctness alone. That gives the model no reason to stop exploring once it has the answer, and in an early Qwen run the tool calls per rollout crept from 13 to 41.
<HtmlEmbed src="d3-train-results.html" config={{ view: "reward" }} title="Reward for one rollout" desc="Correctness alone, and correctness with the tool-call bonus that LFM trained on." frameless />
The bonus is at most 0.1, but GRPO learns from differences inside a group, so even a small bonus counts. GRPO runs eight rollouts of the same task and trains on how each one compares with the group's average. When all eight are correct, correctness alone makes them identical, and the group teaches nothing. The bonus is then the only thing that tells them apart, and it favours the shortest solutions.
Here are two real groups from the multi-harness run, scored both ways.
<HtmlEmbed src="d3-train-results.html" config={{ view: "group" }} title="One GRPO group, scored both ways" desc="Eight real rollouts of one task, with the reward and advantage each would get under the two rewards." frameless />
In 97 of 555 OpenCode-only groups (17.5%) and 155 of 686 multi-harness groups (22.6%), every scorable rollout was correct but tool counts differed. The efficiency bonus supplied their only reward contrast. These audited counts cover groups that contributed to the retained training updates; they exclude work discarded on resume. Tool counts come from the harness's own trace. The reward audit found no formula mismatches and no bonus on wrong answers.
In both LFM runs, tool calls per rollout fell during training and under every harness, as the curves below show. There was no LFM run without the bonus, so we cannot say the bonus caused this on its own.
Training curves
<HtmlEmbed src="d3-train-results.html" config={{ view: "train", runs: ["lfm_harbor_opencode", "lfm_harbor_multi"] }} title="LFM2.5-2.6B training curves" desc="Reward, correct answers and tool calls at every optimizer step. Drag the slider to change the smoothing." frameless />
The share of correct rollouts climbs over the first few hundred steps in both LFM runs. After that it rises and falls with the difficulty of each stretch of tasks, which is the same for both runs because they follow the same task order. Tool calls fall throughout. On the test set, the OpenCode-only model performs better than the multi-harness model under OpenCode (58% vs 50%), while the multi-harness model performs better under Claude Code (49% vs 42%) and Codex (54% vs 43%).
The tool-call curves look reversed between training and test. During training, the multi-harness run makes more calls per rollout, because its average includes Claude Code, Codex and Mini-SWE-Agent rollouts, and those harnesses make more calls than OpenCode even before any training. On the test set, both models run under all four harnesses, and there the multi-harness model makes fewer calls under every one of them. The OpenCode-only model learned to use fewer calls in OpenCode, and that carried over only in part, mainly to Codex.
Accuracy
<HtmlEmbed src="d3-train-results.html" config={{ view: "curve", runs: ["lfm_harbor_opencode", "lfm_harbor_multi"] }} title="LFM2.5-2.6B pass@1 during training" desc="Pass@1 at every evaluated checkpoint, overall and under each harness." frameless />
Both runs climb in accuracy, by 10 points for OpenCode-only and 12 for multi-harness, most of it in the first 200 steps, and hold it to step 1,000. They end at 52.3% for OpenCode-only and 54.2% for multi-harness. Both gains are well outside the noise. The 1.9-point gap between the runs is within the noise, so overall accuracy does not separate them.
<HtmlEmbed src="d3-train-results.html" config={{ view: "final" }} title="LFM2.5-2.6B at step 1,000, by harness" desc="Pass@1 by harness, next to the base model." frameless />
The per-harness split is the clearest result. The OpenCode-only model is best under OpenCode, the harness it trained in. The multi-harness model is better under Claude Code and Codex, and the two tie under Mini-SWE-Agent. Most of the OpenCode-only model's gain is in OpenCode (34 → 58%), while the multi-harness model gained under all four.
Tool calls and tokens
<HtmlEmbed src="d3-train-results.html" config={{ view: "efficiency" }} title="How much work each LFM checkpoint does" desc="Tool calls and tokens per test task at every checkpoint, overall and under each harness." frameless />
Both models solve more tasks with fewer tool calls, and the multi-harness model cuts more, 31% fewer calls than the base model on the tasks both solved, against 11% for OpenCode-only. Fewer calls also means less history resent on every call, so input tokens fall with them. The biggest saving is under Codex, where the multi-harness model uses about half the calls. The clear exception is OpenCode-only under Claude Code, a harness it never trained in, where it used more calls and more tokens than the base model.
<HtmlEmbed src="d3-savings-heat.html" title="Savings against the base model, by checkpoint and harness" desc="Percent fewer tool calls, generated tokens or input tokens than the base model, on the test tasks both solved. Hover a cell for its task count." frameless />
The multi-harness model's Codex savings grow at almost every checkpoint, and by step 1,000 every harness is blue on all three measures. The OpenCode-only model saves steadily in OpenCode and more and more in Codex. Under Claude Code, it generated more tokens than the base model at nearly every checkpoint, up to 62% more at step 500.
How much each run saw
Both runs took 1,000 optimizer steps, but they did not see the same amount of data.
| OpenCode only | Multi-harness | |
|---|---|---|
| Distinct training tasks | 555 | 626 |
| Supervised tokens | 12.5M | 18.7M |
| Tokens processed in training | 162M | 451M |
Claude Code rewrites its own history as it goes, so each of its rollouts became about eight training rows, each carrying its own copy of the context, while the other harnesses averaged about one. With one seed per run and unequal exposure, the comparison between the two runs is observational.
SFT vs RL
RL is not the only way to learn from a harness. The capture that gives RL its exact tokens also records whole trajectories, so a larger model's successful runs can be used for supervised fine-tuning (SFT). We tried this on LFM2.5-2.6B to see how far imitation gets next to the RL runs above.
The experiment
We ran Qwen3.8-27B as a teacher on SmolDataEnvs training tasks in all four harnesses, through the same OpenEnv and Harbor setup, with sandboxes on Daytona. Each task got up to three attempts per harness, and we kept the first one the verifier graded correct. That gave 3,189 successful rollouts from 888 tasks, 377 medium and 511 hard.
Every assistant turn in a rollout becomes one training example. The conversation up to that turn, tool outputs included, is the context, and the loss is on the next assistant response only. The examples are tokenized with LFM's own chat template, not the teacher's.
We trained two SFT models from the same LFM2.5-2.6B base as the RL runs:
- OpenCode SFT on the 801 OpenCode rollouts, 4,825 examples.
- Multi-harness SFT on all 3,189 rollouts, 17,929 examples, shuffled together with no balancing between harnesses.
Both are full fine-tunes with TRL's SFT trainer for two epochs, at a learning rate of 3e-6 and an effective batch size of 8. Each epoch is evaluated on the same 1,000 test cells as the RL runs.
The data is public as SmolDataEnvs-multiharness-sft. It has one config per harness, an all config with the four together, and configs already tokenized for LFM2.5-2.6B and Qwen3.5-2B, next to a training script. The raw teacher rollouts are in qwen38-27b-harbor-rollouts.
The two methods learn from different things:
| SFT | RL | |
|---|---|---|
| Learns from | the teacher's successful rollouts | its own rollouts |
| Training signal | the teacher's next response | correctness, plus the tool-call bonus |
| Rewards fewer tool calls | no | yes |
| Training tasks (OpenCode / multi-harness) | 801 / 888 | 555 / 626 |
| Supervised tokens, whole run | 1.2M / 8.2M | 12.5M / 18.7M |
| Training time | 1.5 h / 6.5 h | 32 h / 46 h |
The SFT times are the trainer's own loop and leave out collecting the teacher's rollouts, which took a 27B model through all four harnesses.
Results
<HtmlEmbed src="d3-sft-vs-rl.html" config={{ view: "map" }} title="SFT and RL on LFM2.5-2.6B" desc="Overall pass@1 against how many fewer tool calls each model makes than the base model." frameless />
For RL we use each run's best checkpoint on the test set: step 900 for OpenCode only and step 700 for multi-harness. Choosing on the test set flatters RL slightly, but both are within half a point of their step-1,000 scores.
RL ends ahead of both SFT runs. Multi-harness RL reaches 54.6%. The better SFT model, OpenCode SFT, reaches 47.5%, and multi-harness SFT 43.1%, 11.5 points below the RL model trained in the same four harnesses.
OpenCode SFT looks like a smaller OpenCode RL. Almost all of its gain is in OpenCode, from 33.6% to 51.6%, close to OpenCode RL's 56.0%. Under Claude Code it stays where the base model was, 33.2%, and under Mini-SWE-Agent it drops a little, from 62.1% to 58.8%. Training in one harness mostly helped that harness, by imitation or by RL.
Multi-harness SFT spreads the gain, then loses it in Mini-SWE-Agent. It improves under Claude Code (33.2 → 42.4%), Codex (40.0 → 46.8%) and OpenCode (33.6 → 38.0%). Under Mini-SWE-Agent it falls from 62.1% to 45.2%, which cancels the rest, so overall it ends at 43.1%, within the noise of the base model's 42.2%. After the first epoch it was below the base model, at 38.3%, with OpenCode down to 22.4%. Multi-harness RL improved under all four, Mini-SWE-Agent included. We have not yet worked out why SFT hurt Mini-SWE-Agent.
<HtmlEmbed src="d3-sft-vs-rl.html" config={{ view: "harness" }} title="SFT and RL on LFM2.5-2.6B, by harness" desc="Pass@1 or fewer tool calls under each harness. Switch the SFT bars between epoch 1 and epoch 2." frameless />
SFT cuts tool calls without being rewarded for it. SFT has no efficiency term, yet on the tasks both it and the base model solved, multi-harness SFT makes 24.2% fewer tool calls, with fewer calls under every harness. OpenCode SFT makes 8.5% fewer overall, but more than the base model under Claude Code (10.5% more) and Mini-SWE-Agent (4.8% more). RL shows the same pattern: training across the four harnesses cut calls everywhere, 26.7% for multi-harness RL at step 700 and 31.1% by step 1,000, and training in OpenCode alone cut them unevenly.
What this comparison can't tell us. The two SFT runs differ in more than the harness mix. The multi-harness run has about seven times the supervised tokens and nearly four times the steps. SFT and RL also differ in objective, data source, task pool and compute, and each setup ran once. These are observations, not a ranking of methods. The runs we want next are SFT followed by RL against RL from the base model, harness mixes compared on the 692 tasks the teacher solved in all four harnesses, and SFT mixes with equal supervised tokens per harness.
<Accordion title="The Qwen3.5-2B runs, and what they taught us">
The runs
Qwen came first, trained with the correctness-only reward on an easier pool of 1,000 tasks (150 easy, 600 medium, 250 hard). It starts almost three times lower than LFM on the same test set, and the Qwen3.5 model card names no training harness.
<HtmlEmbed src="d3-train-results.html" config={{ view: "baselines" }} title="The two base models on the test set" desc="Pass@1 by harness before any training." frameless />
There were three Qwen runs, all evaluated on the same 1,000 test cells:
- Harbor multi-harness, rotating the four harnesses across GRPO groups.
- Harbor OpenCode-only, the same pipeline with one harness.
- Standalone OpenCode, OpenCode in its own environment outside Harbor, running in Daytona.
<HtmlEmbed src="d3-train-results.html" config={{ view: "curve", runs: ["qwen_harbor_opencode", "qwen_harbor_multi", "qwen_native_opencode"], note: "Top: all 1,000 test cells. Below: each harness. The standalone OpenCode run has its own measured baseline of 15.9%." }} title="Qwen3.5-2B pass@1 during training" desc="The three Qwen runs, trained with correctness as the only reward." frameless />
<HtmlEmbed src="d3-train-results.html" config={{ view: "train", runs: ["qwen_harbor_opencode", "qwen_harbor_multi", "qwen_native_opencode"] }} title="Qwen3.5-2B training curves" desc="Reward and tool calls at every optimizer step, with adjustable smoothing. For Qwen the reward is correctness." frameless />
Up, then down
All three improved at first, which showed that an unmodified harness can be trained through once you have the exact tokens. Multi-harness more than doubled, from 14.6% to 37.0% at step 500. OpenCode-only peaked at 39.5% at step 700. Then both fell back to about 26% by step 1,000. The standalone run rose more slowly and ended at its best, 29.8%.
The standalone run trained only in OpenCode, yet it gained about twice as much under Claude Code, Codex and Mini-SWE-Agent as under OpenCode.
Why the two Harbor runs declined
The two declines look different in the traces.
- Multi-harness ran out of output budget. Late in training, answers grew until they hit the 4,096-token output limit used in evaluation. Cells cut off at that limit rose from 9 to 556 of 1,000, often a long explanation where the calculation should have been. Training allowed responses up to 16,384 tokens, so the model learned a habit that evaluation cut short. Under OpenCode, calls per task collapsed from 16 to 3.
- OpenCode-only kept working without finishing. Calls per task rose from 17 to 21, and in the cells where submission was tracked, the share that submitted an answer fell from 69% to 41%.
- A resume bug replayed old tasks. After the multi-harness run restarted at step 684, almost every new rollout came from a task it had already seen. That changed its late training, but the decline started at step 500, before the restart, so the bug does not explain its start.
Tool calls without a bonus
With correctness as the only reward, tool calls per rollout in the Qwen OpenCode-only run doubled from about 10 to 20 during training, and the Qwen multi-harness run stayed between 11 and 16. In both LFM runs, which had the bonus, they fell.
<HtmlEmbed src="d3-train-results.html" config={{ view: "train", sel: 2, runs: ["qwen_harbor_opencode", "qwen_harbor_multi", "lfm_harbor_opencode", "lfm_harbor_multi"] }} title="Tool calls during training, Qwen and LFM" desc="Every optimizer step for the two Qwen runs, trained on correctness alone, and the two LFM runs, trained with the bonus." frameless />
Other things the Qwen runs showed
- Many steps taught nothing. Between 35% and 58% of optimizer steps had no reward contrast in any group, because all eight rollouts were right or all were wrong.
- Claude Code dominated the training data. Each harness got about a quarter of the rollouts, but Claude Code produced 77% of the training rows and 35% of the supervised tokens.
- SETA, a synchronous run in a plain bash environment with its own evaluator, went from 18.8% to 38.0% in 150 steps before we stopped it on purpose.
- Harder data did not rescue the decline. Continuing the multi-harness checkpoint from step 500 on 500 new hard tasks, on H200s through Hugging Face Jobs, did not recover the peak. Nearly two thirds of its steps had no reward contrast, and even counting every ungraded cell as correct, its final score could not reach its starting 37.0%.
What changed for LFM
The LFM setup changed three things. The reward gained the tool-call bonus, so all-correct groups still carry a signal and long, unfinished loops cost something. The training pool moved to medium and hard tasks. And the output cap was 4,096 tokens in both training and evaluation, so the model could not learn answers that evaluation would cut off.
Reproducing it
- SmolDataEnvs Multi-harness RL collection: everything below in one place, plus the base models.
- Trained models: LFM multi-harness RL and OpenCode-only RL at step 1,000, with the best checkpoints (steps 700 and 900) on
step-700andstep-900branches; LFM multi-harness SFT and OpenCode SFT after epoch 2; and the best Qwen checkpoints, multi-harness (step 500), OpenCode-only (step 700) and standalone OpenCode (step 1,000). - Training comparison dashboard: every training curve and checkpoint evaluation.
- Harbor environment and standalone OpenCode environment: the current companion environment servers. The standalone
opencode_envis deprecated since OpenEnv 0.7.0 and is retained for the historical comparison; new runs should use Harbor withharness="opencode". - SmolDataEnvs-multiharness-sft: the SFT data, per harness and pre-tokenized for LFM2.5-2.6B and Qwen3.5-2B, with a training script.
- Merged integrations: OpenEnv #1036 for the capture proxy and Harbor, OpenEnv #1280 for the typed
TrainingTraceAPI, and TRL #6947 for the worker. TRL's Harbor example shows the full trainer wiring; install TRL from main until that worker is released.
<Note variant="info" title="Bigger runs are coming"> Every run in this article uses a small model, 2 to 2.6 billion parameters, trained for 1,000 steps on a single seed. We are now setting up larger runs with bigger models on the same stack, and we will add the results here when they are in. Stay tuned. </Note>
Conclusions
Results compiled through 29 September 2026. Article updated 1 October 2026.
Multi-harness RL improved both task performance and tool use in our small-model experiments. On SmolDataEnvs, LFM2.5-2.6B went from 42.2% to 54.2% pass@1, with gains under all four harnesses: OpenCode, Claude Code, Codex and Mini-SWE-Agent. Training only in OpenCode also improved the model, including in other harnesses, but the multi-harness run spread its efficiency gains across all four. A small open model can learn to work better with several agent interfaces through the same training pipeline.
The tool-efficiency reward made the way an agent solves a task part of the training objective. Our earlier Qwen runs rewarded correctness alone, and some learned to make increasingly long sequences of tool calls. For LFM, we added a small bonus for correct solutions that used fewer calls. Tool calls fell during training. At the final checkpoint, the multi-harness model used 31% fewer tool calls on held-out tasks that both it and the base model solved, with savings under every harness. The bonus also gave GRPO a learning signal when all scorable rollouts in a group were correct but took different numbers of calls. Correctness remained essential: a wrong answer earned no efficiency bonus.
OpenEnv's capture proxy makes this practical without rewriting the harnesses or building a separate training loop for each one. With a compatible inference backend, it records the exact prompt and completion tokens, generation log probabilities and loss masks that training needs. Harbor supplies the tasks and sandboxes, and the same TRL trainer learns from the resulting traces. The harness keeps its own tools, context management and execution loop. Changing which harness produces the rollout does not require reimplementing those behaviours inside the trainer.
These are small experiments on one task family, with one seed per setup and unequal data and compute exposure. They support the gains over the base model, but do not establish a general ranking of harness mixes. RL produced larger accuracy gains than SFT in these runs; SFT also reduced tool use. We did not run LFM without the efficiency bonus, so its contribution cannot be separated from the other changes to the recipe.
The broader opportunity is to train for both successful answers and efficient execution across the interfaces people actually use. This work provides an open, working path to do that: keep the real harnesses, capture the evidence needed for learning, and improve the model through its own interactions with them.