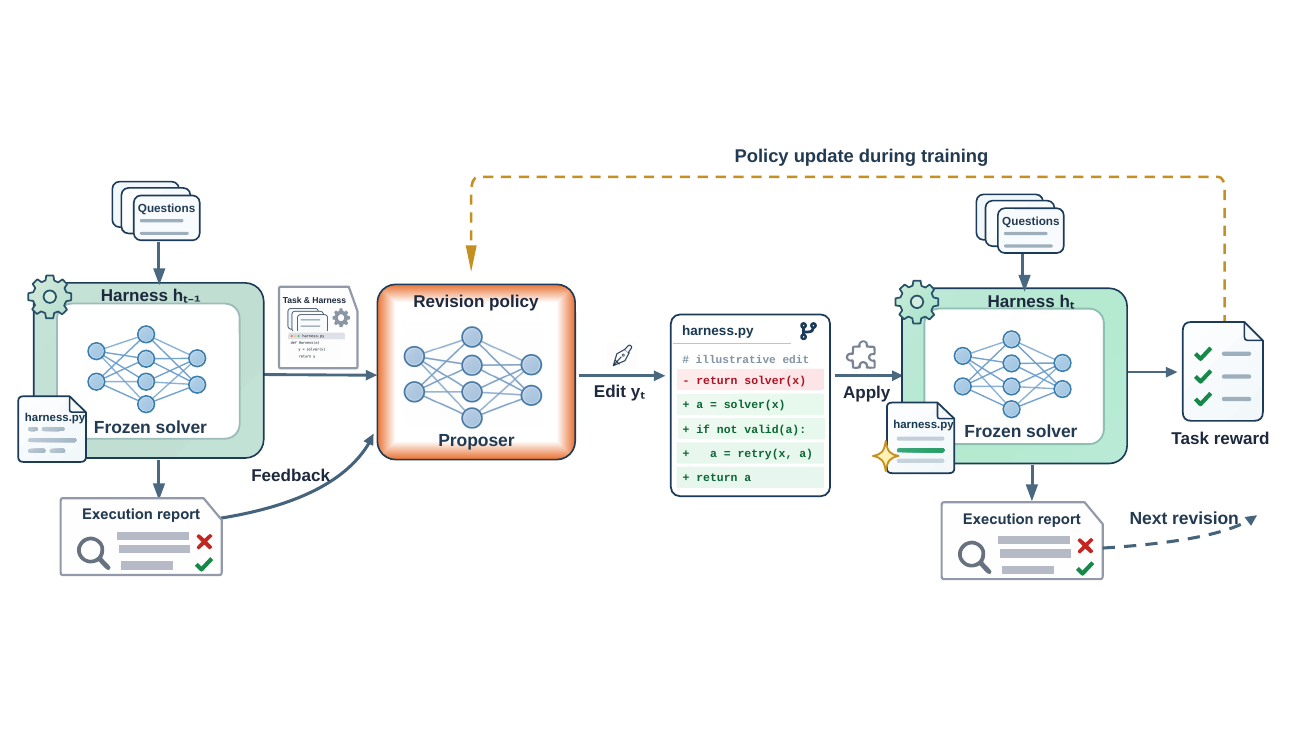
Harness Learning:让模型自己修改 Harness 的源代码适应新任务,打造自我进化的 Harness
一个模型负责解题,另一个模型根据任务反馈修改运行代码:该读哪些资料、何时继续搜索、怎样调用工具,都可以在测试时调整。
平时我们说“大模型智能体”(Agent),其实是由两部分拼起来的:
- 模型脑子(Solver / 求解器):LLM 本身,负责理解问题、做推理和生成回答。
- 外部脚手架(Harness / 运行框架):控制这个脑子怎么干活的 Python 代码,比如先调什么工具、怎么给提示词、拿到报错怎么重试,以及检索回来的文档怎么汇总。
痛点在哪? 传统微调模型需要更新权重,训练成本往往不低,遇到新任务时也很难实时调整。很多人会手动写一套 Prompt 链或工作流,但一旦换个任务,这套写好的流程就未必还适用,往往得重新调试。
来自约翰斯·霍普金斯大学(JHU)与卡耐基梅隆大学(CMU)的研究人员提出了 Harness Learning(脚手架学习 / 框架学习):让 AI Agent 在测试时不更新模型参数,通过修改自身的运行代码来适应新任务。
他们在论文 Harness Learning Enables Generalizable Test-Time Adaptation 中详细介绍了这套方法。
他们的解决方案:让大模型不改脑子,改“外衣代码”! 论文训练了一个叫 Proposer(提议者 / 代码修改器) 的模型。当 Agent 去跑一个新任务时,Proposer 会看运行日志——哪一步报错了、哪些用例答错了——然后修改 Harness 的 Python 源代码,比如加一层代码解释器循环、改写检索链路,或者加上答案校验。
改好的程序再运行,结果再变成下一轮修改的反馈。到了测试阶段,Solver 和 Proposer 的模型参数都保持固定,更新的是运行代码。
一轮修改是怎么进行的?
可以把这个过程理解成:先试跑,找到问题,再改流程,重新检验。 这里调整的是一类任务的运行程序,例如适合数独题的解题流程,而不只是为眼前一道题换一个答案。
- 跑一小批题。 用当前代码做一批有标准答案的题,记录调用过哪些工具、读到了什么资料、哪些答案错了,以及哪里报错。最开始使用的那版代码,论文称为“种子 Harness”,也就是起始程序。
- 把代码和报告交给修改模型。 Proposer 同时看到任务要求、当前 Python 代码和运行报告,再提出修改。推理实验用 SEARCH/REPLACE 补丁(找到一段旧代码,给出替换文本);问答实验则返回改好的 Python 程序。
- 重新跑题并打分。 系统应用修改,再运行评分题,检查新程序能否正常执行、答得怎么样。
- 挑选继续使用的版本。 不同实验的挑选规则见下文。
- 带着新报告继续改。 保留下来的程序再运行,新的结果成为下一轮反馈。
- 推理任务(Reasoning Gym): 每轮尝试 1 种改法,最多 5 轮。新版得分严格提高才换,否则继续用原版。
- 多跳问答(Multi-hop QA): 每轮尝试 8 种改法,最多 10 轮。选本轮能运行的最高分版本,即使比原版低;8 种全部失败才保留原版。
“学会改代码”和“正在改代码”发生在不同阶段。 训练时,研究人员更新 Proposer 的参数,让它学会怎样修改流程;遇到新任务时,它用已经学会的方法继续改代码,此时 Proposer 和 Solver 的参数都保持固定。
这种先学习“如何适应”,再把适应方法用到新任务上的做法,属于元学习(Meta-Learning)。这篇论文把适应过程中改变的对象放在可执行程序上,因此称为“可执行程序上的元学习”。
它具体会改哪些代码?
主要有三类改动:让回答模型读到更完整的资料、决定是否继续搜索、把计算交给 Python。 下面的图可以切换查看修改前后的流程。
同一个解题模型,换一种工作流程
选择一种修改,对照修改前后的工作流程。
修改前
修改后
摘要继续帮助“下一步搜什么”,原文负责“根据什么回答”。改的是信息去向;并不保证检索和答案一定正确。
查看这次修改的示意代码
# 逻辑示意,非论文原始代码或可直接运行的实现
- answer = answer_from_summaries(s1, s2)
+ answer = answer_from_passages(passages1 + passages2)
依据论文图 7、图 12 和第 6.2 节;计算循环是常见修订结构的概括,具体实现与调用次数各有差异。
回答时直接读原文,摘要只用来指导搜索
多跳问答,指的是要沿着线索查几次资料,才能拼出答案。“跳”可以理解为顺着上一步找到的线索,再搜一次。
举个示意例子:问“某位作家的出生城市属于哪个国家?”先查作家,找到出生城市,再查这个城市,找到所属国家。这就需要两次相互衔接的搜索。
起始程序的流程是:
第一次搜索 → 摘要和下一条搜索词 → 第二次搜索 → 摘要 → 根据两份摘要回答。
问题在于,摘要可能省掉答题需要的细节。比如第二次搜索的原文写了城市所属国家,摘要却只留下人口和地理位置,那么最终模型只看摘要,就拿不到国家这条信息。
Proposer 改出的办法是:摘要继续帮助确定“下一步搜什么”,但最终回答直接读取两次搜索得到的全部原文段落。 这样能减少最终回答时因摘要丢掉细节而产生的错误;前面的检索和关键词生成仍然要做好。
在三个问答基准中,经过单步强化学习训练的修改模型(Single-step RL),保留下来的程序有 84% 采用了这种直接读原文的结构;多步训练的模型为 69%,未经过本研究专门训练的基座模型为 47%。(每种方法统计 3 个基准 × 4 次运行 × 10 轮,共 120 个保留版本;84% 是程序结构的比例,不是答题准确率。两种训练方式后文会展开)
两次搜索不够时,再增加一次检索
论文还展示了两种增加搜索的改法:
- 固定多搜一次。 第二次搜索并整理资料之后,再生成第三条搜索词,搜第三次,最后结合收集的材料回答。这是其中一种修改结果,不是所有程序都固定搜索三次。
- 先写草稿,必要时再搜。 模型先给出一个草稿答案,Python 代码检查原文里有没有这段答案文字。如果出现,就输出;如果没有,就拿草稿答案作为关键词补搜,再根据新资料回答。
第二种改法增加了一条“要不要继续找资料”的判断规则。原文里出现答案文字,并不等于这个答案符合问题;这个检查只是决定是否补搜的条件。
让模型写解题代码,把运算交给 Python
在算术、数独、迷宫等推理任务中,起始程序只调用一次模型,让它直接给答案。修改后的程序则常常让模型写解题代码,再实际运行。
以“计算 1 到 10000 的平方和”这个示意任务为例:模型可以写出 sum(i*i for i in range(1, 10001)),由 Python 执行计算。这里有三方分工:
- Proposer 改运行流程: 给 Agent 加上“生成代码 → 运行 → 读取结果或报错 → 继续处理”的循环。
- Solver 写解题步骤: 面对具体题目,生成那道题需要的 Python 代码。
- 运行环境执行计算: 返回结果;如果报错,Harness 把错误信息交回 Solver,让它修改解题代码再试。
这就是解释器循环(Interpreter Loop)。改出来的是一套能处理题目的流程,而不是把某道题的答案写死。
在没有明确要求使用辅助工具的未见任务中,看过成功示范的模型(SFT)生成的程序,有 77% 采用解释器循环;强化学习后的模型为 78%。(这是生成程序结构的比例,不是答题正确率) 输入解析和解题代码仍须正确,执行代码所需的安全限制也要由系统提供。
怎么教会 Proposer 改代码?
可以把训练方式理解成两种学习方法:看别人怎么改,以及自己试改、根据成绩调整。
- 推理任务:先看示范,再自己试。 用 35B 教师模型生成的 432 个成功修改样例,教 Proposer 学习修改格式和做法。这一步叫监督微调(SFT)。随后让它自己提出修改、实际运行,根据成绩做强化学习(RL)。Proposer 和 Solver 分别使用 Qwen3.5-4B,教师为 Qwen3.6-35B-A3B。
- 多跳问答:直接自己试。 跳过教师示范阶段,直接在 HotpotQA 问答数据集上做强化学习。Proposer 使用 Qwen3-4B,Solver 使用 Qwen3-8B。
4B 表示约 40 亿参数,35B 表示约 350 亿参数。两类实验分别训练各自的修改模型;训练时也只更新 Proposer,负责解题的 Solver 始终固定。
给它看哪些题,又用哪些题检验修改?
可以类比学生做题:练习题帮助发现哪里不会,测验题检查练习后的水平,最后再用独立考试判断是否学会。论文中的题目也有三种用途:
- 练习题:诊断问题。 跑当前程序,生成报告,让 Proposer 看哪里报错、哪里答错。
- 测验题:挑选方案。 跑修改后的候选程序,打分,用于训练奖励或挑选版本。
- 独立考试题:检验效果。 不参与修改和筛选,最终测量程序在其他题上的成绩。
为什么要这样安排?只修好已经看到的错题,可能是针对几个用例做了特殊处理,也可能改坏了其他题。还需要用其他题检查,才能知道修改能否推广。
三种用途不一定对应三批不同的题。 训练时,两套实验把诊断题与评分题分开;遇到新任务、测试修改能力时,具体设置是:
- 推理任务: 每类任务用同一批 25 道题提供反馈,也用于挑选版本,另外 75 道题独立检验最终效果。
- 多跳问答: 从 500 道开发题中,每轮抽 6 道提供反馈,报告包含标准答案和支持答案的文档;同轮另抽 64 道不同题目给候选打分。约 300 道题独立检验最终效果。
因此,这里的“适应新任务”仍需要有标准答案、能打分的题目提供反馈,不能直接套用于完全没有答案和验证信号的任务。
怎样奖励一个有效的修改?
面对同一份任务要求、当前代码和运行报告,Proposer 一次生成 8 种改法。系统分别运行修改后的程序,全部用同一套评分题测验。
训练算法比较这 8 种改法的成绩:高于本组平均水平的修改,今后更容易被生成;低于平均水平的修改则受到抑制。这样反复训练,让 Proposer 更倾向于提出有效的修改。这种组内比较方法叫 GRPO。(组相对策略优化)
每种修改的奖励由两部分组成:
奖励 = 修改后程序的答题得分 + 程序能正常运行的奖励。
答题得分在 0 到 1 之间;推理题还可以获得评分器给出的部分分。程序能否正常运行,另有以下奖励:
- 推理任务: 修改格式能解析,奖励 0.05;修改能成功应用,再奖励 0.10;按测试运行完成的比例,最多再奖励 0.15。合计最多 0.30。
- 多跳问答: 代码能解析、定义了
run函数、不超过 200 行,并且完成评分运行,统一奖励 0.10;否则该候选奖励为 0。
“能跑通”和“答对了”是两回事。 一份程序即使拿满 0.30 的运行奖励,答案仍可能全错。推理实验中,失败的修改可能保留此前拿到的少量有效性奖励;两套实验的奖励都不会倒扣成负数。
换个没练过的任务,还能改好吗?
关键要看:它是否只学会了修训练题,还是能把修改方法用到新的任务类别上?研究分别检查了推理题和多跳问答,也比较了只改一次与连续修改的效果。
把 5 类更难的任务算进去,成绩会怎样?
让不同的修改模型改代码,再比较改好后程序的解题成绩。点击按钮,可以查看是否计入 5 类困难任务的差别。
4B 训练后修改模型领先教师 0.06;纳入全部任务后仍领先,但差距缩小。
主图剔除 knight_swap、letter_jumble、modulo_grid、sokoban、ab 五类困难任务。这里比较的是修改后的求解表现;两个修改模型使用同一冻结的 Solver。来源:论文图 3 / 9、表 9、附录 B.1。21 类 SFT 值为图上估读。
在主图的 21 类任务上,固定的 Python 工具循环得分为 0.69,高于学习修订的平均 0.62。起始程序只调用一次解题模型,工具循环最多允许五轮;这组结果没有证明学习修改胜过所有手工设计,或在相同成本下更强。
小修改模型,能超过大教师吗?
在 Reasoning Gym 推理评测中,修改模型训练时看过的任务类别与测试类别分开:示范训练用了 21 类,强化学习用了 5 类,两组有重叠;主要测试另外 21 类训练没用过的任务。(论文称为 OOD;指整类任务没用于修改模型的训练,不代表底层模型预训练时从没接触过相关知识)
上图比较的是不同模型改好代码后,程序的平均解题得分。分数在 0 到 1 之间,越高越好。
不改代码的起始程序(Seed)得分约 0.49;没有专门训练的修改模型(Base)改过后为 0.32;看过成功示范的模型(SFT)改过后约 0.49;做过强化学习的 4B 模型改过后为 0.62,35B 教师改过后为 0.56。(起始程序与 SFT 的约 0.49 为图表估读值)
这说明,改代码本身并不保证进步:没有专门训练的模型修改后,成绩反而从约 0.49 降到 0.32;经过强化学习,修改后的程序平均达到 0.62,超过教师修改后的 0.56。
这里比的是“谁平均改得更有效”,不是两款模型自身解题能力的全面比较。如果事后查看测试成绩,从每组 8 个候选中挑最好的一个,教师达到 0.85,4B 模型为 0.83,教师仍高一些。(这种知道测试成绩再挑最优的统计,称为 oracle;实际挑选版本用的是开发题成绩)
强化学习还减少了无法执行或得零分的修改。零分也可能来自“程序跑通、答案全错”,并不都代表代码崩溃。
还有一个值得注意的对照:人工写好的固定 Python 工具循环,平均得分为 0.69,高于学习后单次修改的 0.62。 它最多允许 Solver 进行 5 轮交互,而起始程序只有一次模型调用。这项研究说明修改能力可以学出来、可以迁移;这组成绩没有超过固定工具循环,也没有证明相同计算成本下更强。
主图排除了 5 类难任务。把它们加回来,全部 26 类任务上的平均分分别为:Base 0.282、SFT 0.415、4B RL 0.528、教师 0.501。4B 模型仍有平均优势,但差距缩小了。上面的图可以切换查看这两种统计范围。(排除的任务为 knight_swap、letter_jumble、modulo_grid、sokoban、ab)
只改一次效果平平,连续改十轮呢?
在多跳问答中,Proposer 只在 HotpotQA 上训练,然后用于没拿来训练的两个问答数据集:MuSiQue 和 2WikiMultihopQA。
先分清两种做法:
- 独立尝试 80 次: 每次都从同一份起始代码改,得到 80 个单步修改方案。
- 连续接力 10 轮: 每轮提出 8 种改法,用开发题选一版,下一轮接着这版代码和新的报告继续改。
结果如下。问答的得分是答案匹配率(EM):将答案文字规范化后,与标准答案比较;MuSiQue 和 2Wiki 也接受列出的答案别名。(与前面的推理任务评分规则不同,不宜直接比较两类任务的分数高低)
| 怎样修改? | MuSiQue | 2WikiMultihopQA |
|---|---|---|
| 不修改,使用起始程序 | 0.1438 | 0.2500 |
| 80 个独立修改的平均分 | 0.1467 | 0.3090 |
| 事后从这 80 个里挑出的最好成绩 | 0.2408 | 0.5200 |
| 10 轮接力后的平均分 | 约 0.27 | 约 0.55 |
(单步数据来自表 23;十轮结果为 4 次运行的最终均值,其中 2Wiki 的约 0.55 为曲线估读值)
MuSiQue 上,起始程序为 0.1438,只改一步的平均成绩为 0.1467,几乎不变;连续改十轮却提高到约 0.27。2Wiki 上,起始程序为 0.2500,单步修改的平均分为 0.3090,其中 67.5% 的方案超过起始程序;十轮后的均值进一步达到约 0.55。
表中的“事后最好成绩”是看过最终测试成绩后,回头挑出最高分程序;它表示这批方案中出现过多好的结果。实际使用时没有最终测试答案可看,选版本只能依靠开发题反馈。
沿着反馈接力修改有价值,但比较还要看用掉了什么。 每次十轮运行提出 8 × 10 = 80 个方案,做 4 次共 320 个;独立尝试的方案池有 80 个。每次运行的方案数相同,得到的反馈和执行过程却不同,实验没有把总体计算开销匹配起来。
此外,搜索都发生在给定的资料库里:HotpotQA 使用 523 万条维基百科摘要,MuSiQue 使用 21,100 个段落,2Wiki 使用 54,957 个段落。这里检验的是在这些资料库中搜索和回答的能力。
测试时改很多轮,训练也必须练很多轮吗?
单步训练,是让模型学习“看当前代码和报告,怎样完成一次有效修改”;测试时,这个办法可以反复应用。好比学会修眼前的一处问题后,再读新的报错,接着修下一处。(单步不等于训练输入只有起始代码:推理实验也用了更强的已有程序版本)
多步训练,则把连续修改中产生的新版本也用作训练输入,让模型练习处理自己之前改过的代码。
实验中,多步训练没有稳定胜过单步训练:
- 多跳问答的十轮最终成绩很接近:HotpotQA 约 0.62、MuSiQue 约 0.27、2Wiki 约 0.55。
- 推理任务中,多步训练在标准格式题目上略高,在换了题目表达格式的测试中略低。
因此,只训练一次修改的能力,也能在测试时连续修改多轮。 两种训练都按当前这次修改的成绩给奖励,还没有把整条修改链最终的收益分配给前面的改动;学习长期收益是否会改变结果,还需要检验。
算法写对了,为什么还是答错?
改好解题算法只是其中一环,运行代码还要把题目、工具和答案接起来。
把题目读对、工具叫起来、结果交回去
研究人员还尝试通过“组合指令”,要求修改模型编写迷宫找路、解数独、找质数等专用程序,再把它们接入 Agent 的工具流程。
检查 32 个候选程序后发现:12 个把辅助算法接进了工具流程,但只有 3 个让辅助算法实际参与了最终答案的生成。(这里统计工具是否贡献了答案,不代表这 3 个程序的得分一定提高)
为什么代码里有算法,却帮不上忙?论文记录了三种实际故障:
- 把题读给算法时出错: 解析代码漏掉题目的目标标记,无法把任务正确交给算法,退回普通模型调用。
- 把工具叫起来时出错: 工具调用消息格式错误,工具无法执行。
- 把结果交回去时出错: 最终提交的仍是尚未解出的数独网格,答案不完整。
所以,“写出一个解题程序”和“让 Agent 真正用它答对题”,中间还有输入解析、工具调用、结果提取三道关。
为什么有些任务改一轮就进步,后面却停住了?
推理任务的成绩较早停止增长;在换了表达格式的题目上,单步训练模型的大部分进步发生在第一轮。多跳问答则在十轮中继续进步,第一轮只贡献了总提升的三分之一到三分之二。
起始流程可能是部分原因:推理题从“一次调用直接答题”开始,第一轮加上计算工具,已经完成一项较大的改变;问答从两次搜索开始,后续还可以继续调整原文怎么传、是否多搜一次、什么情况下重试。
不过,两类实验的训练和版本挑选规则也不同。这个解释还不能单独证明,为什么一种任务较快停住,另一种能继续提高。
距离持续学习,还缺什么?
教模型构建和修改运行框架,已经有 Harness-R1、JIT-Agent、Ornith 等相关探索。这篇论文进一步展示:训练出来的代码修改方法,可以用于没拿来训练的任务类别,并通过多轮反馈继续调整。
要让它成为能长期积累经验的 Agent,还有几件事要解决:
- 自己决定怎么调试。 当前实验由外部系统整理代码和运行报告交给 Proposer;下一步可以让它自己检查代码、选择测试、比较修改方案。
- 找到没有标准答案时的验证办法。 目前判断答错与否、选择代码版本,都依赖有标准答案的开发题。实际业务中很多任务没有现成答案,需要其他可靠的检验信号。
- 检验经验能否长期保留。 目前展示的是一类任务中几轮到十轮的调整,还没有检验连续面对很多不同任务时,修改经验能否积累、旧能力会不会退化。
- 探索两个模型一起训练。 当前 Solver 固定,研究只训练 Proposer;联合训练能否让解题能力与流程设计相互促进,仍是下一步的问题。
对 Agent 开发者来说,这项研究提供了一条可尝试的路:除了训练模型答题,还可以训练它根据运行结果修改工具使用和信息传递的流程。这里已经展示了跨任务适应的效果;自主调试和长期经验积累,还需要进一步验证。
Harness Learning:不改大模型脑子,靠改运行代码让 Agent 自适应新任务
日常我们所说的“大模型智能体”(Agent),本质上是由两个截然不同的组件拼合而成的:负责理解问题与推理生成的模型脑子(Solver),以及包裹在脑子外层、用 Python 编写的外部脚手架(Harness)——后者负责工具调用顺序、提示词编排、错误捕获与多轮检索聚合。
面对未见过的全新任务时,传统方案常陷入两难:直接微调模型权重成本高昂且难以实时调整;若改用人工手写工作流,换了任务可能需要重新调试。来自 JHU 与 CMU 的研究团队提出了 Harness Learning(脚手架学习):在测试阶段完全冻结模型权重,只对外部脚手架源代码做元学习迭代。
训练时,研究人员更新 Proposer 的参数,让它学会怎样修改流程;遇到新任务时,它用已经学会的方法继续改代码,此时 Proposer 和 Solver 的参数都保持固定。
↻ 本轮选出的程序再试跑 → 新报告回到 STEP 02,继续修改。
Proposer 改出的程序中,常见以下三类流程调整:
学到的修改方法可以用于未拿来训练的任务;问答任务中,连续改十轮的结果更好:
两组问答结果:MuSiQue 上,起始程序为 0.1438,只改一步的平均成绩为 0.1467,几乎不变;连续改十轮却提高到约 0.27。2Wiki 上,起始程序为 0.2500,单步修改的平均分为 0.3090,其中 67.5% 的方案超过起始程序;十轮后的均值进一步达到约 0.55。
对照也要保留:固定的手工 Python 工具循环在这 21 类任务上得分为 0.69,高于单步修改均值 0.62;它最多允许 5 轮模型交互。问答接力每次 80 个候选,4 次共 320 个,独立方案池为 80 个,反馈和总体计算开销没有匹配。84% 与 78% 是程序结构比例,不是答题准确率。
更关键的发现是:单步训练的模型,也能在测试时连续改多轮。只需教会模型“读懂当前报错、做出一次有效改动”,该能力就能在测试期被反复循环复用,本实验中,多步训练没有稳定胜过单步训练。
工程断点警示:代码里有算法,不等于 Agent 能答对题。
检查 32 个候选程序后发现:12 个把辅助算法接进了工具流程,但只有 3 个让辅助算法实际参与了最终答案的生成。
走向长期持续学习,这套方案还面临哪些未解约束?
1. 高度依赖带标准答案的开发题:目前诊断答错与否、挑选程序版本,都依赖有标准答案的开发题,无法直接落地于缺乏验证信号的完全开放式任务;
2. 外部编排介入:当前实验由外部系统整理代码和运行报告交给 Proposer;下一步可以让它自己检查代码、选择测试、比较修改方案。
3. 跨任务长期经验积累仍待检验:目前展示的是单一任务类别的数轮修补,当智能体连续面对许多不同任务时,已有修改经验能否长效保持、已有能力是否会退化,仍是待解难题。