
为什么在 AI 泛滥的时代,最终赢家依然大概率是 OpenAI?
模型会被追平,API 流量也会搬家。David George 仍然看好 OpenAI,因为它最擅长让人形成新的 AI 使用习惯,再从海量真实需求中找出下一步该造什么。
如果各家的模型都会变强,今天的第一名明天就可能被追上,那么 OpenAI 凭什么长期赢?
a16z 合伙人 David George 给出的答案,不是模型、芯片,也不是谁的 Token 更便宜。他看好 OpenAI,是因为它同时擅长两件更难复制的事:先让人形成一种以前没有的 AI 使用习惯,再把这种习惯推向足够多的人。
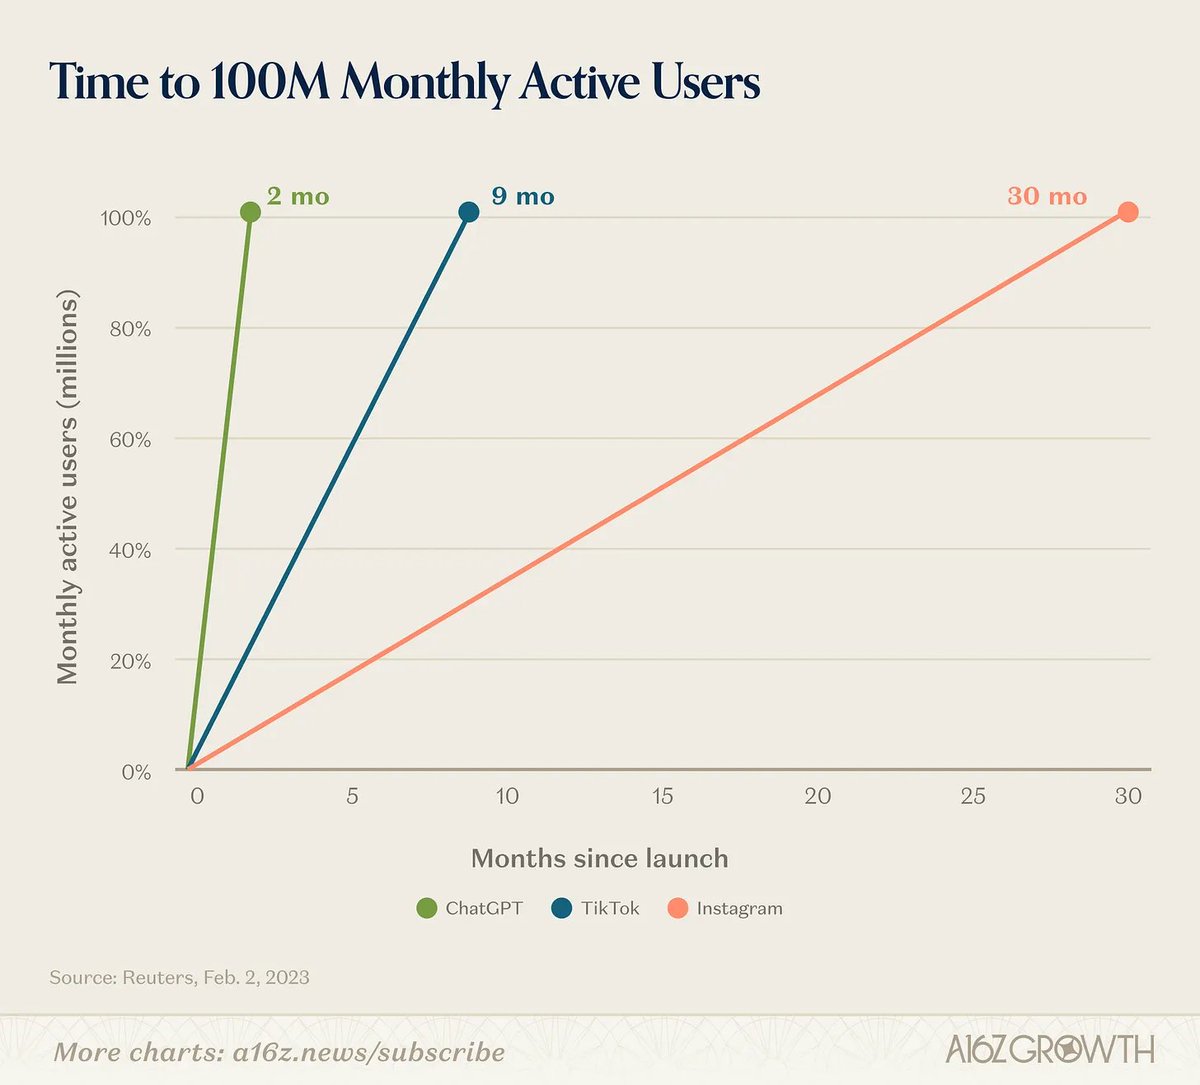
ChatGPT 就是最典型的例子。它不是把已有的聊天机器人做得更好,而是让普通人第一次习惯了这样解决问题:不必先找软件、学菜单、想关键词,只要在一个空白框里直接说自己想要什么。
这篇文章最重要的地方,是把 AI 竞争的因果关系倒了过来。通常我们以为,模型更强,所以用户更多。David George 的判断是:将来可能恰好相反——因为 OpenAI 接触的用户最多、问题最杂,它才更容易知道下一代模型和产品应该补什么。 用户越多,它越会造;越会造,又会吸引更多用户。

前沿 AI 公司要把领先变成长期优势,有四种办法
- 创造以前没有的使用行为。
- 把产品分发给大量用户。
- 找到能把价值变成收入的定价方式。
- 建立让客户不愿意换走的迁移成本。
他先把第 4 项——让客户难以换走——大幅打了折扣,范围是模型 API 层。开发者可以让 Claude 写代码、用 GPT 做分析,再给批处理任务接入更便宜的模型,甚至按每项任务选择供应商。接入和评测仍有成本,但通常不必因为换一个模型就推倒整个产品。各家的模型又都在进步,很难指望一次领先就让客户长期留下来。至于产品、协作关系和平台层能否形成迁移成本,原文把它留作尚未解决的问题。
文中援引的一组 OpenRouter 市场份额变化,也显示 OpenAI 与 Anthropic 的调用份额可以在短时间内大幅翻转。它不能单独证明用户没有忠诚度,但至少说明一件事:调用量不等于牢固的客户关系。价格或性能一变,流量就可能搬家。
再看第三项:把价格降下来。便宜当然重要,但各家都在用规模效应、垂直整合和自研芯片压低 Token 成本。David George 的判断是,最后能做到最好价格性能比的,很可能本来就是规模最大的公司。因此,“便宜”更像赢得规模之后得到的奖励,而不是最初赢下市场的原因。
因此,第 4 项在模型层很难守住;第 3 项仍重要,却更像赢得规模后的结果。David George 把决定长期差距的关键放在前两项:
- 创造新行为:让人开始用 AI 做以前不会做、也没想到能做的事。
- 建立分发:把这种新行为送到更多人手里,并不断看见他们接下来还想做什么。
后面的整套论证,其实都在解释这两件事为什么会互相强化。
“创造客户”不是找客户,而是创造一种新习惯
ChatGPT 刚上线时,OpenAI 内部并没有把它当成注定成功的消费产品。Sam Altman 后来回忆,产品虽然增长很快,不少人仍觉得大家只是图新鲜聊几句:“这很好玩,但聊天机器人总不能就是我们真正要做的产品吧?”团队甚至讨论过继续寻找别的方向。
彼得·蒂尔看到的却不是一个聊天玩具,而是一种刚刚诞生的客户。他提醒 Altman:这就是产品。那个空白对话框和 Google 搜索框一样,表面上几乎什么都没有,却允许任何人带着自己的问题走进来。
这里的“创造客户”,不是把原本属于竞争对手的人抢过来,而是让一个从前不会购买、甚至不知道自己有这种需求的人,开始形成新的习惯。
在 ChatGPT 之前,一个普通人想分析文件、改一段代码或起草合同,往往要先知道该找什么软件,再学习软件的用法。ChatGPT 改变了这个起点:人可以先说目标,再让 AI 想办法。被创造出来的不是一个账号,而是“先问 AI”这种行为。

OpenAI 后来的几次重要突破,也有同样的味道:聊天界面、推理、工具调用、电脑操作。它们事后看都简单得像“本来就该这样”,但真正困难的是在所有可能方向里,提前认出哪一种简单形式会让人反复使用。
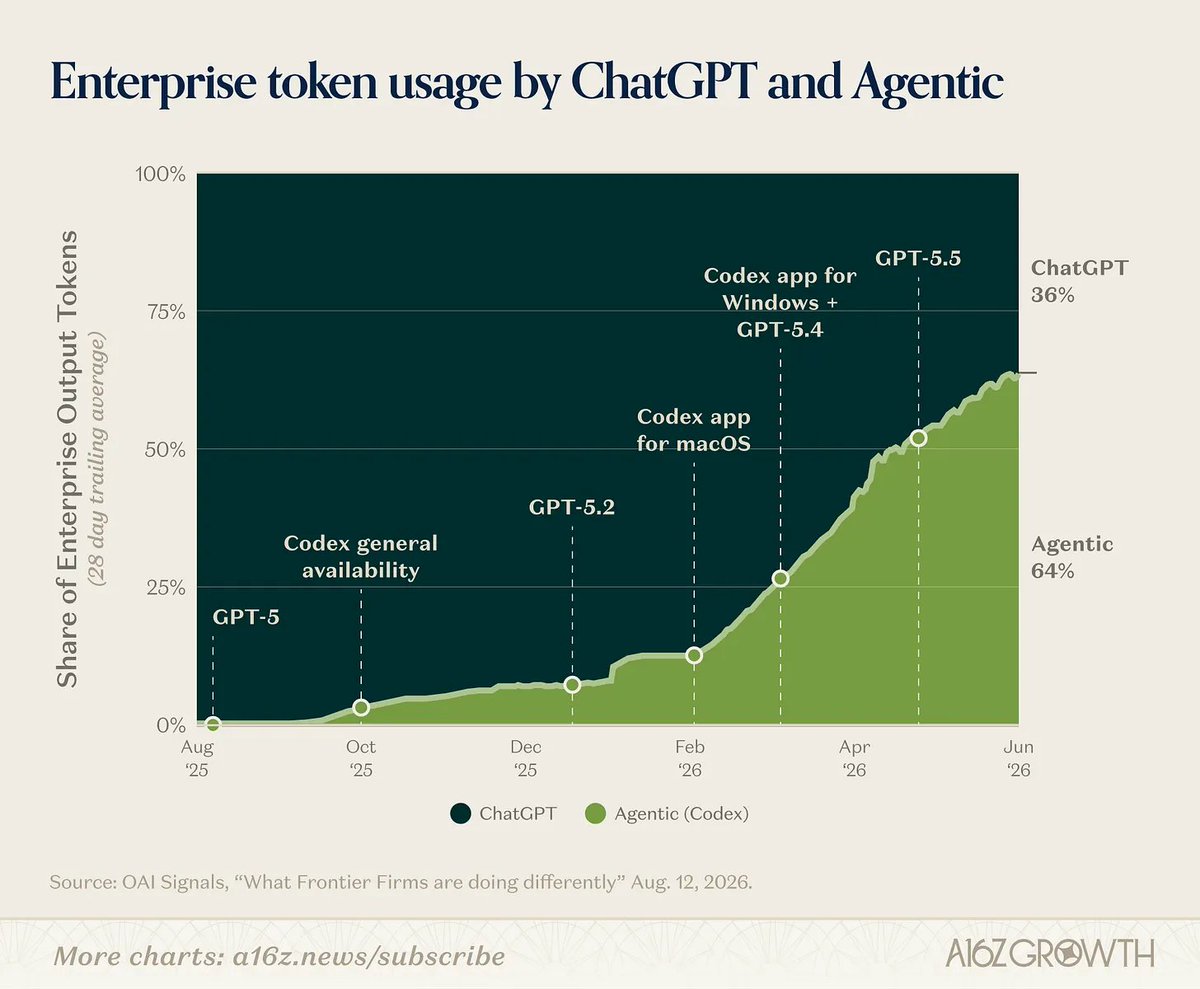
聊天界面让人能直接表达目标;推理让模型先想再答;工具调用让回答变成行动;电脑操作又让 AI 能处理那些没有专门接口的软件。每一步都不是单纯把跑分提高一点,而是在打开一种新的使用方式。编程是主要例外,OpenAI 并不是最早找到突破形态的公司,但后来追了上来。
David George 把这种“总能找到下一步”的能力,归结为三个条件:
- 它不替用户预先决定一切。 用户不只是点一个固定功能,而是能在安全边界内告诉系统自己究竟想完成什么。
- 它控制的技术层足够深。 从模型、工具、代码执行到芯片,控制的环节越多,新需求出现时,越有可能把缺失的能力补进整套系统。
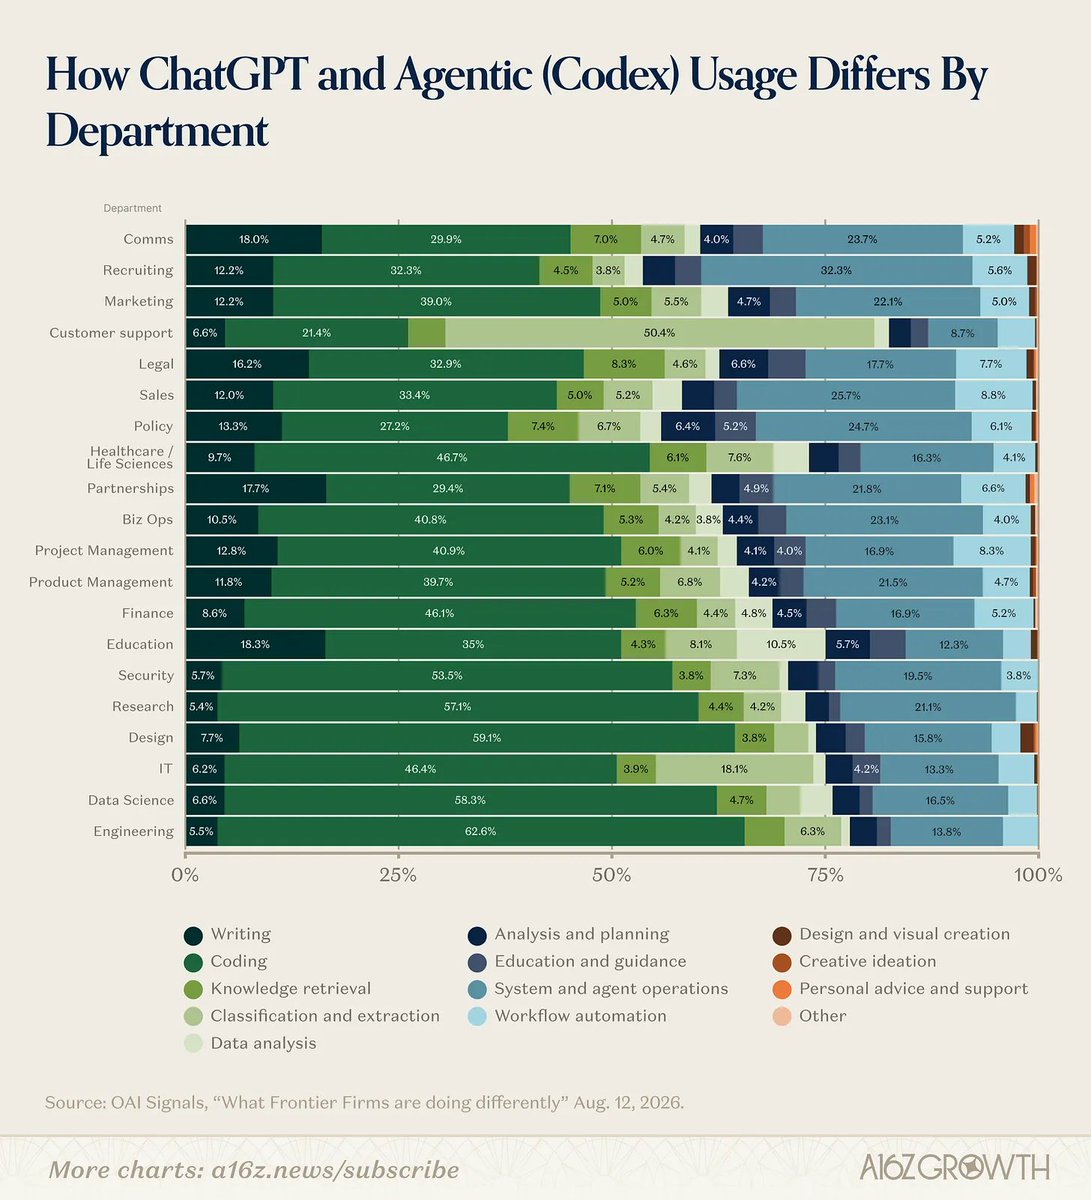
- 它看到的用户足够杂。 普通消费者、专业用户和企业每天拿 AI 处理完全不同的问题,这让 OpenAI 更早看到哪些麻烦会反复出现。
第三点尤其重要。做报销软件,只要理解报销;做客服软件,只要理解客服。但通用 AI 面对的不是一个流程,而是无数个无法提前列完的目标。没有足够宽的用户面,公司连大家反复卡在哪里都看不到,更谈不上决定下一步该造什么。
所以,分发不是卖得更多,而是看得更多
平常说“分发”,很容易想到广告、渠道和预装:同一个产品,想办法卖给更多人。但在这篇文章里,分发还有第二层作用:它让公司看到更多真实问题,知道下一步该造什么。
OpenAI 同时接触普通消费者、高频专业用户和企业。有人让它写东西,有人拿它处理数据,有人修代码,有人给客服工单分类。单个需求看上去很零碎,数量足够多以后,重复出现的缺口就会浮出来:很多任务需要长期记忆,很多工作必须操作电脑,复杂流程需要安全地运行代码,团队任务又需要多个人和 Agent 协作。

公司把这些反复出现的需求做成可以重复使用的基础能力。技术上常把它们叫作“原语”(Primitives),但可以把它理解成乐高积木:它不是一套完整的客服或财务软件,而是一块“记住上下文”、一块“操作电脑”、一块“安全执行代码”。开发者可以拿这些积木,组合出 OpenAI 自己从未设想过的产品。
于是,一个飞轮开始转动:用户越多,OpenAI 看见的问题越多;重复的问题越清楚,它越容易做出通用积木;积木越丰富,外部开发者越能创造新应用;新应用再带来更多用户。
这里说的“学习”,不是说 OpenAI 可以任意拿客户的私有数据训练模型,而是说它能从广泛使用中看见需求的形状:大家不断想做什么、经常卡在哪一步、哪些能力值得变成产品的一部分。
分发为什么会反过来改造产品
消费者、专业用户和企业带来不同工作流。
同一个麻烦在不同场景里重复出现。
把重复模式做成记忆、工具、权限、运行环境等基础能力。
新应用带来新行为,再把新用户送回循环。
分发的价值,是让反复出现的需求更早被看见,再变成可以复用的产品能力。
触达用户有三条路,只有一条会越走越宽
一家 AI 公司想进入更多场景,通常有三条路:自己做产品、借合作伙伴进入别人的产品,或者把自己变成平台。三条路都能带来调用量,区别在于:最后是谁面对用户,谁能听见用户真正想做什么。
| 路径 | 最大优势 | 主要代价 | 谁掌握需求 |
|---|---|---|---|
| 独立产品 | 从入口到日常使用都由自己设计,可以直接看用户怎么做 | 公司自己要承担完整产品复杂度 | 产品公司 |
| 合作伙伴 | 能很快进入大量场景和用户 | 合作方拥有界面、品牌和客户关系,也更可能拿走经济价值 | 合作方 |
| 平台 | 外部开发者能做出公司没想到的用法,形成更大的需求地图 | 起步慢,必须投资安全、权限、数据结构、运行环境和开发工具 | 平台与外部创建者共同拓展 |
合作伙伴是最快的一条路。模型接进办公软件、手机或企业系统,立刻就能触达大量用户。但用户记住的往往是合作伙伴的品牌,界面、收费和客户关系也掌握在合作伙伴手里。模型公司得到了调用量,却可能不知道用户为什么发起这次调用,更难把需求沉淀成自己的产品能力。
平台走得最慢。公司不仅要提供模型,还得建设开发工具、权限、安全、数据和运行环境,短期赚到的钱也未必最多。可是一旦别人能够在平台上自由构建,成千上万的开发者就会替平台探索需求。平台不必亲自猜中每个垂直产品,也能从整个生态里看到市场往哪里走。
所以 David George 更看重平台路线。合作是借别人的入口获得流量;平台是让别人进入你的环境创造新东西。前者扩大覆盖,后者既扩大覆盖,也扩大了发现新需求的能力。
但开放一个 API,还不能叫“真平台”
“平台”这个词很容易被滥用。提供一个 API,让别人能调用模型,当然算开放能力,但离 iOS 或 AWS 那样的真正平台还很远。
原文借用 Marc Andreessen 的分类,把技术平台分成三层。注意,这不是上一节的三条商业路线,而是在回答另一个问题:外部开发者究竟能在你的系统里做到多深?
- Type 1:给你一个 API。 平台只把能力递出来,代码、数据库、服务器、网络和安全都要开发者自己准备。平台方最省事,开发者负担最重。
- Type 2:允许安装插件。 核心产品先满足大多数需求,外部开发者再补上特殊功能,就像给现成的软件装扩展。
- Type 3:直接提供运行环境。 开发者可以在平台给定的计算、存储、权限和安全边界里,真正写出并运行一套系统。iOS、AWS、Ethereum 和 Cloudflare 都属于这一层。
Type 3 的关键,不是功能更多,而是平台替开发者承担了最难、最通用的那一层。做一个手机应用,不需要自己造手机操作系统;部署一个云服务,也不需要自己修数据中心。同样,做一个 AI Agent,如果还得从头解决代码在哪运行、能读什么数据、失败后如何回滚、越权时怎样阻止,它就很难普及。
模型本身只能完成其中一部分。用户写提示词,模型执行指令,看起来已经很像一种运行环境;可模型之间容易替换,真正难搬走的是它外面的整套设施:工具、数据、代码执行、权限和安全规则。David George 认为,这一层才可能成为 OpenAI 更持久的壁垒。
Agent 为什么不能只会“点工具”,还得会临场写代码
假设你让 Agent 从几十份表格里找出异常订单,按照不同条件分类,再生成一封给每位客户的邮件。平台开发者不可能提前为这种临时任务设计一个专用按钮。
Agent 可以一步步调用“读文件”“筛选数据”“写邮件”等工具,但链条一长,它就容易漏掉条件、重复操作,或者忘记前一步发生了什么。更稳的做法,往往是先写一个小程序:把步骤、判断和循环一次写清楚,再运行、检查结果,有错就只改出错的部分。
这就是为什么代码对通用 Agent 很重要。它能表达平台开发者没预先想到的目标,还能让复杂过程被重复、检查和修改。代码在这里不是只给程序员用的产品功能,而是 Agent 组织复杂工作的方式。
可是,让模型“会写代码”只是起点。平台还得回答一连串麻烦问题:代码能读取哪些文件?能调用哪些工具?可以把结果发给谁?运行失败怎么恢复?准备付款或删除数据时,是否要停下来等人批准?
这就是 Type 3 最重的地方,也是它最有可能形成壁垒的地方。真正可用的 Agent 平台,不只是一个聪明模型,而是一套让模型能够安全行动的操作系统。

最大的市场,不是抢来的,而是被唤醒的
假设 A 模型降价,用户从 B 模型切到 A。A 的市场份额上升了,但整个 AI 市场并没有多出一个新用户,这只是把已有需求从一家搬到了另一家。经济学把这种变化叫作“替代弹性”。
真正更大的机会是:模型变便宜、变聪明、变好用以后,人们会不会开始做以前根本不会做的事?例如,一个从不写程序的人开始让 AI 做自己的小工具,一家从未自动化的公司开始把多步知识工作交给 Agent。这叫“总需求弹性”——不是重新分蛋糕,而是让蛋糕本身变大。
所以,短期最显眼的数字可能是谁抢走了谁的 API 流量;长期更重要的问题却是,谁让最多原本不用 AI 的人开始使用,谁又让现有用户不断把新的事情交给 AI。ChatGPT 的空白对话框创造过一次这样的市场,David George 押注 OpenAI 还能继续做到。
不是因为强所以用户多,而是用户多所以继续变强
现在可以把前面的链条接起来了。
常见的解释是:OpenAI 先有了好模型、足够算力和优秀产品,所以拿到了大量用户。David George 把箭头反了过来:OpenAI 以后之所以还能做出好模型、好产品和更好的价格性能比,可能正是因为它已经拥有大量而且多样的用户。
完整的循环是:
- 更多用户带来更多种真实问题。
- 重复出现的问题,暴露出系统缺少哪些通用能力。
- OpenAI 把这些能力做成模型、工具和平台的一部分。
- 更好用的产品吸引更多用户,也让外部开发者创造更多应用。
- 更大的规模支持它继续投资算力、芯片和完整技术栈,进一步降低成本。
在这套逻辑里,模型、芯片和成本当然仍然重要。只是它们不再是故事的第一块多米诺骨牌;最前面的那一块,是分发带来的用户和需求。

这也是全文最大胆、最需要保留距离的一步。现有数据能看到 ChatGPT 扩散很快、同一种通用 AI 已进入多种工作流、Agent 使用占比正在上升;但这些现象还不能证明“广泛分发一定会造出更好的模型和芯片”。这是一套解释 OpenAI 未来优势的投资判断,不是一条已经验证的商业定律。
这套判断真正改变的,是你该盯着什么
第一,别把选中一次最强模型,当成完整的产品策略。 模型当然重要,但榜单第一会变。更持久的问题是:你的产品有没有让用户开始做一件以前不会做的事?
第二,一百万次调用,不一定等于一百万份用户理解。 如果调用全部来自合作伙伴,你可能只看见请求,看不见请求背后的目标。除了问“有多少流量”,还要问“谁直接面对用户,谁能看见原始需求”。
第三,平台不是把 API 改个名字。 如果外部人真的能在你的系统上做出你没想到的东西,你就必须替他们解决代码运行、数据访问、权限、安全和失败恢复。平台的护城河,恰恰藏在这些不吸睛的重工程里。
第四,比抢别人已有的用户更大的机会,是唤醒还不存在的需求。 让旧工作更便宜依然有价值;让人开始做以前不会、不想或不值得做的事,才是在创造客户。
Sam Altman 对未来产品形态的想象,可以压缩成两个入口:会主动定义目标的人,可以让系统直接做出自己想要的程序和工具;不知道该构建什么的人,也可以只打开 ChatGPT,用一句话开始。
这两个入口服务的其实是同一件事:降低“我该怎样使用 AI”的门槛。今天,少数深度用户已经把 AI 放进生活和工作的每个角落;更多人仍只在少数场景里偶尔打开一次。真正巨大的市场,还没有完全醒来。
因此,这篇文章真正押注的不是“OpenAI 永远拥有最强模型”,而是另一件事:当智能逐渐变得充足,最稀缺的能力会变成发现人们下一步想做什么,让更多人真的开始做,再把这些需求沉淀成一个不断增强的平台。
OpenAI 未必一定赢。但在 David George 看来,它目前最接近同时掌握这三步:创造行为、获得分发、再用分发继续改进平台。这才是他认为 OpenAI 的领先比一次模型跑分更难追的原因。
OpenAI Understands Something Important and Rare
OpenAI understands something special and rare, hiding in plain sight. Which is, as Peter Drucker put it a half century ago, the purpose of a business is to create a customer.
OpenAI is not going to win because they have the best models, or the most advanced chips, or the best cost-performance curve, or even the best product, although we think they do have those things. We think that OpenAI will win because they are so good at creating new kinds of customers, and because they have the most durable distribution strategy.
As we write this in September 2026, the intelligence-as-a-service product rankings aren’t the most important question anymore. Intelligence is everywhere. Anyone can do nearly anything; but most people aren’t, yet. Can you awaken the new behavior, and can you win at distribution, are what matters.

The case for OpenAI comes down to the following argument. To build a durable business at AI frontier scale, there are four levers you can pull:
- Create new kinds of behavior
- Distribute to lots of users
- Price your product in a way that captures value
- Have high switching costs
4 is basically out. The AI Frontier is a Red Queen’s Race, at least at the model layer. It’s so easy to swap between models, down to task-by-task switching, and everyone’s getting better all the time.
3 is what everyone hopes to achieve. But again, it’s a very competitive world out there & OpenAI (and others) are determined to lead at the cost-compute frontier, and pursue it via economics of scale, vertical integration, and other strategies to get token costs down. Whoever ends up leading on price-to-performance is going to be whoever’s winning at scale anyway.
Which means it comes down to 1 and 2. We think OpenAI is clearly the best at 1:
- They have a well-established track record in AI of finding the simple, obvious-in-hindsight breakthroughs that unlock new kinds of consumption behavior
And they’re also the best at 2:
- Every AI lab right now is trying to speedrun distribution, beyond their first-party products. And there are two ways you can do that: as a platform, or through partnerships. Doing it as a true platform is long-term preferable: the revenue comes a bit slower, but it’s much more durable and valuable when you get it.
There is an underlying reason why OpenAI is prevailing at 1 and 2, which is that they have some of the broadest and most well-rounded general intelligence, not only in their models but in their company and in their customer base. They are exposed to the broadest user base (across consumers, prosumers and enterprise), they have the deepest self-improving tech stack (down to their proprietary chips), and that’s why they consistently find the new patterns and primitives that work. They are taking the long view for how to build the winning AI platform, and it’s working.
OpenAI is really good at discovering the next thing
OpenAI did not set out to be a consumer company. They kind of fell into it by chance, with the release of ChatGPT. It’s a happy accident they did, because that moment is one of the turning points in technological history. Had they not done this, the world would look very different. AI would probably still be guarded in the hands of labs and close customers, it wouldn’t be improving at nearly the rate that it is, and we’d be in a “default closed” timeline, and not the infinitely richer one we have today.
Sam Altman recently told a story about the weeks after the release of ChatGPT, when most people at OpenAI had the attitude, “Well this was fun, but we should probably move on to building some real products. A chatbot can’t be it, can it?” It was specifically Peter Thiel who counseled Sam, no, this is it. You have created a new kind of customer. Nothing else is as important as this.
It’s not just ChatGPT, either: OpenAI deserves credit for being generally good at finding the breakthrough patterns and primitives that really matter, and awakening new kinds of user behavior. Ben Hylak articulated it well in a piece the other day: “OpenAI is the (mostly) undefeated king of finding the ‘next thing’. It’s always a lot simpler than you’d think and very obvious in hindsight.” The GPT chat interface, reasoning, tool calling, and Computer Use were all big breakthroughs that simplified and focused the direction of the technology, and made it usable. The one major exception where OpenAI was not the breakthrough leader was coding, and they caught up just fine.
Why are they so good at this? Perhaps in the early years they just had that special sauce; no one can exactly articulate the founding energy and magic that creates something like this. But over time, this has clearly become a skill they have cultivated. There are three critical inputs here:
- They think and act like a company that wants to be a platform. “Platform” is a loaded term and we’ll get into it in detail in a second, but this is a company that actually believes its users are smart, and can make their own choices, within carefully crafted constraints.
- They’re doubling down on technical depth, meaning they’re trying to own or control every layer deep into their stack, and continually refine the platform primitives their users need as building blocks.
- Maybe most of all, they have tremendous consumer breadth. They remain the leader in sheer variety of kinds of consumers and use cases across people’s personal and work lives.
The breadth of people using them is the most underrated factor here. As Hylak puts it simply: “Computer use” [for example] is a very generic, and unspecific thing. To be better at it, you need to increase your intelligence in a general way. Across many domains, across many workflows.” People consistently underestimate how difficult it is to go from a specific solution to a general solution. But you usually only discover what’s simple and obvious (in hindsight), but generic and unspecified (as problems to tackle), by going after that general solution.
Why don’t more companies go after “general solutions”? Because it’s actually quite costly to do so, and goes against most of the best practices of running a focused product organization. You need to gather inputs from a huge range of customers and behaviors and actions, letting them do essentially anything they want to do, to make general progress on a domain, as compared to specific progress on a product. That means that the ability to build “general knowledge” into your product is actually dependent on your distribution strategy. This is non-obvious but important, and OpenAI understands it.
How do you serve “exactly what I want” (which can be a very custom, specific, finicky thing) at massive scale, to everybody?
There are basically three ways. You can deliver it in a standalone product, you can deliver it through partnerships, or you can provide it as a platform.
- Standalone Products have an advantageous constraint, which is that your product must, inherently, let the user “do whatever they want” (i.e. ask ChatGPT anything), so you are genuinely creating the customer experience, from getting it into their hands to watching them use it daily.
- Distributing through partnerships has the advantage that partners give you a lot of reach, quickly, around a lot of use cases. But it is ultimately the partner that owns and directs the customer’s “anything I want” instinct. And therefore, over the long run, not only will they likely capture the attractive economics, they are also in control over what the user ultimately gets to do, and what gets learned. Furthermore, your customers may not be aware you are even powering it, so you don’t earn any trust or goodwill from them.
- Distributing as a platform means people build whatever they want on top of you. This is slow, because you have to make all the new products supporting “anything I want” from scratch. But it’s very powerful once established, because even though revenue may come slower or at lower take rates, you have established a really powerful learning loop about the world, as users employ your primitives and patterns, that teach you about the world and about what people want from you. Not in the “training on customer data” sense, but in the, “the primitives become a better map of the territory” sense.


Over a long enough time, products come and go, partnership dynamics change, and their economics may disappoint relative to expectations. But OpenAI keeps coming back again and again with their drive to build the enduring platform. And what they’re doing is working.
True platforms are rare but worth it
Platforms are hard to build, and they’re hard to reason about. They’re even hard to define!
Generally we have a broad, fuzzy concept of platform that goes, “platforms let people build the thing for their specific need.”
In software, there are a few ways you can do that. Nineteen years ago, Marc wrote an essay called “Three kinds of platforms you meet on the internet”that remains useful today. Marc’s definition is: “A ‘platform’ is a system that can be programmed and therefore customized by outside developers—users—and in that way, adapted to countless needs and niches that the platform’s original developers could not have possibly contemplated, much less had time to accommodate.”
The “three kinds” correspond to three different ways you can arrange computers so that a user gets a custom outcome that they want. They are progressively harder to build (as you ascend from 1 to 3), but more magical in terms of what kind of behavior and building they unlock.
- Type 1 is what we’d call “Headless” today - give users access to something useful through an API (like Flickr back then, or even some companies as valuable as Stripe would fall into this.)
- Type 2 uses what you’d call “Plugins”: like the old Facebook platform, or most Shopify or HubSpot Apps today. You have a core service that provides the first 80% of users’ needs, and then custom apps that run on their own server, and probably managed through some kind of app store, that give users the custom experiences they want.
- Type 3 is the critical one: it’s a genuine runtime environment that people can program to create whatever they want. These are really, really hard to build, but they are true magic when they work. iOS, AWS, Ethereum, and recently Cloudflare are some examples.
What’s interesting about AI today is that all model companies and inference providers, in one sense, have a claim to be contributing “Type 3 platform” work. (Models are a kind of runtime, prompted with custom instructions!) But models alone do not unlock new behavior, nor are they all that defensible. Like we saw with coding, where the harness matters just as much, it’s the superstructure of constraints and primitives that actually matter here. We’ll give you a theoretical reason and a practical reason why.
The theoretical reason is that, if you want to discover the obvious-in-hindsight patterns and primitives that matter, you need exposure to as wide as possible range of use and tacit knowledge and trial-and-error from your users, so that you can evolve from a specific product (a local breakthrough) to a general product (a global breakthrough). And the purest way to do that is to let them write arbitrary instructions (i.e. code) for what they want to do. Getting the security right and the access and data structures and constraints right is a massive undertaking that “product-oriented” companies have a hard time prioritizing; only the truly committed will reach the promised land.
The practical reason, for AI right now, is that for agents to be useful, they need to write code. This is something that is perhaps non-obvious, but that we’ve learned in the past year. Given how amazing AI models are at writing code, they’re surprisingly bad at calling tools and carrying out instructions in everyday knowledge work - unless you flip the script around and say, “write a program that does these tasks”, and then they’re great at it. An open question in enterprise AI adoption right now is “how are people and organizations going to support this, safely?” and you should probably bet on the platform-minded people to get it right.
One of the big open questions right now is what kind of network effects, switching costs and other moats will emerge at the various layers of the AI stack. As of now, the model layer remains shockingly substitutable. There’s a general sense that “multiplayer mode” (e.g. collaboration on projects, agents being trusted by friends’ agents) has some good ingredients for business model defensibility, but it hasn’t yet really impacted the overall brawl around “usage up, costs down” that we see with token spend. The primary question that matters is not “is your model sticky”, it’s “are you creating new behavior?” As Steve Hou put it well: “The elasticity that matters is not the elasticity of substitution between models but the elasticity of aggregate demand for AI.”
Pattern-matching is never perfect, but if the past four years of AI is any indication, the next big breakthroughs in defensible, multiplayer usability of AI by regular people are going to emerge from epiphany moments where we find optimal layering of intelligent models, computing primitives, and behavior patterns, and something simple and obvious emerges. It could be from startups building on the model companies as platforms; it could be from the model companies themselves. Either way, OpenAI obviously wants to power it, and deliver it to users.
In a world of abundance, the causality goes backwards
Old habits die hard. In the regular ways that you might analyze an AI Frontier lab as a business, you might look at all kinds of obvious things to assess competitive advantages: who has the best models? Who has the best chips? Who has the best cost-performance? Who has the best products?
Obviously these all still matter. But in a world of abundant intelligence, on-demand anywhere, we’re probably getting the causality backwards if we think that having all of those things means you win. We think that, in the future, OpenAI will have the best models, chips and products because they have the best distribution, not the other way around. They’ve made great decisions thus far around securing enough compute, training models really effectively, developing Jalapeno as an optimized chip, and other practical things that can make a competitive difference within the set of AI options. But in the future, we think they will keep winning because they will stay at the frontier of gathering information about the world, from their own newly-awakened users, and self-improving from there.

New product and model offerings can grab everyone’s attention for a week or two, but over the long run we don’t really see OpenAI relinquishing their leadership position across what matters:
- They have retained the dominant consumer brand and a wide user breadth
- They have awakened new kinds of user behavior, that are obvious in hindsight and change the game of what’s possible
- They have pushed the frontier of “best models, best price” in their model offerings
- Their “flywheel” never lets up, and everything improves together
Sam describes the future product state of OpenAI as having only two offerings: either you can make anything you want, or else you can just talk to ChatGPT. This is what real abundance looks like in a product. You can either describe exactly what you want that will help you and get it, or else you can fall back to, “or I can just talk to this text box and figure out wherever I’m going.”
That abundance is generally available; today. There is a pretty small group of people that are using AI rampantly for everything in their lives; there is a somewhat larger and broader group of people that are using ChatGPT on a regular basis. They haven’t been awakened as customers yet. Who will do it?
We think OpenAI understands how.