Ploy 公司将生产环境 AI 从 Opus 4.8 切换到 GPT-5.6 Sol:质量不下降的同时耗时减少一半以上、成本降低 27%
- Ploy 把旗下建站 AI agent 的默认模型从 Claude Opus 4.8 换成了当天上线的 GPT-5.6 Sol
- 自评测显示:完成同类建站任务,耗时从 8 分 0 秒降到 3 分 42 秒,成本从 3.06 美元降到 2.22 美元,视觉评分从 0.936 升到 0.970
- 迁移中发现 GPT-5.6 会在工具调用里对用不上的参数编造默认值(如
offset: 0),一度导致 52% 到 64% 的文件读取悄悄返回空内容 - OpenAI 的 prompt 缓存机制和 Anthropic 完全不同,改用 workspace 级 cache key 重新设计缓存分层后,首次调用缓存命中率从 0% 提升到 83.7%
- 团队还发现自家评测框架本身对用惯的旧模型有隐性偏袒,需要先修评测框架才能信评测结果
Ploy 把默认模型换成了 GPT-5.6 Sol
AI 建站产品 Ploy 在 2026 年 7 月 9 日,把旗下 agent 的默认模型从 Claude Opus 4.8 换成了 OpenAI 当天发布的 GPT-5.6 Sol。
换模型这件事,比换一个 API 端点复杂得多。Ploy 的 agent 要规划页面、读代码库、写组件、生成配图、给自己的成果截图,再判断到底做完没有。把这套流程从 Claude 搬到 GPT-5.6,团队是一个评测失败接一个评测失败地发现:那些被当成"模型"的东西,其实是各家服务商各自的行为习惯,整个技术栈早就悄悄围着旧模型长成了特定形状。

下面是它品牌页重建评测套件里的一组样本,agent 要照着参考设计把品牌主页重做一遍:
| 每次完成建站,平均 | Claude Opus 4.8(n=11) | GPT-5.6(n=10) |
|---|---|---|
| 成本 | $3.06 | $2.22 |
| 耗时 | 8 分 00 秒 | 3 分 42 秒 |
| 输入 token | 2.60M | 1.70M |
| 输出 token | 33.0K | 17.1K |
| 视觉评分 | 0.936 | 0.970 |
GPT-5.6 写的代码更省。一组配对样本里,Opus 生成了 17,957 字符、174 个 CSS 变量(大段色阶其实没用上)的 globals.css,GPT-5.6 只用 2,508 字符、45 个变量,就渲染出相当(有时更好)的页面。


先看评测框架公不公平,再看模型强不强
拿两个模型的分数直接比之前,得先问一句:评测框架本身公不公平。Ploy 把同一套评测套件横跨两个模型家族跑了一遍,最意外的发现是,评测框架早就为旧模型调过了,团队自己却没察觉。
头一次跨模型跑,具体偏在这几处:
- 工具调用预算是按 Opus 的顺序调用风格设的。GPT-5.6 会并行铺开一堆调用,在它其实做对了的题目上把预算撑爆。
- 评测执行器不支持批量文件读取,这招 Opus 很少用、GPT-5.6 一直在用。
- 一个数据集漏写了
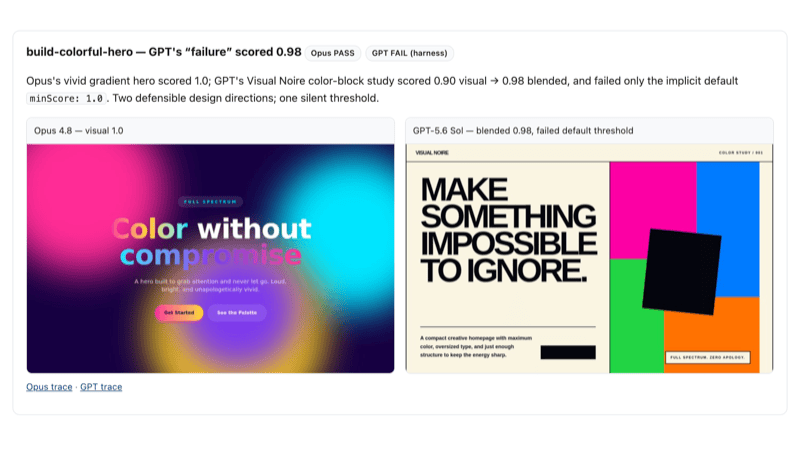
minScore阈值,悄悄继承了默认值 1.0。于是 GPT-5.6 一个拿了 0.98 分的 hero 被判"不合格",Opus 一个每项单独检查都通过的题目也算"失败"。两个都是站得住脚的设计方向,卡住它们的是一条看不见的阈值。
把这一轮的原始失败追下去,大约三分之一其实是评测框架的假设在作祟,跟模型行为无关,而且两个模型踩的还不一样多。

结论很直接:评估一个挑战者模型时,先逐条看轨迹,再信通过率,否则你是在按"它有多像旧模型"给新模型打分。
设计风格:干净好看,但容易千篇一律
Ploy 对 GPT-5.6 设计能力的总体判断:它很擅长干净、现代、网格排得很整的版式,但没被好好引导时,会一路往这种样子收敛。在为 Opus 4.8 设计的旧评测框架下,GPT-5.6 倾向于忽略已有的设计系统,产出利落、克制、但一眼就看得出通用化的页面。

怎么把它引导到世界级的品牌还原度,属于另一篇文章的范围。这里只记一个真实的能力特征,谈不上是坑。
模型会给用不上的参数编一个假值
Ploy 那个 code 工具有 25 个顶层参数,只有 action 是必填,其余都可选。Claude 只发它要用的那两三个,其余省略。GPT-5.6 每次把 25 个全填满,用不上的就编一个看着合理的值:offset 填 0、timeout 填 120000、siteId 填一串全是 0 的 UUID。
关键在于:编造出来的值和真实值,在接口层面完全看不出区别。offset: 0 看起来就是个正常参数,Ploy 的文件读取实现就当真了,于是 GPT-5.6 有 52% 到 64% 的文件读取悄悄返回空内容。可工具两种情况都回 success: true,模型根本不知道自己读的是空文件,只能默默把活儿越干越差,调用越堆越多。
三天生产流量里,code(read) 调用里携带全部 25 个参数的比例,差异大到不像同一件事:
换算成绝对数:GPT-5.6 的 6,635 次调用,6,635 次全带满;Opus 4.8 的 2,898 次里只有 4 次;Sonnet 5 的 1,933 次一次都没有。
提示词治不了这个。Ploy 把能"劝"的路都试了一遍,全部原样失败:
还是 25 个全填。
还是 25 个全填。
strict 模式行为一模一样(Ploy 实测),而且要用它,还得从每个 schema 里删掉 pattern、format 和数组边界校验,代价更大。
这是写进模型生成函数调用方式里的底层行为,靠指令劝不动,只能绕着它设计。
真正管用的修法是在 provider 边界做一次 schema 转换:只对 OpenAI 家族的模型,把每一个可选属性都改写成"必填但可为 null"(用 anyOf: [T, null]),这样模型就有了一个明说"我不用这个"的正规办法。然后在每次工具调用都会经过的那一道关卡,把这些 null 再剥掉,工具那头一行代码都不用改。一来一回:模型看到的是一个能表达诚实的 schema,工具收到的还是它一直以来收到的那些输入。
// Before: 25 keys, every one carrying an invented value
{ "action": "read", "file_paths": [...], "offset": 0, "timeout": 120000, ... }

// After: 25 keys, 4 real values, 21 explicit nulls (stripped before the tool runs)
{ "action": "read", "file_paths": [...], "offset": null, "timeout": null, ... }
两家的 prompt 缓存根本是两套设计
表面上两家都叫 prompt 缓存,"缓存"这两个字底下藏着两套完全不同的架构。迁移里最该小心搬的就是这一件:搬对之前,GPT-5.6 看起来比 Opus 贵约 50%,贵出来的这部分来自 Ploy 自己的缓存配置,跟模型定价没关系。
Ploy 的 prompt 开头有一段约 29K token 的静态前缀(工具 schema 加核心系统提示词),每一次对话都一模一样。两家怎么缓存这段前缀,差得很远:
cache_control 标断点,那段 29K 的静态前缀在整个机构范围内共享,任何对话、任何工作区共用一份,也不用操心每分钟能扛多少请求。命中率稳在 92% 到 96%,缓存基本无感。OpenAI 给的正规机制是显式的:用 prompt_cache_breakpoint 标记,再配一个必填的 prompt_cache_key。而 key 正是设计真正分岔的地方,因为它是缓存身份的一部分。prompt 一模一样、key 不同,命中率就是 0。每个 key 对应一个缓存节点,这个节点大约每分钟只扛得住 15 次请求,超了 OpenAI 就把流量甩到别的冷缓存节点。
prompt_cache_key 像图书馆的预留座位牌:拿同一个牌子的人会被安排坐进同一片区域,下次来直接续着看。key 相同才共享同一批缓存条目;key 一变,等于换了片区,之前存的缓存一条都用不上。
于是"要不要开缓存"变成了一个实打实的设计决定:这把 key,你绑到哪个层级?三种绑法各有各的下场:
新会话永远碰不到共享前缀,首次调用命中率 0%(Ploy 实测踩过这个坑,代价很贵)。
所有请求都哈希到同一个缓存节点,生产流量直接撑爆每分钟 15 次的预算,请求被甩到没缓存的冷节点,又变回没命中。
同一个客户工作区里的所有对话共享缓存条目,单个 key 的流量压力保持在低位。
Ploy 最后上线的是 workspace 级的 key,请求经 hash 分到吞吐有限的缓存节点,等于给每个客户工作区分一条专属车道:
光有 key 还不够,Ploy 还把系统提示词拆成三层断点,让每一层各管一件事,和它给 Anthropic 用的结构对齐:
改完之后,GPT-5.6 的每套评测成本落到了 Opus 之下。之前团队盯着的那道价差,每一块钱都是缓存配置错了,跟模型定价没关系。
还有一个没法绕开的结构性限制:在 OpenAI 上,跨工作区共享那段静态前缀,结构上就做不到。Anthropic 能共享,是因为它的缓存按机构划分、不按 key 分区。在 GPT-5.6 上,每个工作区的缓存一旦闲置过期,下次调用就要重付一次 29K 的冷写入,约 0.18 美元。这是实打实的成本,但有上限、可预期。
上一轮的推理记录会突然取不回来,加个开关就好
最后一个坑最短,但会真的搞坏对话。GPT-5.6 的 Responses API 默认把上一轮的推理过程存成"服务端 item 引用":服务器记一个编号,下一轮直接问那个编号。Ploy 的对话开始间歇性地在中途报错:Item 'rs_...' not found。
服务端指针就像给你一张取件凭证,而不是直接把东西给你。凭证一过期,你就取不到货了。store: false 相当于直接把货交到你手上,再也不用担心凭证失效。
rs_...),下一轮直接问那个编号。编号一旦失效,就报 Item 'rs_...' not found。store: false — 让 SDK 改为请求「加密推理内容」,把推理重放做成自包含的数据块, 而不是指向服务器状态的指针引用;否则中途可能报错 Item 'rs_...' not found
还有一点让 Ploy 多调了一下午:一旦回路里带着服务端推理状态,哪怕你自己发出去的字节严格只往后追加、一个都没动过,上游的有效 prompt 还是可能变。
迁移做完,最终成绩单和给同类团队的清单
四个坑一个个填完,开头那些承诺数字兑现了:耗时快约 2.2 倍、成本降 27%、视觉评分持平略升,缓存重配后首次命中率从 0% 拉到 83.7%、未命中输入 token 降 28%,per-suite 成本落到 Opus 之下;schema 改造后空文件读取归零、工具调用少约 30%。
这四步有先后顺序,先修框架,才能信后面的每一个数:
minScore 默认 1.0 这种看不见的阈值。头一轮约三分之一的失败其实是框架的锅,不是模型。anyOf: [T, null],执行前再把 null 剥掉。prompt_cache_breakpoint 加 prompt_cache_key,key 按 workspace 绑,system prompt 拆成 A / B / C 三层。首次命中率 0% → 83.7%。store: false,把服务端指针换成加密的自包含数据块,治好 Item 'rs_...' not found 报错。如果你在比两个模型的成本,其中一个的缓存还是冷的,那你比的是自己的配置,跟模型无关。Ploy 官方工程博客
换 AI 大脑,难的不是接上新接口 → 是工具参数、缓存、推理记录四处隐藏差异逐一重接
AI 建站产品 Ploy 把 agent 的默认模型从 Claude 换成 GPT-5.6,更快也更便宜,但迁移路上踩了四个看不见的坑,一页带图讲完。
↓ 一页读完 · 有一张会动的图
Ploy 是个 AI 建站产品,你说要个网站,它派一个 AI agent(会自己干活的 AI 程序)去规划页面、写代码、生成配图,还会自己截图检查做完没。2026 年 7 月 9 日,它把这个 agent 的默认「大脑」从 Claude Opus 4.8 换成了 OpenAI 当天发布的 GPT-5.6 Sol。
同一个 agent、同一套开发工具,只把默认大脑换掉。Ploy 自家评测里,让 agent 照着参考设计重建一个品牌主页,平均下来:
成本 $3.06
视觉评分 0.936
(满分 1.0,越像参考设计越高)
成本 $2.22(省 27%)
视觉评分 0.970
同样的活,一半多的时间省下来
团队还发现 GPT-5.6 有个脾气,没被专门引导时,设计偏干净但通用,容易忽略原有品牌风格(这算能力特征,正文另有展开)。但真正会让结果出错的,是另外四个看不见的坑。最阴的一个:它会悄悄读到空文件,还以为自己成功了。
GPT-5.6 有个习惯,每次调用工具,会把所有参数栏都填满,用不上的就编一个看着合理的值。麻烦在于,编出来的值和真值在接口上根本分不出来。
把「快约 2.2 倍」换算成同一个建站任务,实际要等多久:
接替 Claude
只能越读越多遍
还是 25 个全填满
模型老实填 null,执行前再剥掉。
这四样得逐一重接:
- × 评测框架偷偷偏向旧模型
- × 工具参数怎么填
- × 重复内容怎么省着算钱
- × 上一轮思考怎么存
→ ③ 重建缓存 → ④ 让推理记录自带上下文
是四处藏起来的旧习惯逐一重接。