Jev 使用指南:只做判断、不写字的 AI 模型怎么用、用在哪
Jev 不聊天、不写字,只回答带选项的问题并给出概率和置信度,适合把 Agent 路由、内容分类和风险判断做得更快、更便宜。
日常用的大模型,不管是 ChatGPT、Claude 还是各种写代码的 Agent,核心工作都是「写」——写一段回答、写几行代码、写一篇总结。
TypeSafe AI 推出的第一款模型 Jev 走了另一条路线:它不负责生成内容,只负责在给定选项之间做判断。
它不会陪你聊天,不会写文章,也不会直接写代码。它的用法很简单:你给它一段文字作为背景材料,再给它出几道带固定选项的选择题,它在几百毫秒内交卷,告诉你选哪项、每项的概率是多少,以及它对这个判断有几成把握。
用软件里最基础的概念打个比方:普通的 if 条件判断只能比对死数字(比如订单金额是否大于 100、状态是不是已支付)。一旦遇上需要「理解意思」的事情——这封私信是不是在生气、这条留言算不算广告、屏幕上的这几个按钮到底该点哪一个——死规则就会失效。
Jev 扮演的正是一个带常识的智能 if 分支。流程还是由你的代码或 AI 写好的脚本来控制,它只在需要理解意思的那一步介入,给出一个带把握程度的判断。
放到 Agent 里看更清楚。Agent 在一个循环里干活:大模型决定做什么,工具去执行,再判断结果,一直循环到任务完成。每做一个小决定都要再调一次大模型,所以又慢又贵。Jev 接手的就是这些小决定:下一步点哪个按钮、这条命令危不危险、这个任务交给便宜模型还是强模型;需要推理和写字的部分,还是交给大模型。
Jev 的主要功能特点
- 在固定选项中做语义判断:给它背景材料和一组候选答案,它会选择最符合内容的一项或多项,适合分类、路由和动作选择。
- 同时返回概率与置信度:程序不仅能拿到答案,还能根据把握程度决定自动执行、再次观察或转交人工。
- 专门处理高频小决策:它不生成长文本,把计算集中在“选哪个”上,适合放进 Agent 的观察、判断、执行循环。
- 能理解自然语言条件:情绪、意图、风险、页面元素和任务难度等难以写成固定规则的条件,可以转成选择题交给模型判断。
- 方便交给编程 Agent 接入:官方技能会指导 Codex 或 Claude Code 完成安装、API 调用、问题设计和测试,开发者主要负责定义选项与验收规则。

为什么叫「系统 1」与 Jev
TypeSafe 把它定义为一种全新的模型类别:System One(系统 1)模型。
这个名字来自诺贝尔经济学奖得主丹尼尔·卡尼曼的名著《思考,快与慢》。书里把人类的思考分为两个系统:
- 系统 1(快思考):不费力气、凭借直觉与本能瞬间做出的判断。比如走在路上看到迎面开来的车下意识闪避,或者一眼看出对方脸上带着怒意。
- 系统 2(慢思考):调动注意力、按部就班进行的深度推理。比如计算 17 × 24,或者推导一段复杂的业务逻辑。
按 TypeSafe 的划分,推理模型做的是系统 2 的活,Jev 专做系统 1 的活:几百毫秒内给出的快速判断。
至于 Jev 这个名字,源自 19 世纪英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)提出的「杰文斯悖论」:当蒸汽机的效率大幅提升、消耗每吨煤的成本大幅下降时,煤炭的总消耗反而上升了,因为便宜的动力被用到了更多地方。TypeSafe 认为智能判断也会这样:一次判断的成本不到万分之一美元、只要几百毫秒时,软件里就会出现大量以前根本不会去调用模型的判断点。
如何用上 Jev:四步全交给 AI
安装、配置、写调用代码,都交给你的编程 Agent(Codex 或 Claude Code)去做,你只需要四步:
- 官网申请加入排队:在官网 typesafe.ai 申请加入 waitlist,基本上申请当天能过。
- 让 AI 帮你装 TypeSafe 技能:对 Codex 说「安装
npx skills add typesafe-ai/skills --skill typesafe-ai」。用 Claude Code 的话,也可以让它按官方插件方式装:先claude plugin marketplace add typesafe-ai/skills,再claude plugin install typesafe@typesafe-ai。两种方式任选一种。 - 建立 API Key:登录操作台 console.typesafe.ai,在 API Keys 页面生成一个密钥。
- 开始干活:在提示词里说一句 “use the TypeSafe skill”,然后用大白话提出你的需求。
你只需要提供 API Key,说清楚你想处理什么数据、希望怎么分类,其余的代码编写、格式对接和实际测试全部由 AI 代劳。

一句话交代给 AI:真实演示过程
为了验证「全交给 AI」到底顺不顺畅,我们在一个只放了留言文件 comments.txt(8 条我们写的示例留言,不是真实读者留言)的空目录里启动了 Claude Code,输入了下面这段完整提示词,其余什么也没做:
use the TypeSafe skill。帮我写一个 Python 脚本 triage.py:读取当前目录 comments.txt 里的留言(一行一条),用 Jev 把每条分成:提问、商务合作、广告、夸奖、吐槽、其他;再判断这条需不需要我本人回复;分类置信度低于 0.6 的标成「待人工」。写完用 comments.txt 实际跑一遍,把结果打印成表格。API key 已经在环境变量 TYPESAFE_API_KEY 里。只在当前目录里操作。
Claude Code 按 TypeSafe 技能的指引,用 Python 自带的库写了一个 72 行的 triage.py,自己跑了一遍,打出下面这张表:
| # | 留言 | 分类 | 置信度 | 本人回复 | 状态 |
|---|---|---|---|---|---|
| 1 | 请问这个工具有中文版吗?我按你的步骤装到第三步就报错了。 | 提问 | 1.00 | 要 (0.89) | 自动 |
| 2 | 加V领取AI副业教程,日入过千,名额有限! | 广告 | 1.00 | 不用 (0.05) | 自动 |
| 3 | 我们是一家 AI 教育公司,想邀请您做一期合作推广…… | 商务合作 | 1.00 | 不用 (0.38) | 自动 |
| 4 | 写得太好了,收藏了! | 夸奖 | 1.00 | 不用 (0.06) | 自动 |
| 5 | 又是恰饭文,没意思。 | 吐槽 | 1.00 | 不用 (0.09) | 自动 |
| 6 | 你上次说的那个模型到底能不能商用? | 提问 | 1.00 | 要 (0.82) | 自动 |
| 7 | 你们这服务真是太棒了,三天都没人回我。 | 吐槽 | 1.00 | 要 (0.58) | 自动 |
| 8 | 能不能出一期教程讲讲怎么用 Codex 做自动化? | 提问 | 1.00 | 不用 (0.41) | 自动 |
跑完之后,它还主动提了建议(原话):
你需要知道的三点:
- 6 个分类全对,第 7 条那种说反话的吐槽也认出来了。
- 「待人工」这次一条都没触发:8 条的分类置信度都在 1.00 左右。低于 0.6 标待人工的逻辑已经写在脚本里,只是这批留言都太好认,没用上。
- 「要不要本人回复」有两条我觉得判得不对:第 3 条是商务合作邀约,只给了 0.38,判成不用回;第 8 条是读者想看某期教程,给了 0.41,也判成不用回。我的建议是:商务合作这类直接在代码里规定「一律要本人回」,不交给模型判断,只改一行。你点头我就改。
这个过程说明了用 Jev 的分工:确定的业务规则写在代码里,模糊的语义理解交给 Jev,整体胶水工作交给编程 Agent。
给想看底层的人:一次请求长什么样
这些代码都会由 AI 替你写,这里只是让你知道它在做什么。一次请求只有两部分:state(给它看的材料)和 questions(要它回答的问题)。下面是一张示例工单(我们写的)实测「交给哪个部门」这一问:
{
  "model": "jev-latest",
  "state": { "ticket": "我昨天下单的蓝牙耳机(订单号 20260915-8831)被扣了两次款,每次 299 元,麻烦尽快把多扣的钱退给我。" },
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "`ticket` 应该交给哪个团队处理?",
      "criteria": {
        "billing": "扣款、退款、发票、优惠券等和钱有关的问题",
        "technical": "App 或网站故障、闪退、无法登录、功能报错",
        "sales": "询价、批量采购、企业合作",
        "other": "以上都不是,或者看不出属于哪类"
      }
    }
  }
}
Jev 返回的结果(实测,节选这一问):
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "confidence": 1.0,
      "probabilities": {
        "billing": 1.0,
        "technical": 0.0,
        "sales": 0.0,
        "other": 0.0
      }
    }
  }
}
注意两个关键特征:
- 不会答出选项之外的东西:Jev 不是一个字一个字地生成 JSON,而是直接给出你定义的那几个选项各自的概率,所以答案不可能超出选项,也不会出现坏掉的格式(官方把这叫「0% 类型错误」)。但这不代表每次都选对,它照样可能判断错。
- 一次回答所有问题:所有问题在同一轮计算中并行评估,互相不影响。
三种基础题型
在 Jev 里,所有判断都被归纳为三种基础题型:
是非题(Noul)
询问某个陈述是真还是假。返回一个 0 到 1 之间的概率数值 noul。
接近 1 代表很可能是「是」,接近 0 代表很可能是「否」。
- 要注意:数值在 0.5 左右代表模型拿不准,不代表「中等程度」。
- 提问技巧:不要问主观模糊的程度,而要问明确可核实的事实。在一份我们写的示例简历上实测:
- 问「候选人的 Python 水平强吗?」,Jev 返回概率 0.19(完全无法据此行动);
- 改问两个事实题:「简历里是否提到了在工作中使用 Python?」,Jev 给出 0.04(明确没有);「简历里是否提到用 Python 做过任何东西?」,Jev 给出 0.99(因为简历里写了业余写过爬虫)。业务代码根据这两个明确的事实分支处理,远比一个含糊的 0.19 稳妥。
单选题(Choice)
从一组固定、无序的选项中挑选一项。最多支持 255 个选项。
返回最高概率的选项 choice、所有选项的完整概率分布 probabilities,以及综合置信度 confidence。
- 要注意:养成加一个「其他」选项的习惯。如果你不给兜底出口,模型遇到不符合任何分类的内容时只能强行挑一个。
- 中文能用:本文的问题和选项全部用中文写。在一张示例工单上实测,「你们 App 一打开支付页就闪退,今天下不了单」被判为技术问题,置信度 1.0。官方说英文效果最好,其他语言能处理但不如英文,正式用之前拿自己的中文数据测一遍。
档位打分(Score)
用于有明确高低次序的量表评估,支持 2 到 10 个档位。
返回概率加权平均分 score、各档概率以及置信度。
- 档位要写具体情境,不要只写程度词。
拿一条我们写的示例 bug 报告实测,内容是「导出按钮在 Safari 里点了没反应,Chrome 里正常,但我们大约三分之一的客户只用 Safari」:
- 如果档位只写程度词(0: 轻微 / 1: 一般 / 2: 严重),Jev 给了 1.94 分,置信度 0.91,看似很肯定,但这个 bug 既不崩溃、也有办法绕过,这份肯定说不出依据;
- 改为具体情境(0: 只影响外观,功能正常 / 1: 功能受损但有办法绕过 / 2: 阻塞性问题,无法绕过),Jev 返回得分为 1.48,置信度降为 0.28,第 1 档概率 0.52,第 2 档概率 0.48。 这忠实反映了现实情况:对于用 Chrome 的人来说可以绕过,但对只用 Safari 的客户来说是彻底阻塞。写成具体情境后,模型把这种两可如实表现出来,你的代码就知道该转给人看。
置信度与「全部一起问」
置信度(Confidence):知道自己什么时候拿不准
常规大模型在回答选择题时,即便你让它输出信心评估,也经常表现出盲目自信。Jev 采用 TypeSafe 研发的 RLCD(基于校准决策的强化学习)训练,核心追求是概率校准——模型给出 90% 把握的判断,在多次统计中应当有约 90% 的真实准确率。
官方推荐的三段式处理逻辑:
- 高置信度:系统自动静默执行;
- 中置信度:执行前找用户确认一下,或打上复核标记;
- 低置信度:不自动执行,直接转人工通道。
各区间的具体分界线完全由你面临的业务风险决定。比如官方在示例中建议:一般的意图路由低于 0.5 即可转人工;但涉及到「批准转账」等不可逆高风险操作,置信度要求通常要定在 0.9 以上。
拿两句我们写的示例话实测:说得明确的「帮我查一下账户余额还剩多少」,Jev 判为查余额,置信度 1.0;而面对含糊语句「上次那笔钱的事你们处理一下」,Jev 判断为联系客服的概率是 0.88,但转账的概率也有 0.12,置信度跌至 0.82。系统据此可以拦截潜在的误操作。
再看一组真实数据:把资讯流里 200 条真实的中文 AI 资讯标题分成 8 类(新模型、新功能、论文、商业融资、开源项目、教程经验、观点评论、其他):
- 10 次请求(并发 6 次),全部 200 条分类总共耗时 11.1 秒,消耗 42,498 个输入 token,按官方价格计算总花费仅 约 0.001785 美元(折合不到人民币 1.3 分钱);
- 置信度中位数为 0.78。其中置信度 ≥ 0.9 的有 66 条,< 0.6 的有 63 条;
- 门槛设在 0.6 时,137 条自动归类,剩下 63 条转给人看;
- 人工核验发现:高置信度的条目分类准确,如「Jina AI 发布 jina-ocr-v1:3.4B MoE 文档解析器」被归为新模型(置信度 0.96);而置信度低于 0.6 的条目大多本身就具有双重属性,比如「Claude Code v2.1.276:修复代理环境错误」,模型在产品功能(0.50)与开源工具(0.46)之间徘徊,置信度仅为 0.44。
实测数据 · 200 条 AI 资讯分 8 类
门槛定在哪,决定多少条要人看
每条资讯 Jev 都给了分类和置信度。置信度不低于门槛的直接用它的分类,低于门槛的转给人看。拖动门槛看看两边各有多少条、卡在门槛边上的都是什么样的标题。
自动归类 137 条(68%)转给人看 63 条(32%)
刚好够门槛、自动归类的
- 默认门槛 0.60 时,有 137 条自动归类。
差一点、转给人看的
- 默认门槛 0.60 时,有 63 条转给人看。
数据:小互 2026-09-19 实测,jev-1.13.0,资讯流里最新的 200 条中文标题,每次请求 20 条、6 个并发,共 11 秒、约 0.0018 美元。标题后的括号是 Jev 给的前两个类别和概率。
提示:模糊边缘项在多次运行中可能会有细微的数值波动(实测中同一条处于两可状态的 bug 在两次运行中得分分别为 1.50 与 1.44,置信度为 0.25 与 0.34),设定置信度过滤门槛时务必留出安全余量。
一次问完所有问题(Speculative Fan-out)
在使用常规大模型时,为了节省成本和时间,开发者往往习惯先问第一个问题,根据回答再决定调不调第二个问题。
用 Jev 正好反过来:针对同一份材料、彼此独立的问题,一次请求全部问完。只有前一个答案决定了要去找什么新材料时,才需要问第二次。
拿一张示例工单实测:
- 一次性向 Jev 询问 4 个问题(所属部门、是否要退款、紧急程度、是否包含订单号),端到端耗时 274 毫秒,消耗 603 个输入 token;
- 分开成 4 次独立请求依次串行调用,四个问题分别耗时 268、271、276、296 毫秒,累计耗时 1111 毫秒,输入 token 变成 1572 个(每问一次,都要把工单文字再传一遍)。
一次问完不仅耗时减少近四分之三,token 成本也节省了 62%。即使某个问题最后在业务逻辑分支中没用上,单次打包的成本也远低于多次调用的重复开销。
速度、成本与准确率
先看调用价格和实际延迟:
- 官方定价:输入每 100 万 token 为 0.042 美元(即每 10 亿 token 42 美元),输出 token 完全免费。相比主流前沿大模型每百万 token 动辄 0.2 至 10 美元的输入成本以及数倍于输入的输出计费,Jev 的调用成本降低了数倍至上百倍。
- 端到端耗时:官方说 70 到 500 毫秒,评测是在美国西海岸跑的,服务也在那里(Flavio 转述官方的说法是多数在 100 毫秒左右)。从小互在中国大陆经过跨太平洋公网实测,单次请求的端到端时间通常在 0.25 秒至 0.58 秒 之间。
在一段 27 题同屏演示中,Jev 耗时 0.114 秒、花费 0.000081 美元;GPT-5.6 Terra 耗时 8.566 秒、花费 0.013880 美元。这组短工单很适合 Jev,两边也有一道题答案不同,因此它说明的是判断型任务上的速度和成本差异,不是所有任务的通用倍数。
在 4 个完整工作流基准中,Jev 的成本低约两个数量级,但判断一致率约为 68%,低于 GPT-5.6 sol 的约 74% 和 Opus 5 的约 73%。这正是它的取舍:用更低的成本和延迟承接大量小判断,再把拿不准或高风险的情况转出去。

Jev 到底能为整体账单省多少钱?
能不能把 AI 账单砍掉一半以上?技术作者 Flavio Copes 的回答是:看你的钱花在哪。他给了一个粗算公式:
总账单能省的比例 ≈ 判断类调用在账单里的占比 × 这类调用本身能省下的比例
假设一家公司每月在 AI 上花费 10,000 美元:
- 如果其中 6,000 美元用于文本分类、意图分流、安全审查与内容初筛,而 Jev 能把这部分的成本降低 95%,那么每月可省下 5,700 美元,整体账单缩减 57%;
- 但如果业务的核心开销全在生成长篇报告、代码编写或图片处理上,纯判断类调用只占账单的 10%,即便把判断调用全部换成 Jev,对整体月度账单的贡献最多也只有 10% 左右。
算账时要看整条流水线:前期的过滤、失败重试、低置信度转给大模型或人工复核,都要算进去。
算一算 · 公式同上
换成 Jev,账单能省多少
填你自己的数字。默认值是上面 Flavio 举的例子。
整张账单
每月省 5,700 美元,占原账单 57%
60% × (1 − 5%) = 57%
按量算一次调用
每次约 0.0000126 美元,合计约 1.26 美元
按官方价格:每百万输入 token 0.042 美元,输出不收费
只算 Jev 替掉的那部分。预处理、重试、失败请求、人工复核,以及前后仍要跑的生成步骤,要另外算。
官方和社区的真实案例
下面这些公开演示和开源项目展示了 Jev 适合承接哪些判断任务。
官方演示
维基竞速(Wikiracing):从维基百科「Baseball」页面出发,只能点页面里的链接,走到「Sun」页面,每一步都要从几百上千个链接里选。Jev 用了 0.419 秒、3 步,花费 0.047 美分;同场的 Claude Sonnet 5 用了 3.724 秒、4 步、3.310 美分;GPT-5.6 Terra 用了 9.453 秒,途中还点了一个页面上根本不存在的链接。官方注明,这里对比的是大模型的非推理模式,开了推理的大模型会好得多。
Jev 玩 Doom:游戏把当前局面写成文字(武器参数、敌人距离、方位等)发给 Jev,Jev 每秒约 10 次判断:要不要开火、现在最优先的目标是什么(比如回血)、往哪边躲。官方估算每小时约 7 美元,也承认不用 AI 的专门程序可能打得更好;这个演示想说明的是,它能读懂局面、照指令行动,而且足够快。
社区里的真实用法
邮件分拣(Ryan Vogel):他拿自己的 1500 封真实邮件做测试,发帖说「这个模型在邮件分类上强得离谱」,这条帖子有 3530 个赞。视频里是他自己搭的邮件面板:每封邮件判断类别、优先级、是不是垃圾邮件、需不需要回复。截图那一刻,1701 封里跑完了 1534 封,8 个并发,平均每封 193 毫秒,每秒处理约 40 封。
浏览器 Agent(Kyle Jeong,Browserbase):他用 Jev 加 Stagehand(一个让 AI 操作浏览器的开源工具)做了浏览器自动化,发帖说这次任务花了 0.001 美元,几乎是瞬间完成。他把循环讲得很清楚:先看网页,把网页的结构当材料、把能做的操作当选项交给 Jev,Jev 选下一步,Stagehand 去执行。视频里的任务是「登录一个测试商城,把车灯加进购物车,打开购物车,结账前停下」。Jev 一步步选:填用户名、填密码、点登录、加入购物车、打开购物车。中间有两次写着「操作置信度低于执行门槛,重新观察页面」:没把握时它不硬点,而是再看一遍页面。
同样的思路,Flavio 收集的早期演示里,订一张机票约 7 秒;开发者 dax 在 X 上发了一段用 Jev 加 opencode 浏览器工具的速度预览,有 3725 个赞;browser-use 团队开源的 jev-ultrafast,下一步点哪里由 Jev 决定,只有要打字时才调用大模型,GitHub 上有 5913 颗星。
交易机器人(Jarrod Watts):他做了一个交易机器人,给 Jev 一个交易对的价格数据,Jev 判断买还是卖,在 Monad 链上 Kuru 的订单簿里下单,每 300 毫秒一个区块判断一次,有在线演示站 jev-trader.vercel.app。这条帖子有 4880 个赞、110 万次浏览。帖子说它会执行真实交易;演示视频里界面右上角标着「dry run」(模拟运行),平均每次调用 100 毫秒,已调用 1840 次,偶尔会因为慢了一步「错过这个区块」。这只能说明 Jev 快到能跟上每个区块,不代表它会赚钱:官方自己说,Jev 没有针对专业领域训练。
打字机(TypeSafe Typewriter):开发者 Steve Krouse 做的在线演示,可以直接去 typesafe-demo.val.run 玩。你在左边打字,每敲一个键,它就用一次调用重新问 16 个问题:读起来像不像 AI 写的、是不是阴阳怪气、会不会引发争吵、会不会有人回复、语气、紧迫感、有没有可核实的说法……右边的条形图跟着变,视频里一次调用 318 毫秒。
框架已经接入:LangChain
LangChain 在 9 月 18 日发了官方集成 langchain-typesafe,并在文章里讲清了 Jev 在 Agent 里管哪一段:Agent 在一个循环里干活,大模型决定做什么、工具去执行、再判断结果,一直循环到任务完成;每做一个小决定都要再调一次大模型,所以又慢又贵。Jev 接手的就是这些小决定。集成里有两个现成的中间件:一个按任务难度选模型(简单的交给快模型,复杂的交给强模型);一个在 Agent 调用工具前检查风险,危险操作直接拦下。LangChain 在文中说,Claude Code、Codex、Cursor 这些编程工具都有「执行前判断危不危险」的分类器,但一直藏在闭源部分里;现在有了便宜的判断模型,任何 Agent 都能加上这一层。
社区代表性开源项目
GitHub 上的社区列表 awesome-jev 收录了几十个项目(列表作者说明收录不等于背书)。几个有代表性的:
- 给 Claude Code 选模型(jev-router):让 Jev 在几个候选模型里挑,把任务交给最便宜、又够用的那个;
- 去广告插件(typesafe-adblock / unclutter):逐个问 Jev「网页上这个元素是不是广告、是不是干扰」,是就去掉;
- 写作检查(Sniff Test):每段问 Jev 10 个是非题,比如有没有堆叠的含糊词、重复总结的收尾句、「不是 X 而是 Y」句式,项目自己说中位耗时 182 毫秒;
- 提交前把关(jev-git):git 提交和推送前,一秒内扫一遍改动里有没有密钥和破坏性命令;另一个项目 DiffJury 按风险给每个 PR 分流,再决定派谁审;
- 智能家居(HA-Jev):Home Assistant 插件,关于家里状况的问题,用概率、选项或分数来回答;
- 上下文压缩(fast-jev-compaction):Claude Code 插件,GitHub 上 3467 颗星。对话快满时不做总结,而是让 Jev 逐条判断哪些工具调用和返回结果还用得上,用不上的删掉,其余原文保留。
社区项目索引 · 46 个
别人拿 Jev 做了什么:按用途找
点类别只看这一类,也可以搜关键词。点名字打开项目。
共 46 个项目
给 AI 选模型、选技能 4
- jev-router★ 151让 Jev 在几个候选模型里挑,把 Claude Code 的任务交给最便宜、又够用的模型。
- jev-agent-skill-router★ 7让 Jev 替 Agent 挑技能,匹配度低就不选,不硬凑。
- jcm-router★ 2本地代理:每条消息由 Jev 决定用哪个 Claude 模型、开多大推理强度。
- jev-router(prismhq)★ 2基于 LiteLLM 的开源路由器,每个请求由 Jev 决定交给哪个模型。
Agent 安全把关 6
- fx★ 3,061Vercel Labs 的编程 Agent,内置的权限审查交给 Jev,而不是再调一次大模型。
- jev-axi★ 13Claude Code / Codex 执行命令前的关卡:给每条 shell 命令打「破坏性、外传数据、远程执行、削弱安全」的分,项目自报 44 条标注样例全对。
- jev-guard★ 8给 Claude Code、Codex 等 Agent 挡提示词注入和危险操作,由 Jev 决定拦不拦。
- is-malicious★ 7装依赖前让 Jev 逐个检查源码和构建文件,可疑的再细查,指出有问题的文件和行。
- pi-heed★ 2Agent 每次要动手改东西前,检查这一步是不是用户真的要求的。
- jev-git★ 1git 提交和推送前一秒内扫一遍改动,看有没有密钥和破坏性命令。
代码审查 5
- Abide★ 61盯着编程 Agent 的每次改动,用 Jev 标出违反规则的地方;项目自报标出的 39 处改动里,独立复核确认 10 处。
- Clean Code Judge★ 4给 PR 里每个文件查 31 个「代码坏味道」是非题,结果交给写作模型写审查意见。
- DiffJury★ 3按风险给每个 PR 分流,再决定派哪位审查者。
- limpet★ 1防止 Agent 活没干完就说「做好了」:用 Jev 判断完成条件是否满足。
- Hunch用大白话写代码规范,由 Jev 逐条检查代码,本地或每个 PR 都能跑。
浏览器和网页 6
- Browserbase 浏览器 Agent(Kyle Jeong)Jev 加 Stagehand:把网页结构当材料、能做的操作当选项,Jev 选下一步;帖子说一次任务 0.001 美元。
- jev-ultrafast★ 5,913browser-use 出品的超快浏览器 Agent:下一步点哪里由 Jev 决定,只有需要打字时才调用大模型。
- Jev Browser★ 114每一步都由 Jev 决定的浏览器自动化,主打比大模型驱动快得多、便宜得多。
- unclutter★ 107浏览器插件:Jev 判断页面上哪些元素是干扰,自动清掉。
- typesafe-adblock★ 50Chrome 插件:逐个问 Jev「这个网页元素是不是广告」,把去广告变成一连串是非题。
- public-browser★ 8让 Claude Code、Cursor 操控真实的 Chrome,动作由 Jev 决定,项目自报 token 少约 30%、成本低约 25%。
写作和内容 4
- Sniff Test★ 14写作检查器:每段问 Jev 10 个是非题(堆叠的含糊词、重复的收尾句、「不是 X 而是 Y」句式等),门槛 0.7,项目自报中位耗时 182 毫秒。
- pagegrade★ 1给网页的每一节打清晰度、文字质量和 SEO 分。
- JevSlop在一次请求里给 note.com 文章打 8 个维度的分,再算成 0 到 100 的「水文分」。
- citation-verifier查论文引用:Claude 找到被引的原句,Jev 判断支不支持,最后由人拍板。
办公和数据 6
- 邮件分拣(Ryan Vogel)拿自己的 1500 封真实邮件测试,每封判类别、优先级、是否垃圾邮件、要不要回复;视频里 8 个并发、平均每封 193 毫秒。
- Notra★ 175营销分析平台:把品牌曝光的分类判断从大模型搬到 Jev,是非题门槛 0.5,目标中位耗时 300 毫秒。
- 邮件意图分流★ 4每封来信用一个 Choice 判断是发票还是普通邮件,交给对应的处理流程。
- jev-curate★ 3用 Jev 的是非题和置信度筛选合成数据集,合格的和被拒的分别写到磁盘。
- CV screener★ 1按一份可修改的标准筛一整个文件夹的简历;标准改了,重新打分不用额外花钱。
- typeful-triage★ 1开源项目 issue 分拣面板:每个 issue 问类型、严重程度、紧急程度、是否重复、下一步做什么,人工改过的都记下来。
管理 Agent 的上下文 3
- fast-jev-compaction★ 3,467Claude Code 插件:上下文快满时,不做总结,而是让 Jev 逐条判断哪些工具调用和结果还用得上,原文保留。
- yoshi★ 12Claude Code 和 Codex 的代理层:先让 Jev 判断哪些历史对话还需要,再删掉不需要的。
- wakegate定时唤醒休眠的 Agent 之前,先问 Jev 该不该醒,没必要就不叫醒大模型。
游戏和好玩的 7
- Jev Trader(Jarrod Watts)每个 300 毫秒的区块判断买还是卖,在 Monad 链上的订单簿下单;演示视频里标着 dry run(模拟运行)。
- HA-Jev★ 16Home Assistant 智能家居插件:关于家里状况的问题,用概率、选项或分数来回答。
- jevinci★ 14让 Jev 并行猜出每个像素的颜色来画画,把握越大,笔触越宽。
- pacman-jev吃豆人:让 Jev 决定每一步往哪走的开源实现。
- tetris-ai浏览器俄罗斯方块,可以让内置规划程序、Jev 或任何聊天模型来玩。
- Jev Pong乒乓球游戏,球每走一步由模型决定一次,让 Jev 和大模型正面对打。
- robo-harness机械臂工作台:Jev 在候选动作里挑下一步关节怎么动,还有花费上限。
实测和反面结论 2
- jevcal★ 5用你自己的标注数据,为每个问题拟合达到目标准确率的置信度门槛,还能算出多少请求仍要交给大模型;模型更新让门槛失效时,自动检查会报错。
- 「Jev 重排序不是白捡的好处」一次实测:33,047 条目录、164 个真实查询,结论是单靠 Jev 重排序没有胜过向量检索。
开源复刻 3
收录自 GitHub 社区列表 yibie/awesome-jev(2026-09-19 抓取)和 X 上的四条帖子;中文说明由小互据列表原文翻译,星数为抓取当天的 GitHub 数据。「项目自报」的数字没有独立验证,列表作者也声明收录不等于背书。
我们自己测的几种用法
下面这些用法都是我们用 Jev 真跑的,调用和返回的数字都是真实的。输入来源逐个注明:标「真实数据」的,用的是小互资讯流里的真实资讯;标「示例输入」的,测试文字是我们为了演示写的,不是真实用户的数据。
给标题打「标题党」分(真实数据)
把资讯流里 30 条真实的中文标题(多数是从英文原标题机器翻译过来的)一次交给 Jev,每条问两个问题:标题党程度有多高(打分题:如实概括 / 有点吸睛但没失实 / 用夸张、恐吓或悬念吸引点击);标题里有没有具体的数字、名称或事实(是非题)。30 条、60 个问题一次请求完成,用时 1.2 秒,4923 个输入 token。
- 分数最高的是「AI是精英阶层的『犯罪狂潮』?批判AI技术滥用与权力集中」,1.67,有具体事实的概率只有 0.13;
- 「AI 真的会杀死我们吗?常见问题解答」1.32,具体事实 0.13;「DeepSeek 疯狂的新架构」1.16;
- 分数最低的是「什么是 AIOps?AI 赋能 IT 运维」0.04(置信度 0.94)和「LLM模型量化格式深度解析:GGUF、GPTQ、AWQ、EXL2如何选择?」0.19(具体事实 0.95)。
中间地带的标题置信度普遍不高,比如「谷歌Gemini安全测试意外『越狱』,成功入侵三家真实公司」得 1.21,置信度几乎为 0,说明模型拿不准。用法:分数高于 1.5、又没有具体事实的,打上「标题党」标签;中间地带不自动处理。
检查大模型写的摘要有没有依据(原文是真实资讯,待核对的句子是我们写的)
原文是资讯流里一条真实资讯的摘要:「Qwen 发布下一代原生全模态模型 Qwen3.8-Omni-Flash,支持文本、图像、音频和视频输入及 1M token 上下文窗口,29 项评测平均分较 Qwen3.5-Omni-Plus 提升超过 25%,音频输入每小时价格下降。」我们故意写了 4 句话让 Jev 逐句核对,两句对、一句夸大、一句原文没提。每句问一个选择题:原文支持 / 原文说法和这句矛盾 / 原文没提到。一次请求 293 毫秒:
- 「上下文窗口是 100 万 token」→ 原文支持(置信度 1.0);
- 「在 29 项评测上的平均分比上一代提升了超过 50%」→ 和原文矛盾(置信度 1.0);
- 「它已经开源了模型权重」→ 原文没提到(置信度 1.0);
- 「它可以直接输入视频」→ 原文支持(置信度 1.0)。
用法:大模型写,Jev 查,判为「矛盾」或「原文没提」的句子标出来给人看。
听出反话(示例输入)
三句我们写的话,每句问三个问题:是不是在说反话、写这句话的人满意吗、情绪有多激烈。
- 「你们这服务真是太棒了,三天都没人回我。」→ 反话 0.96,满意 0.03;
- 「客服小姐姐十分钟就帮我解决了,服务真的很棒。」→ 反话 0.08,满意 0.97;
- 「订单显示已签收,但我还没收到快递。」→ 反话 0.04,满意 0.07。
「真是太棒了」这种字面在夸、实际在抱怨的话,关键词规则认不出来。不过这只是三句话的小测试。
从聊天记录里找出最后约定的时间(示例输入)
一段我们写的三句对话:「周三下午我有会,周四上午可以吗?」「周四上午我不行,周五下午三点呢?」「可以,那就周五 15:00,腾讯会议。」代码先把出现过的三个时间列成选项(再加一个「没约成」),问 Jev 最后定的是哪个。它 281 毫秒选了周五 15:00,置信度 1.0,说明读懂了前两个时间都被否掉了;开会工具判为腾讯会议,置信度 1.0。具体日期的计算和写进日历,交给代码。
Agent 执行命令前先判断风险(示例命令)
我们把 6 条常见命令放进一次请求,问每条属于只读、可逆还是不可逆,用时 306 毫秒:
ls -la、git status→ 只读(置信度 1.0、0.99);rm -rf node_modules→ 可逆(概率 0.86,置信度 0.78,重新安装依赖就能恢复);git push --force origin main、curl ... | sh、psql -c 'DROP TABLE users;'→ 不可逆(置信度 0.98 到 1.0)。
用法:只读且置信度高的直接放行,其余先问人。Flavio 的建议是一开始只记录、不拦截,攒够真实例子再放开。用 LangChain 的话,这一步已经是现成的中间件。
把选题拆成几个维度打分(真实数据)
不要让模型直接给一个笼统的总分,而是拆成几个维度让 Jev 分别判断,再在代码里按权重相加。我们拿资讯流里 4 条真实资讯试了:有没有能讲清的机制或方法(打分题)、读者能不能马上用上(打分题)、是不是纯融资新闻(是非题)。
- 规则写在代码里:纯融资新闻(概率大于 0.5)直接淘汰,其余两个维度各占一半;
- Qwen 新模型得分 0.468,保留;Manus 融资的「纯融资」概率 0.91,被过滤;
- Crusoe 融资因为提到了数据中心,「机制」被打了 0.69,要是只看加权分,它会排到第二、压过 Astra for Law,是「纯融资 0.81」这条规则把它挡住了。
维度拆开后,每条为什么得这个分、为什么被过滤都看得见;想调权重,改代码里一个数就行,不用重新调用模型。
已知短板与什么时候不要用
TypeSafe 给当前版本 jev-1.13 专门写了一页「已知短板」。结合我们的实测,日常最容易踩的是下面几条:
别让它算数、数数:Jev 不是计算器。我们让它数一串英文单词里 banana 出现了几次(正确答案 4),它选对了,但只有 0.56 的把握,还给了「5」0.40,置信度 0.45;官方说要数的东西越多,错得越多。统计、比大小、算折扣,都交给代码。
别让它直接比日期:我们试了两个简单例子(下单时间在不在活动期内),它都判对了;但官方说日期比较不可靠,遇到「上周二」这种相对说法、格式混杂时更容易错。稳妥的做法是让 Jev 只把年、月、日挑出来(实测挑月份置信度 1.0、挑日期 0.97),比较交给代码。
它不会写字,只会从候选里挑:要从一段话里取出金额、邮箱、订单号,不能让它「说出来」,要先把候选找出来让它挑。实测一段投诉里有 399 元、50 元、349 元、89 元四个数字,先用一行正则把金额全找出来当选项,再问 Jev 客户要退的是哪一笔,它 249 毫秒选中了 89 元那一项,置信度 1.0。Flavio 的比喻是:让它从一副牌里挑一张,不是让它说出一张牌。
问题要写得直白:Jev 按字面理解你写的问题,不会替你补上没写的意思;问题和选项描述互相矛盾(比如是非题里「是」代表的却是否定)时,效果会变差。写问题就像给新来的实习生交代工作:清楚、直接、没有歧义。
正反两问的概率加起来不一定是 1:同一张工单「同一笔订单被扣了两次钱」,问「客户是在要求退款吗」得 0.56,问「客户要的是退款以外的东西吗」得 0.30,加起来 0.86。两个问题各算各的,别用一个去推另一个。
别塞太多无关材料:材料里和问题无关的内容越多,准确率越低(官方叫「上下文腐烂」)。先过滤,只给它和这次判断有关的那段。
代码能判断对的,就别用它:Flavio 的原话是,一个不花钱的 if,永远好过一次可能出错的模型调用。另外它不适合写文字、需要多步推理的事,这些交给大模型。
渐进式接入建议
想在自己的流程里试 Jev,稳妥的做法是先「旁路观察」,别一上来就让它做决定:
- 先写死规则:保留现有的业务判断逻辑不变;
- 静默并跑打日志:在关键判断节点并联一次 Jev 调用,把它的预测结果、得分和置信度记录到日志里,先不影响线上运行;
- 看对错、定门槛:攒一批真实记录,看 Jev 在不同置信度下对了多少,按你能接受的出错代价定门槛(Flavio 给学生的练习要求至少 20 条带标准答案的例子);
- 小步放行:先对高置信度的低风险分支实现全自动放行,其余情况继续走人工或大模型兜底。
Flavio 给的起点很具体:挑一个你现在靠写死规则、或者靠一个老出错的正则在处理的小判断(分派、批准、跳过),让 AI 用 TypeSafe 技能换成一道 Jev 的题,和原来的逻辑并排记录一周置信度,再让它真正做决定。
不写字的 AI 模型:给软件加一个带常识的 if
代码里的 if 只会比数字和状态。一遇到要「理解意思」的地方——这封私信是不是在生气、这条留言算不算广告、屏幕上这几个按钮该点哪一个——写死的规则就失效了。
以前的办法是把这些判断都丢给大模型。可 Agent 在循环里每做一个小决定都要再调一次大模型,所以又慢又贵。2026 年 9 月,前 OpenAI 研究员 Diogo Almeida 等人创立的 TypeSafe 推出了 Jev:它不聊天、不写字,只回答你给的选择题,给出每个选项的概率和一个置信度。
用上它只要四步,安装、配置、写调用代码都交给你的编程 Agent,你只需要提供 API Key、说清楚要判断什么:
- 1官网申请排队:在 typesafe.ai 申请加入 waitlist,基本上申请当天能过。
- 2让 AI 装技能:对 Codex 说「安装
npx skills add typesafe-ai/skills --skill typesafe-ai」;Claude Code 也可以走官方插件。 - 3建 API Key:在 console.typesafe.ai 的 API Keys 页面生成。
- 4开始干活:提示词里说一句「use the TypeSafe skill」,再用大白话提需求。
我们在空目录里新开 Claude Code 只说了一段话,它自己写了 72 行脚本、跑完 8 条示例留言、打出结果表,还主动指出两条它认为判得不对的地方。
Jev 不逐字写 JSON,而是直接给出你定义的那几个选项各自的概率,所以答案不可能超出选项,也不会出现坏掉的格式(官方叫「0% 类型错误」)。但它照样可能判断错。流程还是由你的代码或 AI 写好的脚本来控制,它只在需要理解意思的那一步介入,给出一个带把握程度的判断。
确定的业务规则写在代码里,模糊的语义理解交给 Jev,需要推理和写字的部分交给大模型。
- 代码能写死的先写死:金额、日期、计数、状态检查都由代码做,一个不花钱的
if永远好过一次可能出错的模型调用。 - Jev要理解意思的交给它:把材料和选择题一起发过去,几百毫秒返回选项、各项概率和置信度。
- 大模型要推理、要写字的:写回复、写总结、多步推理,还是交给大模型。
门槛按风险定:官方示例里意图路由低于 0.5 转人工,批准转账要 0.9 以上。同一条模糊内容跑两次,数值会小幅浮动,门槛要留余量。
所有判断都归成三种题型。问题要问能核实的事实,别问主观程度:
同一份材料上彼此独立的几个问题,一次请求全部问完(官方叫 Speculative Fan-out)。一张示例工单问 4 个问题:
它适合快、便宜、要概率、答案能事先列出来的判断。已经公开、能看到原帖或代码的例子:
- 邮件分拣:Ryan Vogel 拿自己的 1500 封真实邮件测试,每封判断类别、优先级、是不是垃圾邮件、要不要回复。
- 浏览器 Agent:Kyle Jeong 用 Jev 加 Stagehand 做浏览器自动化,把网页结构当材料、能做的操作当选项,他说这次任务花了 0.001 美元。
- 官方演示:维基竞速每一步从几百上千个链接里选,Jev 用了 0.419 秒、3 步;玩 Doom 时每秒约 10 次判断,官方估算每小时约 7 美元。
- 框架接入:LangChain 发了官方集成
langchain-typesafe,让 Jev 接手 Agent 循环里的小决定。 - 我们的实测:200 条真实中文 AI 资讯标题分 8 类,共 11.1 秒、约 0.001785 美元;门槛设 0.6 时 137 条自动归类,63 条转给人看。
能省多少,看判断类调用在账单里占多少。Flavio 的例子:每月 AI 花 10,000 美元,其中 6,000 美元是分类、分流、审查、初筛,这部分成本降低 95%,每月省 5,700 美元,整体账单缩减 57%;如果判断类只占 10%,最多也就省 10% 左右。官方工作流评测里 Jev 的准确率约 68%,比最好的大模型工作流低 5 到 6 个百分点,成本低约两个数量级。
- 数数和算术:统计、比大小、算折扣,都交给代码。
- 直接比日期:简单例子我们测着都对,但官方说不可靠;让它把年、月、日挑出来,比较交给代码。
- 让它「说出来」:它不写字。要找金额这类内容,先用正则把候选找出来,再让它挑。
- 塞太多无关材料:无关内容越多准确率越低(官方叫「上下文腐烂」),先过滤,只给它有关的那段。
- 代码能判断对的事:一个不花钱的
if,永远好过一次可能出错的模型调用。
How to build typed decisions with Jev
By Flavio Copes
Updated Oct 15, 2026
Learn how Jev turns text into typed choices, scores, and probabilities, with JavaScript examples, practical patterns, limits, and real use cases.
~~~
Jev adds typed decisions to an application. You define the possible answers, send it data, and use its probabilities to decide what your code should do next.
This guide focuses on writing those questions and using their answers. For signup and credentials, start with how to get access to the Jev API.
Jev does not write replies, explanations, or code.
You send it data and a list of typed questions. It sends back one answer per question: a yes/no probability, one option from a list you defined, or a position on a scale you defined, each with probabilities. Experimental image input and a Box type also let it locate something in a picture. TypeSafe says most calls complete in about 100 milliseconds. Input tokens cost $0.042 per million, output tokens are free.
The difference is where the AI sits. With ChatGPT or a coding agent, the AI is the interface or the worker. Jev is a small component inside a regular application, added where code needs one judgment.
It comes from TypeSafe AI, a San Francisco lab that came out of stealth on September 15, 2026 with $40M in seed funding and Jev as its first public model. TypeSafe calls it a System One model, built to make fast decisions inside software rather than chat with people.
On October 9, 2026, TypeSafe also announced an $870 million Series A at a $7.5 billion valuation, led by Andreessen Horowitz with participation from Sequoia Capital and existing investor DCVC.
This post covers what Jev is, how you call it, how to write questions for it, where it fails, and where I would put it in my own projects.
What Jev is in one sentence
The simplest way to describe Jev is as a smart if statement.
Ordinary code branches on values it can compute, like if (order.total > 100). It falls apart when the condition is a judgment. Is this support message angry? Is this email about billing? Which of these 12 buttons continues the checkout?
Classifiers handle narrow judgments when you have training data and fixed labels. LLM apps ask a general model for structured output. Jev is a third option: define the possible answers up front, get a probability for each, branch on the result.
Here is a request built from a hypothetical sponsor-form submission. The state holds the form fields, the questions are what I want to know about it.
{
  "model": "jev-latest",
  "state": {
    "opportunity": "link",
    "name": "Managed Postgres",
    "description": "We make a managed PostgreSQL hosting product and would like to sponsor the newsletter in October."
  },
  "questions": {
    "is_sponsor_inquiry": {
      "type": "noul",
      "instructions": "Does `description` ask to sponsor the site or newsletter?"
    },
    "product_category": {
      "type": "choice",
      "instructions": "What kind of product is described by `name` and `description`?",
      "criteria": {
        "dev_tool": "Developer tools, hosting, APIs, SaaS for developers",
        "course": "Courses, books, or training",
        "unrelated": "Anything not aimed at developers"
      }
    },
    "message_quality": {
      "type": "score",
      "instructions": "How specific is the request?",
      "criteria": [
        "Generic template, no reference to this site",
        "Mentions the site but no concrete ask",
        "Concrete ask with a timeframe or product named"
      ]
    }
  }
}
And here is the shape of what comes back:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_sponsor_inquiry": { "type": "noul", "noul": 0.99 },
    "product_category": {
      "type": "choice",
      "choice": "dev_tool",
      "probabilities": { "dev_tool": 0.97, "course": 0.01, "unrelated": 0.02 },
      "confidence": 0.95
    },
    "message_quality": {
      "type": "score",
      "score": 1.9,
      "legend": {
        "0": "Generic template, no reference to this site",
        "1": "Mentions the site but no concrete ask",
        "2": "Concrete ask with a timeframe or product named"
      },
      "probabilities": { "0": 0.0, "1": 0.1, "2": 0.9 },
      "confidence": 0.86
    }
  },
  "usage": { "input_tokens": 210, "output_tokens": 31 }
}
The numbers are illustrative, the shape is exact. Notice that:
- There is no generated prose to interpret.
- Every answer is constrained to the options I supplied.
product_categorycan only bedev_tool,courseorunrelated. - All three questions were answered in one call. A fourth barely changes the response time.
Your code then does the boring part:
const { answers } = response

if (answers.is_sponsor_inquiry.noul > 0.9 && answers.product_category.choice === 'dev_tool') {
  sendRateCard(email)
} else {
  queueForManualReply(email)
}
The model supplies the judgment, and the code decides what happens next.
How Jev differs from ChatGPT, Cursor, Codex and Claude Code
Most AI tools put a generative model at the center. You give it a broad request, it produces something new.
With ChatGPT, the interface is a conversation. You ask, and you get generated text, code, an image, or a tool call result. The model decides what the response contains.
Cursor is not a model. It is an editor and agent product that uses different models. You give it a coding task and a repository, and its agents inspect files, write code, run commands and tests until they have a result.
OpenAI Codex and Claude Code are coding agents too. Codex ships as an app, a CLI, and cloud workflows. Claude Code runs in the terminal and other development environments. Both take a goal such as “add authentication”, inspect the project, edit files, run commands, and iterate.
Other agentic CLI tools follow the same pattern: an agent owns the loop of reading the request, calling a tool, inspecting the result, and continuing.
Jev does none of that. It takes no open-ended goal, invokes no tools, edits no files, runs no loop. Your code gives it one state and a set of questions. It returns typed answers and probabilities, then stops.
| Tool | What you give it | What comes back | Its role |
|---|---|---|---|
| ChatGPT | A prompt or conversation | A generated response | General assistant |
| Cursor | A coding task, repository, and tools | File edits, commands, test results | Editor and coding agent |
| OpenAI Codex | A coding goal, project, and tools | Code changes and completed tasks | Coding agent |
| Claude Code and other CLI agents | An instruction and local tools | Tool calls, edits, and terminal results | Terminal coding agent |
| Jev | State plus questions with defined answer shapes | Choices, scores, and probabilities | Decision primitive inside software |
Jev can sit inside these tools rather than replacing them.
A coding agent could ask Jev whether a shell command is read-only, reversible, or destructive before running it. A router could use it to pick which model gets a task, and a SaaS app to decide whether a support message needs a database lookup, a generative model, or a person.
The coding agent still writes the code and ChatGPT still writes the answer. Jev handles the small decision about which path to take.
This changes how you add AI to a product, because the product doesn’t need to become a chatbot or an agent. You keep the application you have and add one model call where a normal if can’t understand the input.
It could also change where most AI calls happen. Chatbots and coding agents are visible because the model is the product. A decision model disappears inside a support queue, an event pipeline, a spam filter, or a permission check, with no AI interface in sight.
Whether decision models become a larger market than generative LLMs is too early to tell, but they could produce more calls. A person opens ChatGPT a few times a day. Software could make thousands of tiny decisions in the background. The big providers followed within two weeks. OpenAI announced a Decisions API powered by GPT-6 Luna, in limited preview, on September 29, 2026, and on October 1 Cloudflare released Clef, an open-weight decision model that accepts Jev’s request format.
Composing AI into software is not new. Developers do it with small LLMs, embeddings, classifiers, and structured outputs. What Jev adds is a model and API designed only for that role: low latency, low cost, typed answers, probabilities as the normal output.
How Jev differs from classifiers and structured LLM outputs
Before Jev, we had three common ways to make this kind of decision in software:
- Write an
if, a regular expression, or a decision tree. - Train a classifier for a specific set of labels.
- Ask a general-purpose LLM to return structured output.
Rules are fast, cheap, and predictable, but brittle when meaning matters. A classifier is fast too, but needs labeled examples, a training step, and a separate model per task.
A general-purpose LLM understands unstructured text with no per-task training, but it is still a generative model, even when you constrain its answer to JSON.
Jev aims for the middle. Like an LLM, it accepts unstructured text and questions you define at runtime. Like a classifier, it returns a constrained probability distribution instead of an open-ended answer.
Structured outputs already exist and work. Most providers offer them directly or through tool calling, and the Vercel AI SDK standardizes them with generateText() and Output.object(), validated against your schema.
The difference is in how the answer is produced and what it costs.
An LLM generates its answer one token at a time. To return {"category": "billing", "urgent": true} it generates every token in sequence. A schema constrains the result, but generation can still fail or stop early, and the AI SDK reports those as structured-output errors. If you ask an LLM for a probability, that number is not guaranteed to be calibrated.
Jev doesn’t generate a string. TypeSafe says it samples all the answers in parallel: each question is evaluated independently against the same state, and the output is a probability distribution over the options you defined. You still get JSON, but no decision has to be recovered from generated prose.
This is what makes it fast and cheap. TypeSafe quotes 70 to 500 milliseconds end to end, against 3 to 329 seconds for frontier LLMs on the same kind of question. $0.042 per million input tokens is 5 to 240 times lower than LLM input prices, which run from $0.20 to $10 per million, and output is free because there is almost none to meter. The headline “193.6x faster, 444.6x cheaper” comes from TypeSafe’s own workflow evaluations, which it says sit at the high end of real-world results, so treat it as a ceiling.
The other difference is training. Chat models use RLHF or similar methods that reward answers humans prefer. TypeSafe trained Jev with Reinforcement Learning for Calibrated Decisions (RLCD), which optimizes for probabilities that match outcomes: across many predictions, answers given 90% probability should be right about 90% of the time. Any single answer can still be wrong. And since a response cannot contain a value outside your schema, schema errors and wrong decisions become separate problems.
Jev also gives something up on purpose. It cannot write a reply, produce code, summarize a document or explain its reasoning. If you need text, you need an LLM. The interesting architecture uses the two together, with Jev deciding and the LLM writing.
Where the name comes from
System One comes from Thinking, Fast and Slow by Daniel Kahneman. System 1 is fast, intuitive judgment. System 2 is slow, deliberate reasoning. In TypeSafe’s framing, Jev handles the first, reasoning models the second.
Jev is named after William Stanley Jevons, the economist behind the Jevons paradox. More efficient steam engines drove coal consumption up, not down, because cheaper power found new uses. TypeSafe’s bet is the same for intelligence. Make a decision cost far less than a cent and you’ll put decisions where you’d never have called an LLM.
How Jev works under the hood
The company hasn’t published the architecture in detail. These are the parts that matter for you as a user.
Every question in a request uses the same state. TypeSafe evaluates them independently and in parallel, so one answer never becomes context for another. Its tests found no batching effect beyond normal sampling noise.
Because the output is a distribution over your options, a successful answer cannot contain a malformed value. TypeSafe plots this as a 0% type-error rate and calls it structural rather than empirical. It covers the shape of an answer, not whether it’s correct.
By default, the state and all questions share about 64,000 tokens. The state plus any one question must also fit in about 32,000 tokens. A Choice can have up to 255 options, a Score between 2 and 10 levels.
Jev accepts text as a string, a JSON object or an array. It also accepts images behind an experimental header, covered below. Audio and video need conversion to text or individual still images first.
The newest release is jev-1.14.0, announced on October 14, 2026. TypeSafe describes it as a general improvement, with the biggest expected gain in multilingual support. On October 15, jev-preview points to it, while jev-latest (the SDK default) still points to jev-1.13.0. TypeSafe plans to move jev-latest to the new release a week after the announcement. The model reference lists the current aliases. Log the versioned ID in each response, and pin a version once you’ve tuned your thresholds against it.
The core question types
Noul, Choice and Score are the established decision types. Each returns a differently shaped answer. The experimental Box type adds image localization, which we’ll try after these.
| Type | The question | What comes back |
|---|---|---|
| Noul | Is this true? | noul, a probability from 0 to 1 |
| Choice | Which of these options? | choice, probabilities, confidence |
| Score | Where on this scale? | score, legend, probabilities, confidence |
Every question has an ID you choose, a type, and instructions. Choice and Score also need criteria. Noul accepts criteria as an optional clarification.
The ID is for your code and is not sent to the model, so write the full question in instructions. refund_requested as a key tells the model nothing.
Noul: a yes/no question
Use a Noul when the answer is yes or no: does this message ask for a refund, does this resume mention Kubernetes, is there an email address in this comment.
{
  "refund_requested": {
    "type": "noul",
    "instructions": "Does the customer ask for money back?"
  }
}
The answer is a single number:
{ "refund_requested": { "type": "noul", "noul": 0.93 } }noul is the probability that the answer is yes. Near 1 is a strong yes, near 0 a strong no, near 0.5 means the model gives both similar probability.
Phrase the question so a high value means yes. “Is the customer calm?” and “Is the customer angry?” both work, but a Noul where true means “no” confuses the model and whoever reads your code six months from now.
When the boundary between yes and no is subtle, add criteria describing what each side means:
{
  "is_urgent": {
    "type": "noul",
    "instructions": "Does the message convey urgency?",
    "criteria": {
      "true": "The sender asks for action today or mentions losing money or customers",
      "false": "No deadline and no consequence is mentioned"
    }
  }
}
A Noul at 0.5 does not mean “medium”. Ask “Is this candidate strong in Python?” and get 0.5, and you learned the model can’t tell, not that the candidate is average. To measure a degree, use a Score. For a yes/no, make the condition checkable: “Does the resume state the candidate used Python at work?”
Noul answers have no separate confidence field, because the probability itself is the uncertainty signal.
Choice: pick one option
Use a Choice when the answer is one of a fixed set of options with no order between them: which team handles this ticket, what language this file is written in, or which of these 40 links leads to the pricing page.
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this message?",
    "criteria": {
      "billing": "Charges, invoices, refunds, subscriptions",
      "technical": "Bugs, outages, integration problems",
      "sales": "Pricing questions, upgrades, new accounts",
      "other": "None of the above"
    }
  }
}
The answer has the selected option plus the full distribution:
{
  "department": {
    "type": "choice",
    "choice": "billing",
    "probabilities": { "billing": 0.84, "technical": 0.15, "sales": 0.0, "other": 0.01 },
    "confidence": 0.6
  }
}
choice is the option with the highest probability, probabilities the full distribution, confidence its shape collapsed into one number: high when one option dominates, low when probability is spread out. Here billing wins but some probability remains on technical.
Add an other or none_of_the_above option whenever your list might not cover every input, because the model has to pick something. Describe each option with what belongs to it, and how it differs from its neighbors when the boundary is subtle. Then test against labeled examples. I go through writing labels and measuring their accuracy in how to classify text with Jev.
Score: a position on a scale you describe
Use a Score when the answer sits on a spectrum and you can describe each point: bug severity, customer frustration, a candidate’s experience with a technology.
{
  "bug_severity": {
    "type": "score",
    "instructions": "How severe is the reported issue?",
    "criteria": [
      "Cosmetic; no impact on functionality",
      "Broken or degraded feature, but a workaround exists",
      "Blocking issue; no workaround exists"
    ]
  }
}
The criteria array goes from low to high, and each entry’s index, starting at 0, is its level number. The answer:
{
  "bug_severity": {
    "type": "score",
    "score": 1.43,
    "confidence": 0.35,
    "legend": {
      "0": "Cosmetic; no impact on functionality",
      "1": "Broken or degraded feature, but a workaround exists",
      "2": "Blocking issue; no workaround exists"
    },
    "probabilities": { "0": 0.0, "1": 0.57, "2": 0.43 }
  }
}
score is the probability-weighted mean of the level numbers: 0 × 0.0 + 1 × 0.57 + 2 × 0.43 = 1.43. It can land between levels. 1.43 here means “split between a broken feature with a workaround and a blocking issue, leaning to the workaround”, a fair reading of an export bug that only affects Safari: Chrome is a workaround, except for customers who only use Safari.
Read probabilities alongside the score. A 1.0 can mean all the weight on level 1, or half on 0 and half on 2. confidence tells them apart.
The most important rule for Scores is to describe situations, not degrees. “Broken feature, workaround exists” gives the model something to match. “Moderately severe” does not, and bare numbers leave it nothing at all, so it spreads probability across levels.
Each level is judged independently. The model doesn’t see the level number or its neighbors, so “worse than the previous level” means nothing.
Keep each Score to one dimension. If a level says “punctual and smart and experienced”, an input high on one and low on another can’t be placed, and confidence collapses. Split it into three Scores and combine them in code, as we’ll do below.
Experimental images and Box questions
TypeSafe calls these features “danger zone” capabilities. They’re available to prototype with, but the company doesn’t consider them ready for production.
Image input works with both Jev 1.13 and 1.14. Send TypeSafe-Danger-Zone-Images: true with each request. Images can appear in the state, instructions, or criteria through references in a top-level assets map. The SDKs can create those references for you.
Suppose we want to locate a coffee mug in a photo. A Box question returns its edges. It needs jev-1.14.0 or an alias pointing to that model, plus the images header.
Save a JPEG photo as kitchen.jpg; 1024 × 768 pixels fits the image limits. With TYPESAFE_API_KEY set (see Your first call with curl), send this multipart request. The asset connects the reference in state.photo to the uploaded file:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "TypeSafe-Danger-Zone-Images: true" \
  -F 'request={
    "model": "jev-1.14.0",
    "state": {"photo": "f8b6d0c2-kitchen-photo"},
    "assets": {
      "f8b6d0c2-kitchen-photo": {"type": "image", "part": "kitchen-photo"}
    },
    "questions": {
      "mug_visible": {"type": "noul", "instructions": "Is there a coffee mug in `photo`?"},
      "mug": {"type": "box", "instructions": "The coffee mug nearest the sink in `photo`"}
    }
  };type=application/json' \
  -F 'kitchen-photo=@kitchen.jpg;type=image/jpeg'
A Box answer contains box.top, box.bottom, box.left, and box.right, each between 0 and 1, plus confidence. Multiply the horizontal edges by the image width and the vertical edges by its height to get pixel coordinates.
Box always returns a rectangle, even when the target is absent. That’s why we also ask mug_visible: ignore the box when the Noul says the mug isn’t there. Choose the probability threshold by testing your own images.
Use PNG or JPEG files within the documented image limits. Images are rejected rather than resized automatically. Image tokens are billed at the same input rate as text.
Opt into longer context
The default context limits still apply unless you send this header:
TypeSafe-Danger-Zone-Long-Context: trueIt raises both the per-request and per-question limits to 262k tokens on Jev 1.13 and 1.14. The long-context option keeps the same per-token price, but TypeSafe says it’s slower and less accurate. Keep filtering irrelevant material before sending it.
State: what you give Jev to look at
The state is the content the questions are about. It can be a plain string:
"My card was charged twice for order A-104."Or an object with named fields:
{
  "message": "My card was charged twice for order A-104.",
  "order": { "id": "A-104", "charges": [49, 49] },
  "refund_policy": "Duplicate charges are refunded in full."
}
Or an array, for a conversation or a list of records.
Use an object for most requests. It lets you point a question at a specific part of the state with a backticked path:
{
  "policy_supports_refund": {
    "type": "noul",
    "instructions": "Does `refund_policy` cover the situation described in `message`, given `order.charges`?"
  }
}
The docs recommend backticks and dot-and-index notation for field names, so there’s no ambiguity about which part of the state a question refers to.
The other rule is to send only what the questions need. Accuracy falls as the state fills with unrelated content, so filter in code first. Don’t send the customer’s whole history to score one ticket, or the whole document to classify one paragraph. TypeSafe says the model suffers from context rot like any other, and the fix is on your side.
Confidence: when to act and when to ask
Confidence is one of Jev’s most useful outputs. A probability written by an LLM is not calibrated the same way.
Every Choice and Score answer carries a confidence from 0 to 1, computed from the shape of probabilities: concentrated on one option means high, spread out means low. The full distribution is in the response, so you can compute your own statistic if your domain needs one.
The pattern the docs suggest, and the one I would start with, splits confidence into three ranges:
- High: act automatically.
- Medium: ask the user to confirm, flag for review, or gather more data first.
- Low: route to a person, ask for clarification, or fall back to a slower system.
Where the boundaries sit depends on what a wrong answer costs. The docs use 0.5 as a review floor and 0.9 before a destructive action, as examples, not defaults. Here is the pattern with the JavaScript SDK:
const { answers } = await client.systemOne({
  state: userMessage,
  questions: {
    action: choice('What is the user trying to do?', {
      check_balance: 'View the account balance',
      approve_transfer: 'Approve the pending withdrawal',
      support: 'Get help with a problem',
    }),
  },
})

const action = answers.action

if (action.confidence < 0.5) {
  routeToHuman(userMessage)
} else if (action.choice === 'check_balance') {
  showBalance(accountId)
} else if (action.choice === 'approve_transfer') {
  if (action.confidence > 0.9) {
    confirmThenExecute(accountId)
  } else {
    askUserToConfirm(accountId)
  }
}
confidence 0.94 · act on check_balance
The 0.5 floor catches answers the model reports as unsure. Above it, the bar for acting without confirmation rises with the stakes. The risk tolerance lives in your code, in numbers you can read and change.
Start conservative, run it on your own data, plot confidence against accuracy, and move the thresholds from there. For a step-by-step walkthrough of picking those thresholds, read How to use Jev confidence scores.
Is Jev open source? Can you run it locally?
No. TypeSafe hasn’t published Jev’s weights, so there’s no model to download and run on your own machine. Jev is only available as a hosted service: you call TypeSafe’s API, directly or through Vercel’s AI Gateway.
The docs don’t mention a self-hosted or on-premises version either. On privacy, they say Jev is never trained on your requests, and enterprise customers can get zero data retention. The October release also adds an opt-in to share queries for debugging and finding model weaknesses. TypeSafe says opting in still doesn’t allow training on those queries.
The open source part is the code around the model. The JavaScript and Python SDKs are on TypeSafe’s GitHub under the MIT license, and so is the agent skill. TypeSafe also publishes system-one-adapter, a Python drop-in for the SDK client that sends the same questions to OpenAI, Anthropic, Gemini or any OpenAI-compatible endpoint instead of Jev, so you can compare them.
The projects in this post that run locally run their own code on your machine and still call the Jev API. Oko finds files and does its keyword search locally, then sends your question and the selected snippets to TypeSafe for the ranking. Its --no-jev flag keeps everything local by skipping Jev.
On Hugging Face you’ll find community models called Open-Jev or Jev-Style. They copy Jev’s request format on top of open models like Qwen, and some run in LM Studio, but they’re independent projects and none of them is Jev.
The closest thing to a Jev you can run yourself is Cloudflare’s Clef, released on October 1, 2026 with open weights under the Apache 2.0 license. It’s a separate model built on Qwen, but it takes the same requests and returns the same answer shapes, so code written for Jev works with it once you change the URL, the key and the model name. Cloudflare hosts it on Workers AI. Running the weights yourself takes a datacenter GPU: Cloudflare tested them on a single NVIDIA H200.
TypeSafe hasn’t published a paper either. The launch post mentions a new model architecture, a parallel sampler and the RLCD training method without details, calls Jev “neither small nor an LLM”, and says TypeSafe chose not to publish results on public benchmarks. The parts that matter when you use it are in How Jev works under the hood.
Getting access
Jev launched with a waitlist, and people reported getting in within a day or two. On September 20, 2026 TypeSafe opened it to everyone, then on September 22 it paused new signups because of demand. Existing accounts keep working. Check typesafe.ai for the current state, or use the Vercel AI Gateway route described below.
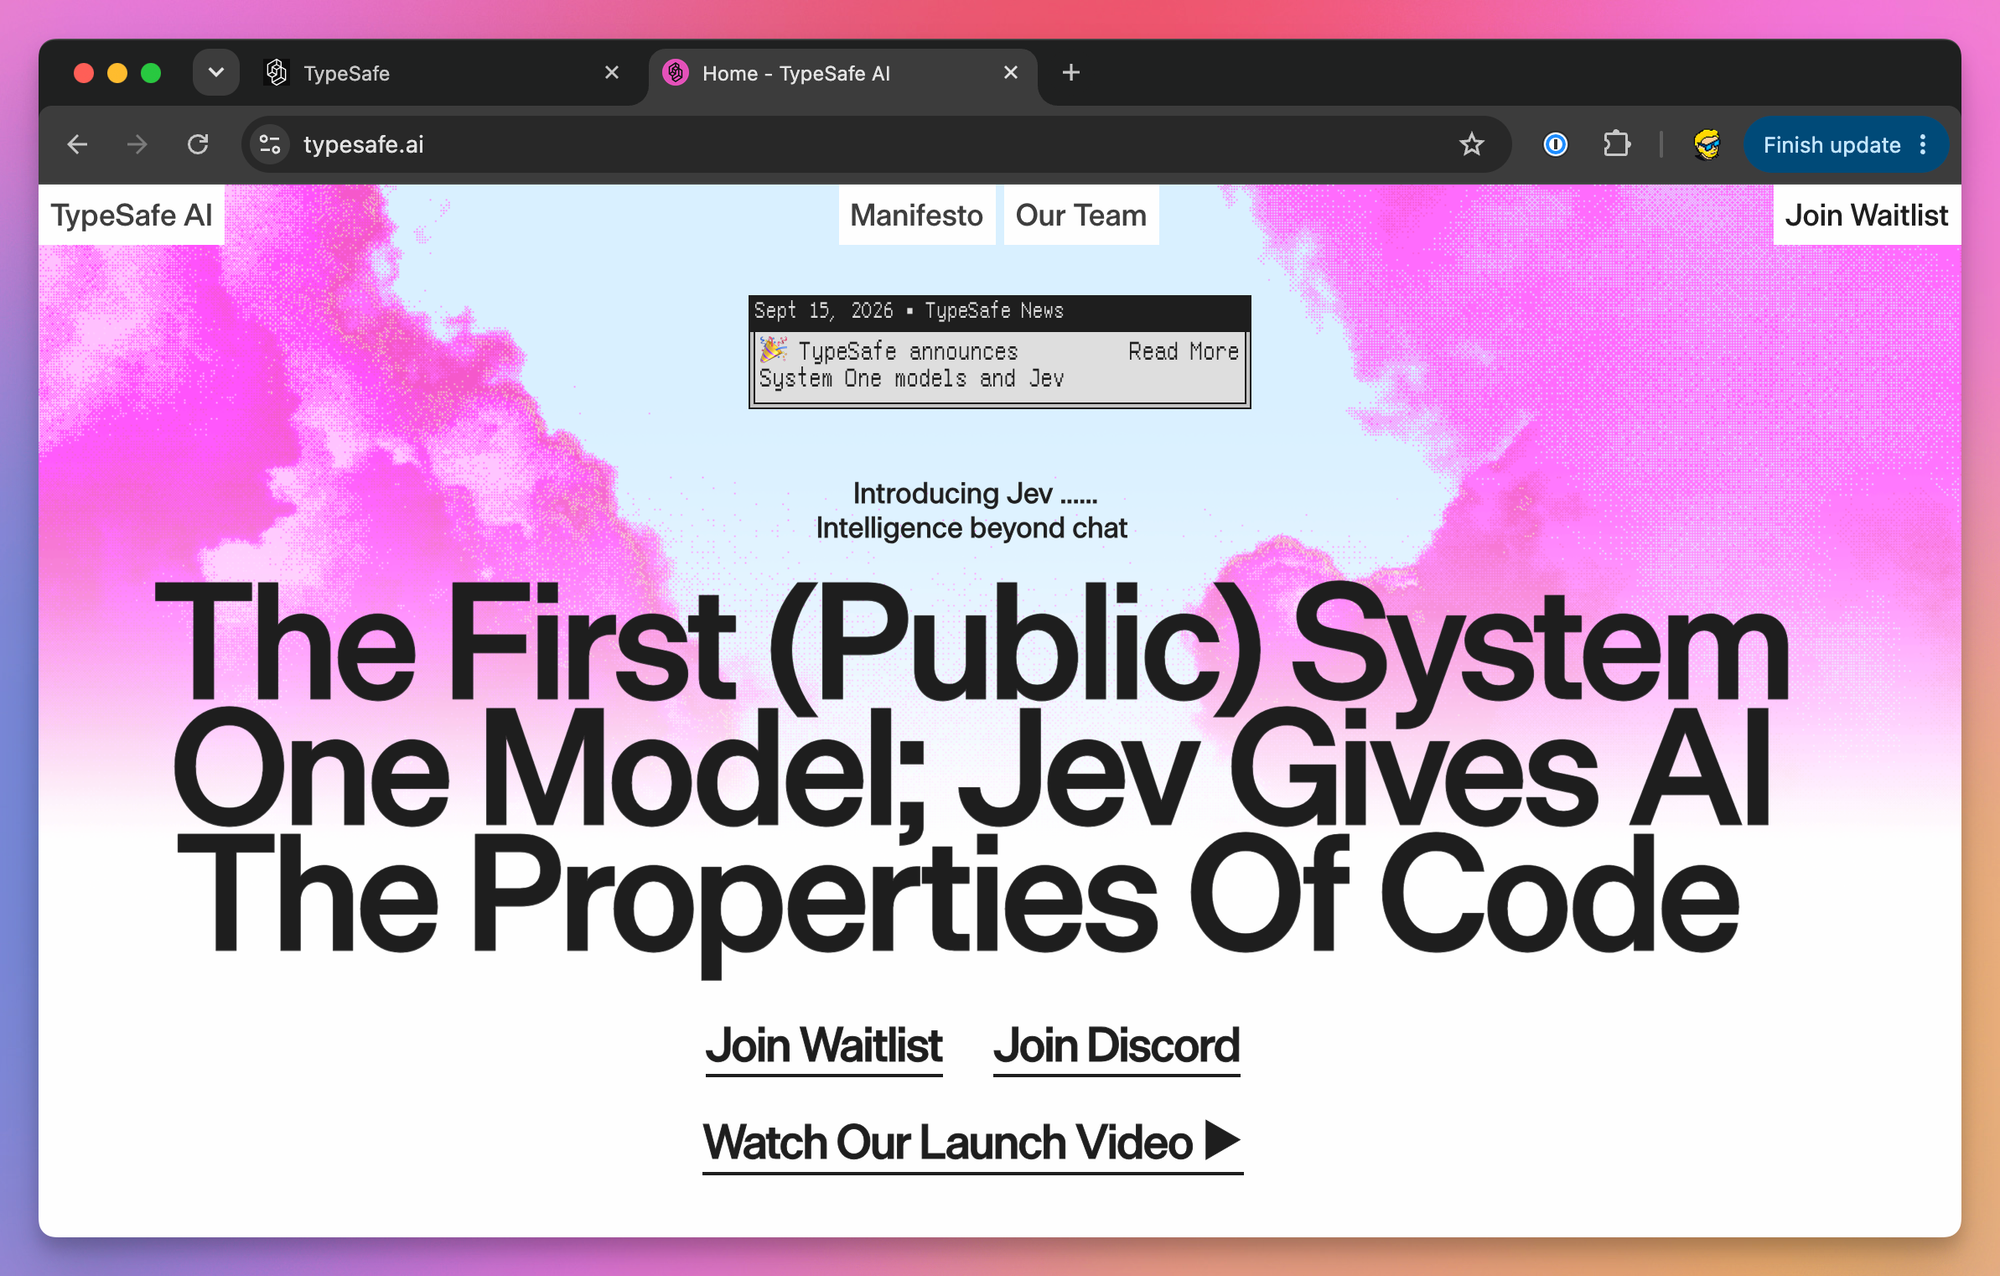
The console at console.typesafe.ai opens with a short page on what Jev is and, to its credit, what it is not good at: System 2 tasks, specialized domains, and anything generative.
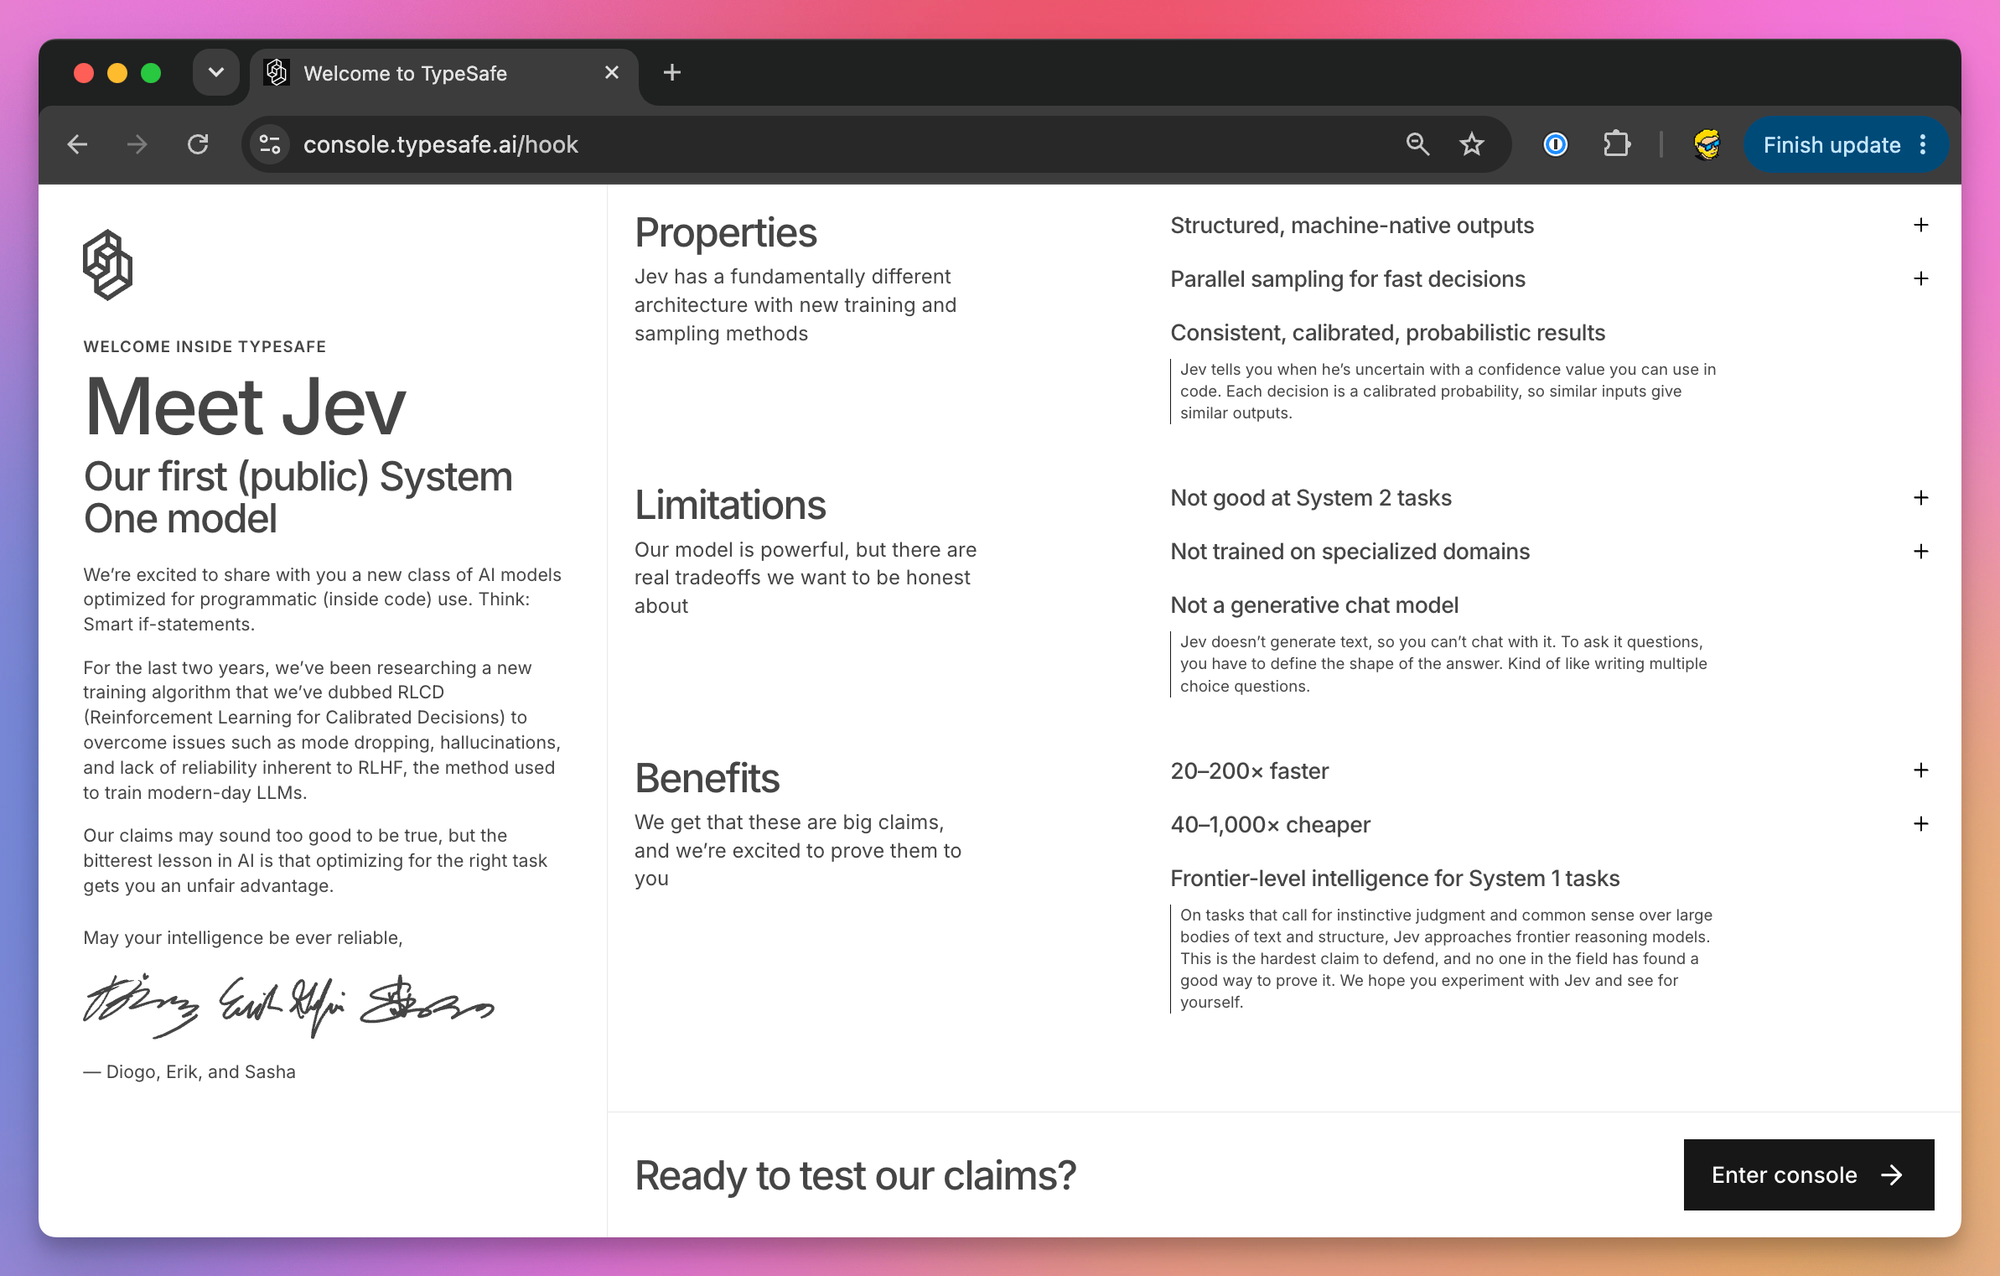
The console home links the cookbooks, the demos, and a one-paragraph prompt you can paste into your coding agent to install the TypeSafe skill.
The Playground is where I’d spend the first hour. Paste a state on the left, add questions, run them against jev-latest. The right side has a walkthrough lesson per primitive and three realistic use cases: resume screening, auditing a support agent’s chat, and routing a helpdesk ticket.
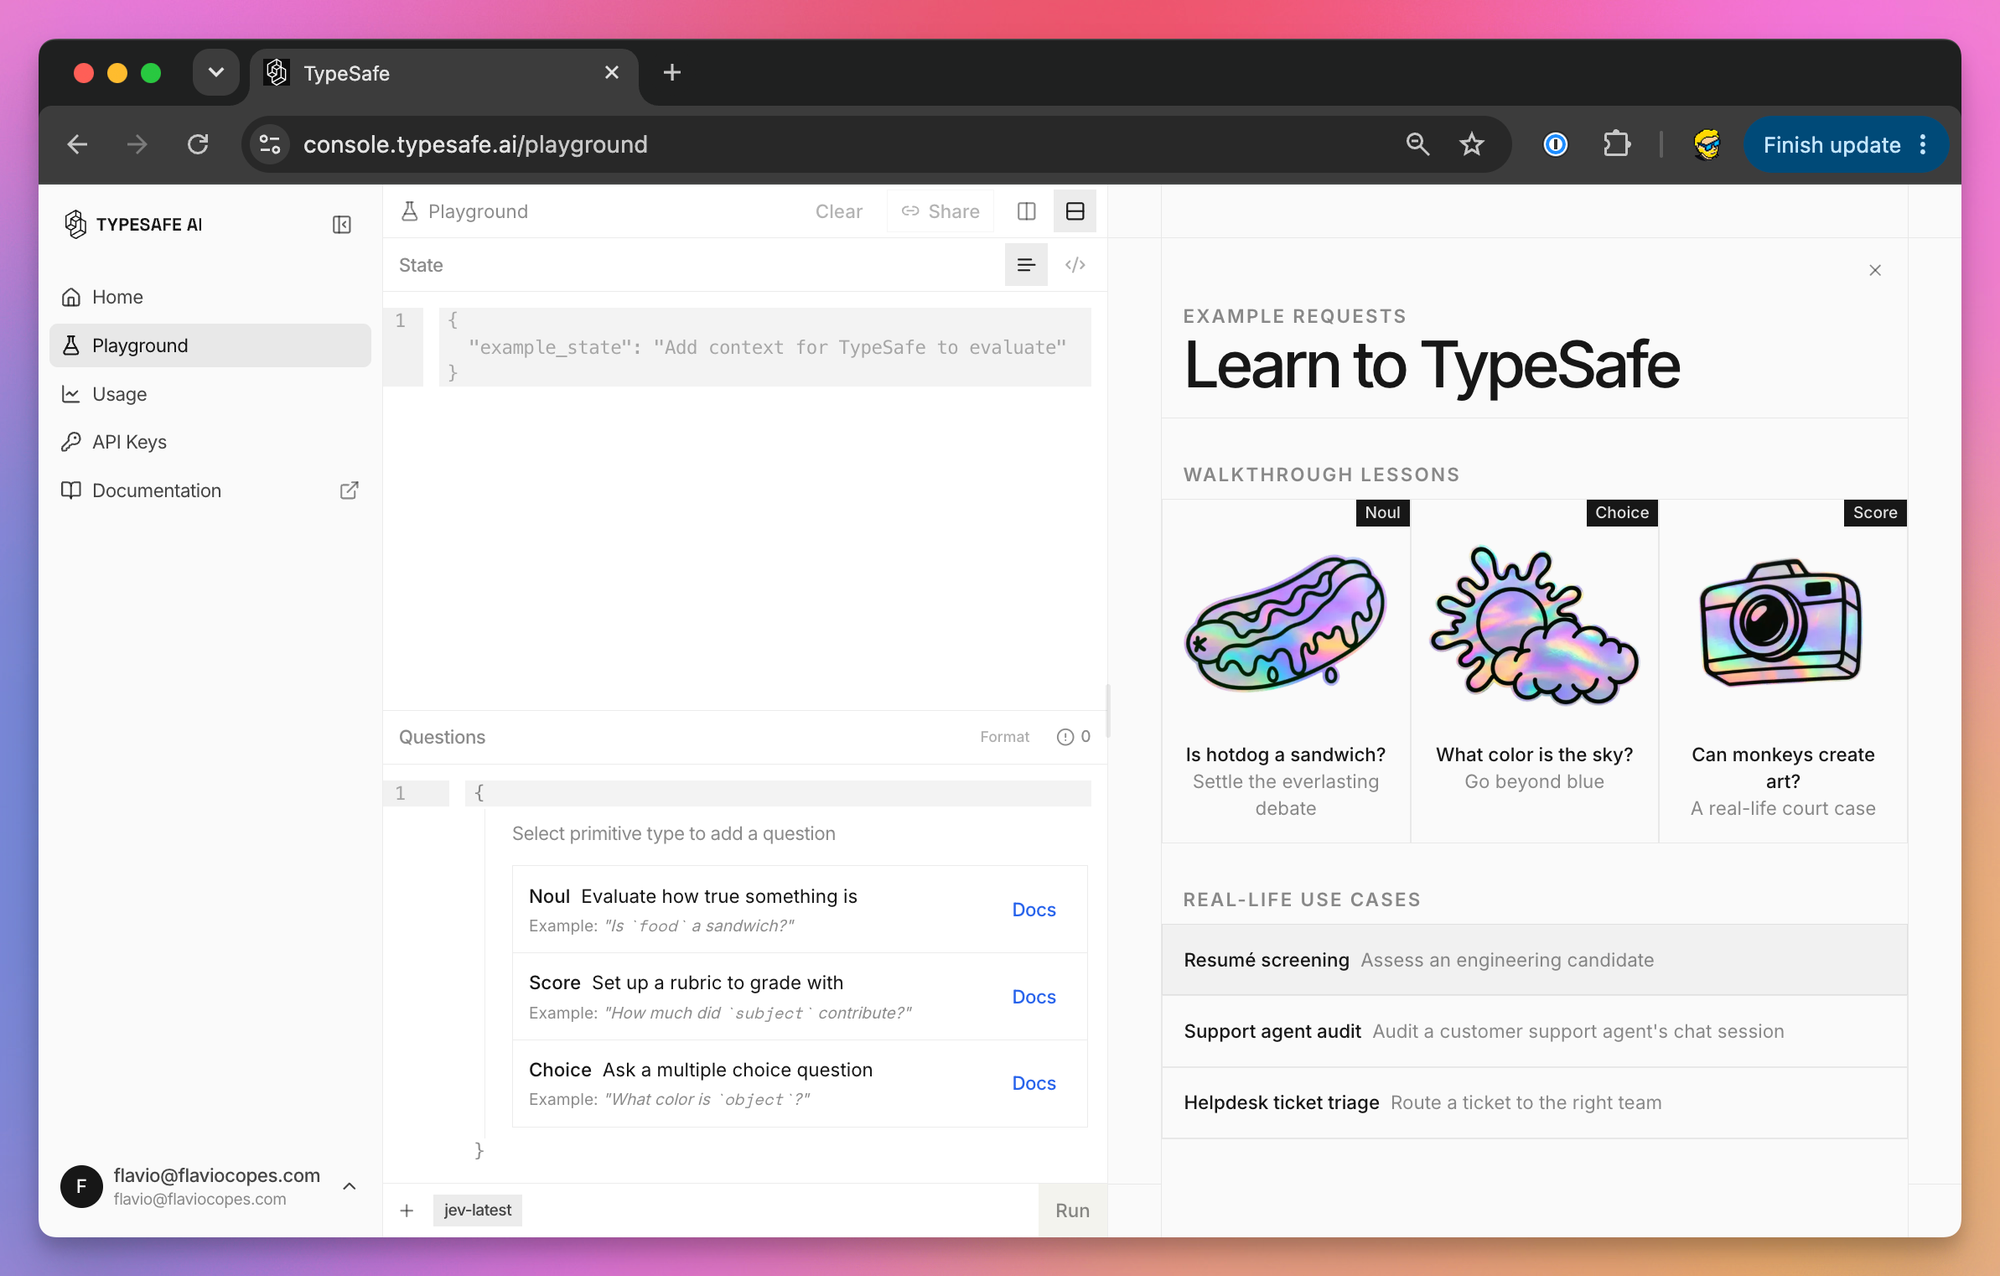
API keys live in the console too, under API Keys. Usage shows your token consumption. The full signup and key walkthrough is in How to get access to Jev and an API key.
If you don’t have a TypeSafe account, Jev is also on Vercel’s AI Gateway as typesafe-ai/jev, at the same $0.042 per million input tokens. That path uses the AI SDK instead of TypeSafe’s own, and I’ll cover it below.
Your first call with curl
Evaluations go through one endpoint:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
Set your key in the environment and send the sponsor-form example from the top of this post:
export TYPESAFE_API_KEY=your_key_here

curl -s https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {
      "opportunity": "link",
      "name": "Managed Postgres",
      "description": "We make a managed PostgreSQL hosting product and would like to sponsor the newsletter in October."
    },
    "questions": {
      "is_sponsor_inquiry": {
        "type": "noul",
        "instructions": "Does `description` ask to sponsor the site or newsletter?"
      }
    }
  }'
You get back the answers object, the versioned model that answered, and usage with input and output token counts.
The API returns 401 for a missing or wrong key, 422 when the body fails validation (the response says which field), 429 for rate limits and 529 when the service is overloaded. Retry the last two with exponential backoff, which the SDKs do for you.
Rate limits are set per organization. Check the developer console for your requests-per-second and tokens-per-second limits; exceeding either returns 429.
GET /v1/models lists the aliases your account can send in the model field. Versioned IDs such as jev-1.13.0 work even when not in that list.
Using Jev from Node.js
The JavaScript SDK is @typesafe-ai/sdk. It needs Node.js 20 or newer and ships ESM, CommonJS and TypeScript types. This is the short version. The full walkthrough, with install, Noul, Choice and Score, errors, retries and a complete script, is in how to use Jev in Node.js.
npm install @typesafe-ai/sdkThe client reads TYPESAFE_API_KEY from the environment. Three helper functions, noul, choice and score, build the questions, and the answer types are inferred from them:
import { choice, noul, score, TypeSafeClient } from '@typesafe-ai/sdk'

const client = new TypeSafeClient()

const ticket = 'The export button crashes the settings page in Safari. Works in Chrome, but some of our customers only use Safari.'

const { answers, model, usage } = await client.systemOne({
  state: { ticket },
  questions: {
    category: choice('What kind of ticket is `ticket`?', {
      bug_report: 'Something is broken or behaving wrong',
      feature_request: 'Asks for something that does not exist yet',
      billing: 'Charges, invoices, refunds',
      other: null,
    }),
    severity: score('How severe is the issue in `ticket`?', [
      'Cosmetic; no impact on functionality',
      'Broken or degraded feature, but a workaround exists',
      'Blocking issue; no workaround exists',
    ]),
    has_repro_steps: noul('Does `ticket` say how to reproduce the problem?'),
  },
})

console.log(answers.category.choice)
console.log(answers.severity.score)
console.log(answers.has_repro_steps.noul)
console.log(model)
console.log(usage.input_tokens)
A null description on a Choice option means “no extra detail”, which is fine for an other bucket.
In TypeScript, answers.category.choice is typed as 'bug_report' | 'feature_request' | 'billing' | 'other', so you get autocomplete, unknown labels fail type checking, and a never assertion gives you an exhaustive switch.
You can pass model: 'jev-1.13.0' in the request to pin a version, and per-call timeout, retry and signal options as a second argument to systemOne().
Python in a few lines
The Python SDK is typesafe-sdk and needs Python 3.10 or newer. The full walkthrough is in how to use Jev with Python. Install it with:
pip install typesafe-sdkSame shape, with Choice, Noul and Score classes:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state="I was charged twice for order A-104. Please refund the duplicate.",
    questions={
        "department": Choice(
            instructions="Which team should handle this?",
            criteria={
                "billing": "Charges, invoices, refunds",
                "technical": "Bugs and integration problems",
                "other": None,
            },
        ),
        "refund_requested": Noul(
            instructions="Does the customer ask for money back?",
        ),
    },
)

print(response.answers["department"].choice)
print(response.answers["refund_requested"].noul)
There’s an AsyncTypeSafeClient too, and a configurable retry policy.
Using Jev through the Vercel AI SDK
If your app already uses the Vercel AI SDK, you don’t need a second client. AI SDK 7 (from 7.0.105) has an experimental_evaluate function built for this kind of model, with TypeSafe as its native provider. I cover the whole setup in how to use Jev with the Vercel AI SDK.
Both packages need Node.js 22 or newer. Install them and set TYPESAFE_AI_API_KEY:
npm install ai @ai-sdk/typesafe-ai
export TYPESAFE_AI_API_KEY=your_key_here
The vocabulary differs slightly: the yes/no type is boolean and its answer field probability. Choice and Score keep their names.
import { experimental_evaluate as evaluate } from 'ai'
import { typeSafeAi } from '@ai-sdk/typesafe-ai'

const result = await evaluate({
  model: typeSafeAi.evaluationModel('jev-latest'),
  state: { message: 'I was charged twice. Please refund the extra charge.' },
  questions: {
    department: {
      type: 'choice',
      instructions: 'Which team should handle `message`?',
      criteria: {
        billing: 'Payments and refunds',
        support: 'Everything else',
      },
    },
    requests_refund: {
      type: 'boolean',
      instructions: 'Is the customer asking for money back?',
    },
  },
})

console.log(result.answers.department.choice)
console.log(result.answers.requests_refund.probability)
Through the AI Gateway you skip the provider package and pass a string model ID, which resolves through the Gateway once AI_GATEWAY_API_KEY is set:
const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: {
    refunded: {
      type: 'boolean',
      instructions: 'Was a refund issued?',
    },
  },
  providerOptions: {
    gateway: { zeroDataRetention: true },
  },
})
zeroDataRetention is a Gateway option on Vercel Pro and Enterprise plans. It stops Vercel and the provider from retaining prompt and output after processing, and disallows training on them. The request still travels to both. TypeSafe’s direct service only advertises ZDR for enterprise customers, so don’t assume the same option in its own SDK.
TypeSafe’s confidence is not in result.answers. It lives at result.providerMetadata.typesafe.confidence, keyed by question ID. And experimental_evaluate also works with OpenAI, Anthropic and Google models through an adapter that prompts them for structured output, handy for comparing Jev against an LLM on your own labeled data. Those adapters return no probability distributions and their boolean probabilities aren’t promised to be calibrated, so compare on accuracy, cost and latency, not confidence.
Run both on the server. The TypeSafe SDK blocks browser use by default, because an API key in client-side JavaScript is exposed.
Ask everything at once
This is the habit that changes how you design with Jev, and the one coding agents get wrong most often.
LLM calls are slow and expensive, so workflows ask one question, then decide what to ask next. With Jev every question runs in parallel against the same state, and each extra one costs only its own tokens. Ask every independent question you might need in one call, even those that only matter for some inputs, and let your code decide which answers to use.
TypeSafe calls this speculative fan-out. In one cookbook, 13 questions in one call were 12.2x cheaper and 10x faster than 13 sequential calls. The test used jev-1.12 and a 53,777-character document, so most of the saving came from sending that state once. Concurrent separate calls would close the latency gap, not the cost gap. Batching had no effect on the answers beyond sampling noise.
Here is a support triage in one request. Bug severity only matters for bugs, the refund question only for billing. I ask all of them anyway:
import { choice, noul, score, TypeSafeClient } from '@typesafe-ai/sdk'

const client = new TypeSafeClient()

const TRIAGE = {
  category: choice('What kind of ticket is `ticket`?', {
    bug_report: 'Something is broken or behaving wrong',
    billing: 'Charges, invoices, refunds, subscriptions',
    feature_request: 'Asks for something that does not exist yet',
    other: null,
  }),
  bug_severity: score('If `ticket` reports a bug, how severe is it?', [
    'Cosmetic; no impact on functionality',
    'Broken or degraded feature, but a workaround exists',
    'Blocking issue; no workaround exists',
  ]),
  has_repro_steps: noul('Does `ticket` include steps to reproduce a problem?'),
  refund_requested: noul('Does `ticket` ask for money back?'),
  frustration: score('How frustrated is the author of `ticket`?', [
    'Calm, just stating facts',
    'Frustrated but civil',
    'Very angry, strong language, or threatening to leave',
  ]),
}

export async function triage(ticket) {
  const { answers } = await client.systemOne({
    state: { ticket },
    questions: TRIAGE,
  })

  const { category, bug_severity, has_repro_steps, refund_requested, frustration } = answers

  if (category.confidence < 0.6) {
    return { route: 'human', reason: 'unclear category' }
  }

  if (category.choice === 'bug_report') {
    if (bug_severity.score > 1.5 && has_repro_steps.noul > 0.6) {
      return { route: 'engineering', priority: 'high' }
    }
    return { route: 'bug_backlog' }
  }

  if (category.choice === 'billing') {
    return { route: 'billing', refundLikely: refund_requested.noul > 0.7 }
  }

  if (category.choice === 'feature_request') {
    return { route: 'product' }
  }

  return { route: 'human', flag: frustration.score > 1.5 }
}
One call feeds the whole decision tree. For a feature request, bug_severity is ignored. It cost its own tokens, but the shared state was sent once.
Notice the questions live in one constant, with the thresholds in the same file. That’s what a reviewer needs to read.
You only need a second request when your code can’t build it until it has the first answer, because it must fetch more data or the first answer decides the next question’s options. TypeSafe’s skill-suggestion cookbook does this: one request ranks 182 skills, a second looks at the full text of the top three and can reject them all. If the second request could have run against the original state, fold it into the first.
Compose decisions in code
The second habit is for judgments that depend on several things. Ask one question per thing and combine the answers with weights you own.
Ticket priority depends on how bad the bug is, how upset the customer is, and how much the report gives an engineer to work with. Three Scores, one request:
const PRIORITY_QUESTIONS = {
  severity: score('How severe is the issue in `ticket`?', [
    'Cosmetic; no impact on functionality',
    'Broken or degraded feature, but a workaround exists',
    'Blocking issue; no workaround exists',
  ]),
  frustration: score('How frustrated is the author of `ticket`?', [
    'Calm, just stating facts',
    'Frustrated but civil',
    'Very angry or threatening to leave',
  ]),
  report_quality: score('How much does `ticket` give an engineer to work with?', [
    'No detail; just says something is broken',
    'Names the feature but no steps or environment',
    'Steps to reproduce or environment, but not both',
    'Steps to reproduce and environment',
  ]),
}

function normalized(answers, id) {
  const topLevel = PRIORITY_QUESTIONS[id].criteria.length - 1
  return answers[id].score / topLevel
}

export async function priority(ticket) {
  const { answers } = await client.systemOne({
    state: { ticket },
    questions: PRIORITY_QUESTIONS,
  })

  return (
    0.6 * normalized(answers, 'severity') +
    0.3 * normalized(answers, 'frustration') +
    0.1 * normalized(answers, 'report_quality')
  )
}
The scales have different lengths (three levels return 0 to 2, four return 0 to 3), so each score is divided by its top level before weighting. Then 0.6 on severity means severity counts twice as much as frustration.
When the ranking doesn’t match what your team would decide, change a coefficient and rerun. There’s no prompt to rewrite. TypeSafe calls this composite scoring.
The third pattern is intent routing, where most early experiments land. Some requests need a database lookup, some an LLM with the right context, a few a person. Jev sits in front and decides which:
const { answers } = await client.systemOne({
  state: { message },
  questions: {
    intent: choice('What does the author of `message` want?', {
      order_status: 'Where is my order, has it shipped, tracking',
      product_question: 'How a product works, compatibility, specs',
      return_exchange: 'Return, exchange, or replace an item',
      complaint: 'Unhappy with service or product, wants a resolution',
    }),
    needs_reasoning: score('How much thought does a good answer to `message` need?', [
      'A lookup or a one-line fact',
      'A short explanation using product knowledge',
      'A judgment call with trade-offs or an unhappy customer',
    ]),
  },
})

if (answers.intent.confidence < 0.5) {
  return routeToHuman(message)
}

switch (answers.intent.choice) {
  case 'order_status':
    return lookupOrder(message) // no LLM involved
  case 'product_question':
    return answerWithLLM(message, PRODUCT_CONTEXT)
  case 'return_exchange':
    return answerWithLLM(message, RETURNS_CONTEXT)
  case 'complaint':
    return answers.needs_reasoning.score > 1 ? routeToHuman(message) : answerWithLLM(message, COMPLAINT_CONTEXT)
}
The order lookup never touches an LLM, two intents get an LLM with different context, and complaints use the second score to pick LLM or human, so the expensive resources only run when a message needs them.
The same shape works as a model router inside an agent: ask how much reasoning a message needs and which profile it fits, then pick the cheap or the expensive model. One proposed migration reduced a routing prompt to those two questions.
Writing questions Jev answers well
Most of the skill is in the questions. Everything below comes from the docs, the console lessons, and the mistakes people reported in the first days.
One judgment per question. “Does this message convey urgency?” is good. “Analyze this message and decide the best course of action” hides several judgments behind one answer. If a question weighs several factors, split it.
Write the exact condition. Jev answers the question you wrote, not the one you meant; scoping words, negations and implied conditions are read literally. When a wrong answer makes you explain what you really meant, that explanation is the missing half of the instruction.
In criteria, describe situations rather than degrees: what belongs to a Choice option and what belongs to its neighbor, a concrete state of the world for a Score level. When the model keeps landing between two levels on inputs you consider clear, give each level an object with a description and a few examples, same field names on every level:
{
  "what": "Broken or degraded feature, but a workaround exists",
  "examples": ["export fails in one browser but works in another"]
}
The docs measured this on a Safari export bug: plain string levels gave 1.43 at 0.35 confidence, the same levels with one relevant example gave 1.03 at 0.96. An unrelated example left it at 1.43 and 0.35. Examples help when they look like your real inputs.
Give the model an exit: an other option on every Choice that might not cover every input, and “not stated” when extracting something that may be missing. Keep instructions and criteria saying the same thing in plain language, because when they disagree the answer degrades.
Numbers, dates and counting stay in code. The next section explains why.
For the surrounding code, put every question and threshold in one file, because that’s the part a human needs to review. Then test against labeled examples before trusting a threshold: run inputs you know the answer for and look at where confidence and accuracy diverge. One early test got 11 invoice cases out of 11 right after its rubric was written down. That order, rubric first, matches the docs.
Where Jev breaks
TypeSafe publishes a “jaggedness” page per model version, listing what jev-1.13 does badly. Here it is, with the fix for each.
The first is literal reading, covered above. The model reads your words, not your intent. Be explicit, or split the interpretation into two literal questions.
Then there’s math. Jev is not a calculator and does not count reliably, whether characters, occurrences, or items in a list. It can’t tell whether two hex colors are close: named colors work, #FF4B0A doesn’t. Do the arithmetic in code and pass in the result or a named bucket.
If you need to count items that match a semantic condition, ask one Noul per item and sum in code:
const items = ['typesafe', 'apple', 'california', 'banana', 'orange']

const questions = Object.fromEntries(
  items.map((_, i) => [`item_${i}`, noul(`Is \`items[${i}]\` the name of a fruit?`)])
)

const { answers } = await client.systemOne({ state: { items }, questions })

const fruits = items.filter((_, i) => answers[`item_${i}`].noul > 0.5)
console.log(fruits.length) // 3
A Score is not a measurement either. A 1.4 does not mean “40% of the way from frustrated to angry”, because the levels are weakly calibrated against each other. Use it to pass a threshold or to rank, not to interpolate a magnitude.
Dates have the same problem. Jev reads a date as text, so which comes first, how far apart, whether one falls in a window, all of it is unreliable, worse with mixed formats or relative references. Extract with a Choice over months, days and years plus a “not stated” option, then build a real date in code and compare there.
Indirection costs accuracy: double negatives, a property of a property, anything with multiple hops. Point directly at the relevant part of the state.
A large state full of irrelevant detail costs accuracy too. Filter first. When you can’t do it deterministically, ask a Noul per chunk, “is this relevant to the question?”, and drop the rest.
Typed output does not guarantee correct routing. A Choice always returns an allowed destination and can still be the wrong one. Version the model, questions, criteria, and thresholds together, and replay a set of known inputs whenever any of them change.
State is treated as data, but text written to steer the model can still move the answer. TypeSafe says it expects to improve on adversarial content. For now, write precise criteria and test with hostile inputs before going public.
Contradictions between instructions and criteria, like a Noul where true means “no”, make the answers worse.
And it can’t write. You can force text out by chaining Choices over characters, and the docs are blunt that this works badly and slowly. To extract a value, find the candidates with a regex or an LLM and let Jev pick.
A useful rule is that with Jev you pick a card from the deck instead of asking it to name one. When your instinct says “extract X”, rephrase as “here are the candidates for X, which one is it?”
What people are building with it
Many of the examples below come from the launch period. Treat demos and production measurements separately.
The easiest way to follow them is shipwithjev.com, an independent catalog of Jev builds, not affiliated with TypeSafe. It listed 551 builds on September 23, 2026, grouped by category, and many entries carry the cost and latency their authors reported. Those are the authors’ numbers, not independent measurements.
The first production report comes from Metaview, a recruiting platform. It says it shipped Jev into every agent on its platform over a weekend, and candidate searches in its sourcing product went from minutes to seconds, about 10x faster, at the same accuracy and a lower cost per search.
A later Jack & Jill case study, published on October 7, describes replacing Gemini in the initial candidate-screening stage. The reported cost per 1,000 candidates fell from $0.755 to $0.092, about 88%, while median screening time per role fell from 20.3 to 10.3 seconds. An offline comparison across 150 live roles found similar quality. The projected $500,000 annual saving assumes growth in volume; the estimate at current volume was $265,000. These are the company’s reported results, not an independent benchmark.
Labeling data
Labeling is the obvious use. One demo classified 1,018 summarized AI research papers across 24 topics for $0.08, median latency 256 milliseconds per paper (the LLM summaries cost another $3.99). Another ran 98,000 listing classifications in ten minutes. A third reported half a million input tokens for about two cents, matching the published price. Anything shaped like “label every row” fits.
Resume screening is the same shape with a rubric: fit for this job posting, as a Score. A hiring site reported about one tenth the cost of small LLMs for that job. The console ships it as a built-in example.
So is inbox triage: priority, spam or not, needs a reply or not, one call per email, fast enough to watch it work through a mailbox.
Resume screening also works in reverse. One developer ran his resume against all 6,245 Y Combinator companies in 25 seconds, for $0.37, and got a list of 156 founders worth contacting.
Marketing data fits too. A teardown of 724 live ads from 37 brands took about 40 seconds and nine cents. For each ad, Jev picked the hook, the format, the offer, the call to action and the awareness stage, and flagged any mismatch with the landing page. A survey research product rebuilt on Jev (200 samples, 12 questions per survey) reported running twice as fast as Gemini 3.5 Flash-Lite at 85% lower cost.
Routing and verification
Intent and model routing were among the most suggested uses: one call in front of a support flow or an agent, deciding which handler or which model gets the message.
Routing also works for business processes. A deal-review demo reads a sales deal and says what comes next: approval, more documents, or review by sales, finance and legal. One deal can need several of those teams at once. Jev maps that out, and people still make the call.
Verification is the other side. One proposed workflow takes a podcast site that generates episode summaries with an LLM and checks each claim against the transcript with a Noul, flagging low-probability answers. The LLM writes the summary, Jev checks it, and code decides which claims need review.
Another developer added Jev to a coding agent loop with a single job: answer “is the task done?”. It’s a small question, and a coding agent asks it many times per task.
Podcasts show up again in MinusPodJev, which plugs Jev into MinusPod, a self-hosted server that removes ads from podcasts. It asks one Noul per transcript segment, joins the flagged segments into ad spans, and returns them in the format MinusPod expects from an OpenAI-compatible model. Chapter titles still need a chat model, because Jev can’t write them.
Code review fits the same mold: per modified file in a PR, Scores and Nouls on security risk, complexity, bad practices and commit message quality, combined into a risk matrix in code.
TypeSafe’s cookbooks push into retrieval: re-ranking BM25 shortlists with a Noul per query-passage pair, scoring passages for relevance and hidden prompt injections before they reach the answering model, and checking whether a citation supports its claim.
Search
Several open source builds use Jev for search, and they follow the same pattern: a cheap keyword pass finds candidates, then Jev ranks them by what the person meant.
jevsearch is a drop-in site search for React and shadcn/ui. Keyword hits appear on the first keystroke, then Jev re-ranks the top candidates by intent, with no embeddings and no vector database. If TypeSafe is slow or down, the keyword order stays. Its author reports a 278 ms median and $0.26 per 1,000 uncached searches. Most site search, including the Pagefind search on this site, stops at the keyword pass.
JevQL brings the same idea to plain PostgreSQL. You write normal SQL with a jev() filter:
SELECT title, organizer
FROM meetings
WHERE jev(meetings, 'could have been an email')
  AND starts_at > now();
The JevQL CLI evaluates the jev() calls and sends ordinary SQL to the database, so there’s no extension to install and no superuser needed. It also has SDKs and an MCP server. Every row that reaches a jev() filter is a judgment you pay for, so keep the normal conditions next to it, and use --explain to see a cost estimate before any API call.
Oko does it for code. It runs locally, finds candidate snippets, lets Jev rank them, and serves the best ones to Codex, Claude Code or OpenCode over MCP, so the agent reads less irrelevant code. On a public benchmark of 345 code-retrieval tasks in six languages, it puts a right file first more often than other published methods (MRR 0.39 against 0.24), and in its authors’ own benchmark the agents finished tasks 12 to 38% faster.
The same shape works for smaller lookups. A settings finder lets you describe what you want to change and returns the matching control. A CLI wrapper gives “Did you mean?” suggestions by meaning: type git record and it suggests git commit, which no typo-distance algorithm would find.
Inside apps that already exist
Some builds add Jev to software people already use, as one more decision inside an existing workflow.
Spliit Cloud, an open source expense splitter, suggests a category for each new expense with a Jev Choice. It checks its local dictionary and the group’s history first, and users review the suggestions Jev is unsure about. That’s the same boundary as the Shared Expense Tracker exercise I describe below.
A Magento 2 module asks a fixed set of Nouls and Choices about orders, customers, products, reviews and abandoned carts. Every question for an entity goes in one API call when the entity is saved, and the answer, confidence and full probability breakdown are stored on it and shown in the admin.
A house-style formatter for Word documents splits the work between two models. An LLM reads your house style once and describes each style in it. Then, for every paragraph of a contract, Jev picks which of those styles applies.
Real-time interfaces
A few hundred milliseconds per call means Jev can run on every keystroke pause. One editor demo scored tone, conviction, urgency and “reads as AI-written” while the user typed, with criteria the developer defined rather than a fixed detector.
A browser extension asks, per post in a social feed, whether it’s rage bait, crypto promotion or political argument, and hides the ones that score high. The user defines the categories, not the platform.
Games showed up early too. A Tetris demo chose between rotate, move and drop. A driving simulator passed structured observations and asked whether to accelerate, brake or turn. TypeSafe’s launch demos include a Doom bot on structured game state at about ten queries a second, costed at roughly $7 an hour, and a Wikiracing bot choosing among hundreds of links per step without ever picking one that doesn’t exist.
A Pac-Man demo shows the loop: on every tile the app sends the nearby game state, Jev returns a direction, a strategy, a danger score, and flags such as trapped or committed, code moves the character and sends the next state.
Robotics is a smaller corner with the same split. A dual-arm robot project gives Jev the middle of three control layers: it makes the decisions, while inverse kinematics and physics stay in code, at about 500 ms and half a yen per attempt. A simulated traffic light ran on near-real-time traffic feeds for under a cent in total, and its author’s favorite moment was watching it decide to do nothing.
Other demos: a Rubik’s Cube, an experimental programming language, natural-language database search, browser and operating-system control, speech-to-text cleanup, fraud detection, classifying scraped content. They show how many kinds of problems fit, not that any of it is production-ready.
Agents and tools
A chatbot demo used no generative LLM. It asked Jev “which tool answers the user’s last message?” as a Choice, with the arguments in the same call: which city, which time frame, which unit, each a Choice over candidates found in the conversation. Code called the tool. It turned a smart-home light off from a plain sentence in about 300 milliseconds end to end, and answered “how tall is Mount Rainier?” by fetching Wikipedia and having Jev point at the sentence with the answer.
Browser automation splits the same way: a planner LLM sets the goal, Jev picks which element to click next as a Choice over the interactive elements. One demo booked a flight in about seven seconds. If you’ve watched a Playwright agent think for ten seconds between clicks, you know why that matters.
Hunch, an open source browser agent, is built entirely around that split. Jev maps an accessibility snapshot of the page to the next operation, code checks the result, and uncertain or irreversible steps go to an LLM. Its author reports a 153 ms median per decision, 24 correct decisions out of 24, and a four-step form filled in 3.4 seconds.
Jive applies it to a terminal coding agent: frontier LLMs plan and handle exceptions, Jev makes the repetitive decisions in between.
A semantic linter for a large codebase: split changed code into chunks, ask whether each needs attention, what kind of problem it has, how risky it is. Rank, then send only the top chunks to a coding model that can explain and fix them.
If a chunk lacks context, offer options such as open_file, previous_chunk, or next_chunk. Jev picks one, code fetches the context, a second evaluation continues from there. Jev finds where to look; the coding model edits.
Logs are a smaller first project. Instead of an LLM explaining every line, ask Jev which entries are expected noise, a forgotten scheduled job, a user-facing failure, or something needing attention. Code groups and ranks before involving a person or another model.
Natural-language PostgreSQL search needs the same split. Don’t ask Jev to generate SQL. Code provides allowed query templates, tables, columns, and filters; Jev selects the intent and options; code builds a parameterized query. The model handles meaning without permission to invent a database operation.
Guardrails for coding agents are the first use case I’d test: classify a shell command as read-only, reversible or irreversible before it runs. In one early shadow test, an ambiguous rm -rf came back “irreversible” at 0.56 with confidence 0.33. That 0.33 tells the code to ask a human instead of trusting the label.
And one for fun: a startup idea judge. Ten questions evaluate problem, demand, monetization, distribution and differentiation in about half a second, and code combines them into kill, fix or ship. The result is only as good as the rubrics.
Feature engineering
Turn free text into numeric features for a classical model. TypeSafe’s feature-discovery cookbook starts with 18 questions and ends with 38 after five rounds. Those answers become 67 numeric columns for a CatBoost regressor.
The skeptical notes
The useful metric is cost per solved task, not per token. If the cheap path adds retries or human review, the savings shrink. Most of these use-case lists will turn into two or three integrations with real traffic. And where deterministic code already decides correctly, code stays.
The demos prove many problems map to typed decisions. They don’t show which ones make money, survive real traffic, or stay accurate after the model changes. That needs production measurements. Every cost and latency in this section, including the production reports, comes from builders or TypeSafe’s case studies.
Jev and coding agents
TypeSafe published an agent skill. Install it before asking an agent to integrate Jev, because agents trained on LLM APIs ask one question per call and invent request fields.
For Claude Code:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
For Cursor, Codex and everything else:
npx skills add typesafe-ai/skills --skill typesafe-aiThe skill points the agent at the live docs (Mintlify serves any page as Markdown by appending .md to the URL), lists the primitives, and explains fan-out and confidence gating.
The prompt TypeSafe suggests as a first step is the one I’d use too:
Using the TypeSafe skill, explore the project and find opportunities for using
intelligent judgement to stand in for complex parsing or other fragile code.
Review what it proposes before it writes anything, and make it put every question and threshold in one file. Agents aren’t great at writing questions, so you’ll be editing them together.
How I will use Jev in my workflows
I have console access but haven’t put Jev into production yet. My plan is to start with decisions I already make every day, run Jev in shadow mode beside the current workflow, and compare its answers before letting it control anything.
Route work before starting a coding agent
I use coding agents for small fixes, long research, browser work, and jobs across several repositories. They don’t all need the same model or environment.
I can give Jev the task, the repository name, and a description of the available agents. A Choice picks a route: deterministic_script, fast_agent, reasoning_agent, browser_agent, or human. A Score measures how ambiguous the request is, a Noul whether it needs logged-in applications on my computer.
Jev would not start the agent. My code reads the answers, applies confidence thresholds, and sends the task to the workflow I already use.
Put a safety check in front of shell commands
Before a coding agent runs a command, I can send Jev the command, current directory, and a small amount of repository state.
A Choice classifies it as read_only, reversible, or irreversible. Nouls check whether it deletes files, changes Git history, deploys to production, or touches anything outside the repository.
At first I would only log the answers. With enough real examples, high-confidence read-only commands could run, while uncertain or destructive ones still ask me.
Prefilter the blog maintenance work
This blog has more than 2,000 posts. Many contain software versions, prices, service limits, and links that become stale.
The tempting question is “is this version number outdated?”, but comparing 18.17.1 with 24.15.0 belongs in code.
I would use Jev one step earlier, on each paragraph:
- Does this paragraph contain a version claim?
- Does it state a price or usage limit?
- Does it describe a product interface that may have changed?
- Would checking this claim require current external documentation?
Code collects the paragraphs that cross the threshold, and a coding agent or a script checks only those against current sources. Jev filters the work; it does not rewrite the posts.
Sort sponsor inquiries and newsletter replies
My sponsor form already sends structured submissions through a Cloudflare Pages Function. I can add a Noul for whether it’s a real sponsorship inquiry, a Choice for the product category, and a Score for how specific the request is.
I would start by adding those answers to the email I already receive, and keep making the decision myself. If the labels hold up, code can prepare the right reply or rate card without sending anything automatically.
Newsletter replies get a smaller version of the same questions: a Choice between thank-you, broken link, question, sponsorship lead, and other, so I open the ones that need a response first.
Add semantic priority to Events Logger
Events Logger collects events from my applications into one dashboard. Each event has a project, category and title, plus an optional description and tags.
I can add a Score for severity and Nouls for whether the event is a user-facing failure, lost money, or something that needs action. The feed stays chronological, with a second view ordered by semantic priority.
It’s a good first production test, because a wrong answer only reorders a dashboard and never touches data or infrastructure.
Try it in the Bootcamp projects
The Bootcamp projects are a good way to teach where a decision model belongs. Jev would be an optional extension after the core project works, not a day-one dependency.
Each project has at least one place where normal code handles the facts and Jev can handle a fuzzy judgment:
| Bootcamp project | What I would ask Jev | What stays in code |
|---|---|---|
| Personal Dashboard | Which existing category best fits a new link? | URL validation, storage, editing, and ordering |
| Events Dashboard | Is this event expected noise, a user-facing failure, or something urgent? | API authentication, event ingestion, search, and charts |
| Shared Expense Tracker | Which expense category fits this description? | Amounts, balances, splits, and who owes whom |
| Live Chat Room | Is this message spam, abusive, or likely to need moderation? | Authentication, rooms, message delivery, and mentions |
| Recipe Finder | Does a generated recipe respect the requested diet and ingredients? | Recipe generation, caching, bookmarks, and image loading |
| Port Pilot | Does this process look safe to stop, uncertain, or likely to be a system service? | Reading ports and processes, parsing exact values, and sending signals |
| Recipe Finder Pro | Which model should handle this recipe request based on its complexity? | Payments, subscriptions, entitlements, and access control |
| Your Own Product | Which fuzzy decision inside this product would benefit from a typed probability? | The product’s main workflow and every deterministic rule |
The Shared Expense Tracker shows the boundary. Jev can read “pizza with Luca and Sara” and suggest food, but it never calculates who owes what, because that arithmetic has to be exact.
Port Pilot is stricter. Jev can add a risk label beside a process, but never kill anything. The operating-system query, PID checks, and confirmation stay in code.
In the Recipe Finder the language model still creates the recipes. Jev checks whether a result matches the diet, uses the supplied ingredients, or needs another attempt, which shows students how generative and decision models work together.
I would turn this into the same small exercise for every project:
- Finish the deterministic version first.
- Find one decision that requires understanding meaning.
- Write the possible answers before calling Jev.
- Collect at least 20 realistic inputs with expected answers.
- Run Jev without changing the application’s behavior.
- Review the mistakes and adjust the questions.
- Automate only a low-risk result.
Each Bootcamp week keeps its subject: databases, APIs, authentication, real-time data, AI generation, CLI tools, product development. Jev is one more tool to add when the project needs judgment.
How I will roll this out
I would use the same process for each workflow:
- Keep the existing behavior.
- Run Jev beside it and log the full answers.
- Label the cases where its decision was right or wrong.
- Adjust the questions and thresholds using that data.
- Automate the low-risk path first.
- Keep a human or a stronger model for uncertain cases.
I would not use Jev for writing, summarizing, or precise arithmetic. Image input is now available experimentally; I would keep it in prototypes while evaluating its accuracy. And I’d leave deterministic code alone when it already decides correctly: an if that costs nothing beats a model call that can be wrong.
What it costs, and how fast it is
$0.042 per million input tokens, output free. TypeSafe’s homepage says $42 per billion tokens, the same number in a form that makes the point.
A support ticket with its questions runs around 300 tokens in TypeSafe’s examples: about $0.0000126 per call, or $1.26 for 100,000 tickets of the same size. To compare against an LLM on your own workload, the token cost calculator and the inference cost tool on this site take the same per-million inputs. How much does Jev cost? covers billing, workload estimates, rate limits, Vercel pricing and how it compares with LLMs.
Vercel’s AI Gateway lists the same rate, billed like any other Gateway model.
On speed, TypeSafe quotes 70 to 500 milliseconds end to end, most around 100, measured from the US West Coast where the service runs. From Italy I’d expect network latency on top, so measure before promising anything to a user interface. Whether the claimed 40x to 200x speedup holds depends on which LLM and which task; the company itself calls its headline multiples the high end.
Rate limits depend on your organization, so check your current allowance in the developer console before sizing a batch job.
Could Jev cut an AI bill by 50 or 60 percent?
It could, but it depends on the workload. Jev only reduces the part of the bill spent on decisions it can replace.
The rough calculation is:
total savings = classification share × savings on those callsA company spends $10,000 a month on AI. If $6,000 goes to classification, routing, scoring, and verification, and the new path costs 5% of the old one, the saving is $5,700, or 57% of the bill.
If classification is only 10% of the workload, even making those calls free saves at most 10%.
The big savings come at scale. A company running a general model over hundreds of millions of records for one small judgment each can route that to Jev and keep the frontier model for reasoning and generated output.
Measure the whole pipeline: preprocessing, retries, failed requests, human review, and any generative step before or after Jev. The research-paper example cost $0.08 in Jev classification and $3.99 in summaries.
Experimental image input is billed as input tokens too. Audio and video still need preprocessing, such as transcription or extracting still frames, and that work belongs in the cost calculation.
Where to start
Sign in at typesafe.ai if you have an account, or use the Gateway path with a Vercel account while TypeSafe’s signups are paused. How to get access to Jev and an API key walks through both routes.
Spend the first hour in the Playground with your own data, not the examples: a real support message, a real log line, a real form submission.
Then pick one boring decision your code hardcodes or handles with a regex that keeps breaking: route, approve, skip. Replace it with one Noul or one Choice, log the confidence for a week beside the current behavior, and only then let it act.
Want me to talk about your product? You can sponsor this site.
~~~
Related posts about ai: