Wan Streamer:边听边看边说话的实时 AI
- Wan Streamer v0.1 是一个原生流式、端到端的交互式基础模型,在同一个 Transformer 里同时把语言、音频、视频当作输入和输出来建模,靠 block-causal attention(块状因果注意力)协调,边来边算地流式生成。
- 模型自己算一段回应大约 200ms,加上 350ms 的双向网络延迟,总交互延迟约 550ms;25fps 下,最短的流式处理单元只有 160ms。
- 官方称它是唯一能用单个端到端 Transformer 输出同步音视频、且总延迟压在 1 秒内的模型;现有系统要么只出语音(GPT-4o Realtime、豆包、Gemini Live),要么靠 ASR+LLM+TTS+动画 一串模块拼接。
- 当前 v0.1 分辨率只有 192p,定位是端到端设计的概念验证;放出来的角色演示都是未经剪辑的预录模型输出,不是在线实时体验。
- 对比图里的延迟数字混了不同测量口径:上方一组是端到端交互闭环,下方一组只算渲染阶段(不含外部 LLM/ASR/TTS),官方提示要按注释打折看。
一个模型跑通实时音视频对话
通义万相(Wan)团队最近发布了 Wan Streamer v0.1,一个实时音视频交互模型。能实时对话的 AI 现在不少,但能一边看你的脸、一边听你说话、一边开口回应、自己还自带一张会动的脸的,几乎没有。Wan Streamer 把这件事压进了一个模型里。
为什么值得看:现在能实时对话的系统分两类,一类响应快但只出声音、没有可见的脸(GPT-4o Realtime、豆包、Gemini Live),另一类有脸但靠外部 ASR、语言模型、TTS、动画一串模块拼出来。官方称 Wan Streamer 是唯一用单个端到端 Transformer 同时吐出同步音视频、且总延迟压在 1 秒内的模型。
四段角色演示 + 实时录屏
下面四段演示都出自同一个模型,只是换了人物、声音和场景。先看效果,再讲原理。
下面这段不一样:是一次真实联网对话的屏幕录制,能看到完整的实时回应链路。
旧办法为什么慢:一道道接力,每步都在等
旧办法慢,是因为它们是一串独立模型拼起来的流水线:语音先转成文字(ASR),文字喂给语言模型想答案(LLM),答案再合成语音(TTS),最后驱动一张脸动起来(动画渲染)。每过一道工序都要等上一道交货,等待时间一段段累加,识别和口型对不齐的误差也一路累积。
感知 · 推理 · 规划 · 生成 一起做
端到端像一个人自己听完直接开口;级联像传话游戏,每过一手都慢一拍,还可能把话传错。中间那层把语音/视频先转成文字、再用文字去驱动下游,文字就是各模块之间隐藏的中转桥传统级联里文本是独立训练的几个模块之间的中间表示。Wan Streamer 不要这个中间桥,模态之间直接耦合。,桥越多越慢、越容易错。
原文给这件事下了一个判断:实时音视频交互不是「多模态理解」加「多模态生成」的简单相加,它本质上是全双工的,所以可流式性是一种建模约束,而不只是上线后的工程优化。建在离线编码器、双向解码器、回合制对话之上的系统,光靠工程调优也补不出真正的低延迟全双工。这正是下一节要拆的核心。
它的办法:一个模型从听到说全包了
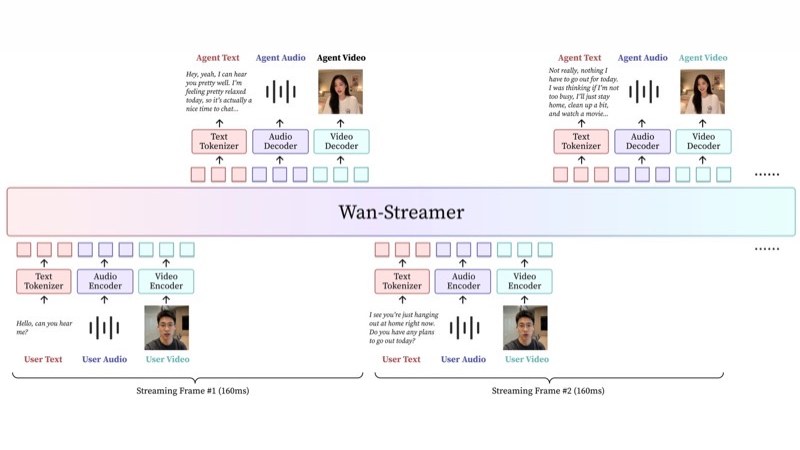
Wan Streamer 的内核只有一句话:把视觉、音频、文本的输入 token 和输出 token,交错排成同一条序列,交给一个 Transformer 处理;用 block-causal attention 协调,让它边来边算地往外吐。
单个端到端 Transformer 取消了外部的 VAD、ASR、语言模型、TTS、动画、视频生成等模块,把感知、推理、回应规划、语音与视觉生成、响应时机、轮次管理全放进同一个持久状态里联合优化。低延迟、全双工、同步音视频这三件事,根都在这里。
模型把交互看成一条连续的因果流:你的观测和它的回应,一起更新当前上下文。每个流式单元里,它编码当前能拿到的用户观测,再根据双方完整的因果历史预测下一段回应。语言回应是一串离散 token,用 next-token 预测训练;音频和视频回应活在连续的 latent 空间里,用条件 flow matching 联合生成,以同一份干净上下文为条件,让语音、动作、外观、场景演化作为一个耦合整体一起去噪,而不是各生成各的再拼。

为了撑住这条流,整栈从设计之初就是因果的:用于流式 latent 编码的严格因果音视频 VAE、因果音视频编码器、因果音视频解码器,以及由 block-causal attention 协调的时序因果 Transformer。去噪后,估计出的干净 latent 直接追加进历史,作为后续单元的上下文;因果解码器再把它们渲染成最终的音视频。被这套设计抹掉的外部模块是:
怎么做到边听边说、随时能打断
人和世界的交互天生是流式、全双工的:我们不是先听完、再单独想、最后才答,而是一边看一边听一边说、随时停顿和打断,感知和表达在音视频的时间尺度上重叠发生。实时交互模型也得长成这样。
因果编码器+因果解码器+低延迟多模态 token 调度,让 25fps 下的流式单元短到 160ms:输入的语音视频立刻影响输出,生成的音频和视觉状态在解码之前就耦合好,而不是事后修补;每个吐出来的单元都写回交互历史。于是它能边听边说,你说话时它仍在听、被打断还能调整。
全双工像正常打电话:你能一边听对方说一边插话。对讲机那种「说完松手才能听」是半双工。
这套机制能成立,靠的是 block-causal attention。它把一小块(比如 160ms 的音视频片段)当成一个处理单位:块内部的 token 可以互相看(双向),但一个块只能看见过去的块、看不到未来的块。这样既保住了块内上下文,又能边来边算,不用等整段说完。
160ms
160ms
160ms
160ms
块内 token 互相看,块之间只往左看过去:块 3 一到就能开算,因为它只依赖块 1、块 2,不用等未来的块 4。这就是流式生成。
像说话时以「词组」为单位思考:一个词组内部一起斟酌,但你不能预知还没出口的下一个词组。这里还有两个配套的因果件,因果编码器/解码器只看过去、不看未来。普通编码器要拿到完整一段才能编码,因果版可以边接收边编码,像同声传译边听边译,不必等演讲讲完。让感知和生成都能边来边走。
点开看部署细节:thinker–performer 怎么把延迟压到 200ms
Wan Streamer 训练时是单个端到端模型;实时部署时,同一个模型拆成跨两张 GPU 的 thinker–performer 流水线,尽量让计算重叠。系统 prefill 完成后,thinker 把初始 KV-cache 广播给 performer,两边共享同一份全历史状态,统一模型的行为被完整保留。
thinker 负责因果音视频编码器、一次用于语言预测与状态更新的短计算、KV-cache 构建,以及把上一单元的 latent 解码成音视频并立即输出。performer 只负责 latent 生成,基于共享的全历史 KV 上下文,为下一段音视频单元跑 flow-matching 求解器。因为 performer 从不跑解码器、thinker 从不跑高成本的求解器,解码和生成互不阻塞。
只要 performer 耗时加通信耗时能塞进一个 160ms 单元,就维持实时吞吐。而「编码 → 状态更新 → latent 生成 → 解码」这条信号到信号的路径,就是约 200ms 的模型侧延迟,靠 CUDA graph 捕获、编译、优化算子压在预算内。

和别的系统比,快在哪、能做什么
下面两组延迟数字测的不是一回事,得分开看。上方一组是完整的端到端交互闭环(感知用户并产生回应),其中只有 Wan Streamer 同时输出视频;下方一组是数字人/音视频渲染器,只计到渲染阶段,不含它们依赖的外部语言模型、ASR、TTS,所以用户实际感受到的延迟比图里更高。
能力维度的覆盖如下,Wan Streamer 是唯一一行全部打勾的:
| 系统 | 感知视频 | 输出视频 | 全双工 | 端到端 | 一秒内响应 |
|---|---|---|---|---|---|
| Wan Streamer | ✓ | ✓ | ✓ | ✓ | ✓ |
| 豆包语音 | ✓ | ✗ | ✓ | ✗ | ~ |
| GPT-4o Realtime | ✓ | ✗ | ~ | ✗ | ✓ |
| StreamAvatar | ~ | ✓ | ~ | ✗ | ✗ |
| LPM 1.0 | ~ | ✓ | ✓ | ✗ | ~ |
✓=是 ~=部分支持/未公开 ✗=否。全双工指系统生成时仍在持续感知,也就是边理解边回应。标「~」的格子,要么是部分支持,要么是该指标没有公开。
可流式性是建模约束,而不只是部署优化:建立在离线编码器、双向解码器或回合制对话之上的系统,仅靠工程优化也很难拿回真正低延迟的全双工能力。 Wan Streamer · 全双工挑战
实时对话 AI:从「一串模块接力」→「一个模型边听边看边说」
通义万相团队(阿里)把语音识别、思考、合成、动画整条流水线塞进单个模型,做到半秒回应、还自带一张会动的脸,一页带图讲完。
↓ 一页读完 · 有一张会动的图
能跟你实时语音聊天的 AI 现在不少,GPT-4o、豆包、Gemini 都行。但它们绝大多数只有声音,没有一张会看着你、会动的脸。通义万相团队新发布的 Wan Streamer 想补上这块:让 AI 一边看你的画面、一边听你说话、一边开口回应,脸和声音一起生成。先看现有的实时对话 AI 卡在哪。
✘ 但要么没有一张会动的脸,要么那张脸靠另一串模块硬拼,慢半拍、口型还对不齐
为什么:老办法把「听懂 → 想答案 → 出声 → 让脸动」拆成四五个各自独立的模型接力,每交接一棒都要等一下,识别和口型的误差也一路累加。
它的做法很直接:把上面那一整条接力流水线,全部并进同一个模型,从看你听你到开口回应一气呵成(这叫「端到端」,一个模型从头包到尾,中间不再交给别的模块)。
把语音转成文字、想答案、再合成声音、再驱动一张脸,四五个各自独立的模型排队交接。
看你、听你、想、开口、动脸,全在同一个模型里同时进行,中间没有交接。
但把几个模块并成一个,只是第一步。真正难的是让 AI 像人一样边听边说、你插一句它立刻能停下来,这得把处理方式从头改造。
靠的是一招叫 block-causal attention(块状因果注意力)的机制:把你的画面和声音切成一小块一小块(每块约 160 毫秒),模型一块块地边收边算,不用等你把整句话说完。
普通人对「快多少倍」没感觉,对「等多久」才有感觉。同样是你说完一句话、等 AI 开口这件事,各家系统差得很多,而且只有 Wan Streamer 回你时还带一张会动的脸。
没有一张脸
- × 语音转文字
- × 憋出答案
- × 合成声音
- × 驱动一张脸
v0.1 还糊在 192p,
演示是预录、不是实时,
「唯一」是官方口径
边听边看边说