GoogleがRetrieve-for-Trainフレームワークを提案:複雑なAI検索における「豊かな多様性」と「超高速レスポンス」の矛盾を解消
汎用LLMによるクエリファンアウト(Query Fan-out)は同義語の重複に陥りやすく、トークン単位の逐次推論による遅延にも悩まされる。R4Tは集合単位の探索ポリシーをオフライン訓練へと移行し、軽量な拡散リトリーバーに並列実行させる。
現実の複雑な検索でユーザーが必要とするのは、単独の結果ではなく、豊かで互いに補完し合い、一貫性があり、かつデータベース内で実際に見つかるコンテンツの集合であることが少なくありません。しかし、オンライン検索にはサブセカンド級の応答が求められます。リクエストのたびに汎用大規模言語モデルをその場で深く推論させると、トークンを1つずつ生成する遅延がリアルタイム検索と直接衝突します。
この矛盾を解消するため、Google ResearchはICML 2026論文でRetrieve-for-Train(R4T)を提案しました。検索リクエストごとに大規模言語モデルをその場で「深く考え」させるのではなく、強化学習を用いて優れたクエリ分解ポリシーをオフラインで探索し、その振る舞いを5390万パラメータの軽量な拡散リトリーバーへ蒸留します。拡散モデルは複数の検索方向を1回で並列生成し、集合としての品質を保ちながら大幅な高速化を実現します。
この研究が対象とするのは「最も関連性の高い1件を見つける」ことではなく、より難しい集合検索です。返される各結果がそれぞれ有用で、互いに補完し合い、全体としてユーザーの意図やデータベースの実際の内容から逸れない必要があります。このような要求は、商品の組み合わせ、プレイリスト、コンテンツ推薦、複雑なクエリに対する複数経路からの候補抽出などでよく見られます。

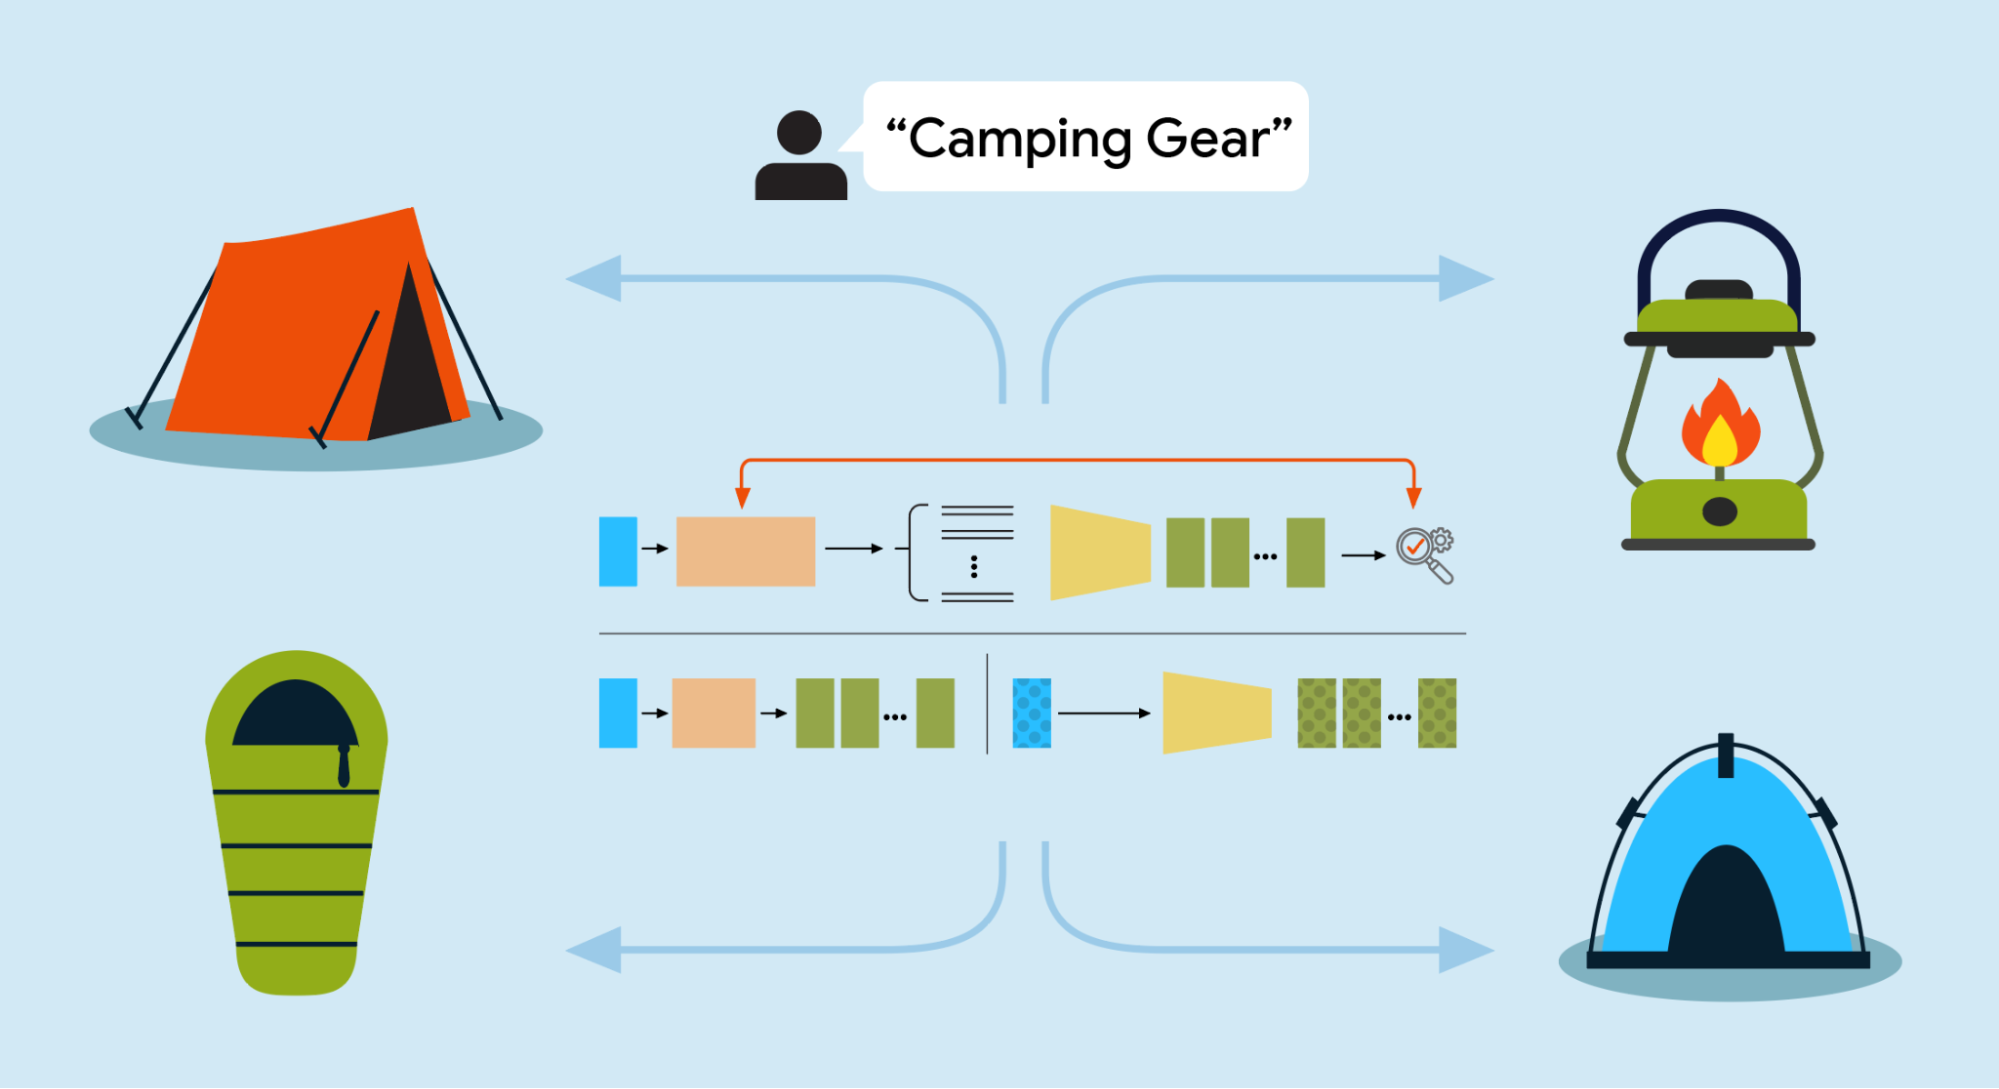
図:Google Research。複雑な検索のゴールは、同種の結果の重複ではなく、相互補完的な集合を得ることにある。
課題:従来のLLMによる複雑検索はどこで行き詰まるのか?
「キャンプ用品」と検索したとき、わずかに仕様が異なる10張の4人用テントが並ぶのは良い回答とは言えません。より合理的な結果は、テント、寝袋、ポータブルストーブ、ヘッドランプなどで構成される一式です。そのため、検索システムはまずクエリファンアウト(Query Fan-out)を行い、1つの漠然としたクエリを複数のサブクエリに分割した上で、各経路からの検索結果を組み合わせます。
ゼロショットの大規模言語モデルにこれらのサブクエリを直接生成させると、実用上は2つの本質的な弱点が表れます。
- 同義語言い換えの崩壊(paraphrase collapse):「ボヘミアン・フェス・スタイル」というクエリに対し、モデルは同義語の繰り返しに陥りやすく、「ボヘミアン・フェス・ファッション」「ボヘミアン風コーデ」といった同義表現ばかりを生成してしまいます。フリンジジャケット、クロシェ編みワンピース、スエードブーツのように、真に相互補完的で異なる具体的な方向性を提示することができません。
- 自己回帰によるレイテンシのボトルネック:モデルはトークン単位で逐次生成を行い、通常は数百もの中間CoT(思考の連鎖)トークンを消費します。推論時間はバッチサイズの増大に伴って増大し、オンライン検索が要求するサブセカンド級のレスポンスと衝突します。
さらに根本的な難しさは、結果の優劣が結果セット全体によって決まる点にあります。「多様性」「相互補完性」「十分な網羅性」はいずれもセット全体としての属性であり、複数の結果を並べて初めて評価できます。このようなオープンエンドな検索には唯一の正解が存在せず、単一アイテムのランキング目的関数では表現しにくい上、実世界において教師あり学習にそのまま使えるゴールドスタンダードの正解セットも不足しています。
R4Tの3ステップ:強化学習の重いコストをオフライン訓練の1回だけに抑える
R4Tは強化学習を「目標のトランスデューサー(変換器)」として位置付けています。まず報酬関数を用いて集合レベルの属性を満たす検索挙動を見つけ出し、その挙動を小規模モデルが学習可能なデータへとコンパイルします。
- ファンアウト言語モデル(FOLM: Fan-Out Language Model)の訓練:本研究ではGemma3-4BおよびQwen3-4Bを使用し、Soft-GRPOを通じて生成される10個のサブクエリを最適化します。報酬は個々の結果に対して別々にスコアを付けるのではなく、サブクエリ群全体を評価します。
- 教師データの合成:訓練済みのFOLMを凍結し、「元のクエリ → 目標集合」のサンプルペアをオフラインで生成します。結果セットには決まった順序がないため、拡散モデルの訓練時にはターゲットの順序をランダムにシャッフルし、順列の変化に対するモデルのロバスト性を高めます。このステップには人手によるアノテーションは不要ですが、前段階のリトリーバーや報酬設計に依存しており、「ゼロコスト」ではありません。
- 拡散リトリーバー(Diffusion Retriever)の訓練:5390万パラメータのモデルが、クエリ埋め込みからL個の検索方向を表すベクトルを一度に生成することを学習します。そして、商品や楽曲を直接生成するのではなく、最近傍探索を用いて固定されたデータベースのコンテンツへとマッピングします。中間テキストとしてのサブクエリを生成せず、結果を順番に1つずつ出力することもないため、ファンアウトを一度に並列実行できます。

図:Google Research。オンラインにデプロイされるのは最後の軽量な拡散リトリーバーであり、高コストな報酬探索はオフライン段階で完了しています。
この設計の真価は、単に小規模モデルで大規模モデルを置き換えたことだけに留まりません。より決定的なのは、訓練段階ではデータベースと繰り返し対話したり、集合報酬を計算したり、多様な分解を試行したりできる一方で、オンライン時には学習済みの分布を実行するだけで済み、ユーザーのリクエストごとにそうした探索を繰り返す必要がない点にあります。
3つの報酬が互いを牽制し合う必然性
R4Tは、オープンエンドな抽象的検索(OAR: Open-ended Abstract Retrieval)において、以下の3種類の報酬を同時に最適化します。
- 根拠性(Groundedness):サブクエリとデータベースの埋め込み多様体との距離にペナルティを与え、クエリがデータベース内の実際に検索可能なコンテンツに対応するようにします。
- 多様性(Diversity):サブクエリの集合全体に対してVendi Scoreを計算し、複数の検索パスが単一の意味論的パターンに偏るのを防ぎます。
- 整合性(Alignment):展開された方向性を元のクエリにアンカー付けし、多様性を求めるあまり意図から脱線するのを防ぎます。
アブレーション実験は、なぜこれら3つが不可欠であるかを明らかにしています。根拠性のみを最適化した場合、モデルは報酬関数の抜け穴を見つけ出し、「line ending line ending」のような意味を持たないものの、偶然データベースの座標近くに位置する文字列を生成してしまいます。そこに整合性を加えると、今度は元のクエリを繰り返し言い換えることで報酬を稼ごうとします。多様性が第3の対抗アンカーとして機能することで、ポリシーに対して「検索可能であり、意図から外れず、かつ互いに異なる領域」を見つけ出すよう強制できるのです。
インタラクティブ図解・論文のアブレーション結果
アンカーが1つ欠けると、ポリシーはどこへ向かうのか?
報酬の組み合わせを切り替えて、論文で報告されている訓練挙動を比較できます。これはアブレーション結果を概念的に示したものであり、実験曲線を再現したものではありません。
3つの対抗アンカーが協調して機能
「ボヘミアン風ロングドレス」「ストローブーツ」「レーストップス」など、方向性は異なりつつも、いずれも元のスタイルやデータベースと結びついている。
結果:検索可能で、意図から外れず、かつ意味的に分散した領域へと収束する。
これは、報酬の重みが大きければ大きいほど良いわけではないことも意味します。論文の重みに関する実験では、根拠性の割合が高すぎると意味的な整合性が損なわれ、整合性と多様性を強調しすぎると探索やカバレッジが抑圧されることが示されています。R4TはOARにおいてデフォルトで根拠性、多様性、整合性の重みを「0.6 : 0.2 : 0.2」に設定していますが、これはあくまで現在の実験設定であり、あらゆるデータベースに共通する万能の最適解ではありません。
実験は何を証明したのか
評価は2つのタスクに分かれています。OARには唯一の正解セットが存在しないため、集合の多様性、クエリの整合性、根拠性によって測定されます。一方、弱教師あり組み合わせ検索(WSCR: Weakly-Supervised Combinatorial Retrieval)では参考アイテムのセットが与えられ、Recall@5K、Hit@5K、およびVendi Scoreを用いてカバレッジと多様性を評価します。論文では2つのデータセットで検証を行っています。Polyvoreファッションデータは、OARで21,888件のコーディネートセット、WSCRで142,472件のアイテムを含み、CLIP系の画像・テキスト埋め込みを使用しています。音楽OARは8,522件のプレイリスト埋め込みを含み、MuLan音声・テキスト埋め込みを使用しています。なお、この音楽データは商用向けの専門家プレイリストであり、外部の研究者はアクセスできないため、外部からの再現性には制約がある点に留意する必要があります。
比較対象となる3つのベースラインは、fan-outを行わないデンス検索、Gemini-2.5-Flash、Gemma3-4B、またはQwen3-4Bを用いたゼロショット展開、そして独立して5回のfan-outを実行し報酬に基づいて最良の結果を選択するBest-of-Nです。実験結果は以下の3つの結論を支持しています。
- fan-out自体に価値はあるが、ゼロショットのfan-outでは不十分:元のクエリによる直接検索よりもカバレッジは概ね向上しますが、データベースの多様体から乖離したり、ほぼ重複した表現を生成したりしがちです。
- 報酬シグナルによってより優れた集合を選択できるが、オンラインでの反復サンプリングはスケーラビリティに欠ける:Best-of-Nは報酬シグナルの有効性を証明したものの、その代償としてリクエストごとに大規模モデルを何度も実行する必要があります。
- R4Tは品質と効率のパレートフロンティアを改善するが、2つのデプロイ形態にはそれぞれトレードオフがあり、「全方位で高精度」というわけではない:
R4T-FOLMはOARにおいて同等サイズのベースラインに比べ顕著な品質改善を示しますが、自己回帰言語モデル特有の推論遅延が依然として残ります。一方、パラメータ数がわずか5390万のR4T-Diffusionこそが低遅延デプロイの本命であり、高い多様性を維持しつつカバレッジを改善しますが、一部の整合性指標にはトレードオフが生じます。またWSCRにおいては、再現率(Recall)が高いバリエーションほどVendi Scoreが低くなる傾向も見られます。これは参考セット周辺のカバレッジを高めることで、発散的な探索が狭まる可能性があるためです。

図:Google Research。タスクごとに指標の定義が異なるため、すべてのグラフのバーを単一の「精度」として単純化して捉えるべきではない。
12〜20倍高速化の実態と適用範囲
効率性の実験では、1クエリあたり10個の検索方向を生成する条件に固定し、自己回帰LLMによるfan-outと拡散リトリーバーの実経過時間(Wall-clock time)を異なるバッチサイズ下で比較しています。バッチサイズが8のとき、自己回帰手法は約1.46秒を要するのに対し、拡散モデルは約0.07秒で完了します。バッチサイズを1024まで増やすと、前者は50秒弱に達するのに対し、後者は4.21秒にとどまります。全体として12〜20倍の高速化が達成されています。
したがって、「サブセカンド級」という表現は比較的小さなバッチサイズにのみ当てはまり、あらゆる設定に一般化できるわけではありません。また、これらの数値は論文特有のハードウェア、モデル、実験パイプラインにおける相対的な結果であり、任意の検索システムが自動的に享受できる汎用的なSLAではない点にも留意が必要です。
コストの移行であって、コストの消滅ではない
R4Tがもたらす最も有用なエンジニアリング上の示唆は、「複雑な目的の探索」と「低遅延な実行」を2つのフェーズに分離した点にあります。結果セットがどうあるべきかを業務上の報酬関数として表現できる場合、大規模モデルと強化学習を用いてオフラインで探索を行い、集合出力という形式により適した小規模モデルを使ってオンラインで実行できます。このアプローチは、結果セットの高次な属性が重要であり、リクエスト量が多く、データベースが比較的安定しており、かつ訓練コストを膨大なオンラインリクエストによって償却できるシナリオに適しています。
一方で、本手法には明確な4つの限界も存在します。
- 強化学習では、凍結されたリトリーバーとの反復的な対話と報酬計算が必要です。極めて大規模なデータベースや頻繁に更新されるデータベースに対しては、初期コストが増大し、再訓練が必要になる可能性があります。
- 業務上求められる検索属性を明示的な報酬として記述できることを前提としています。創造性、新規性、文化的配慮といった主観的な嗜好をスカラー値のスコアに落とし込むことは極めて困難です。
- OARの評価は一部LLM-as-a-Judgeに依存しています。アイテムの並び順のシャッフル、明示的な採点基準、評価理由の出力要求によってバイアスの低減を図っているものの、審査モデル自体のバイアスは依然として排除できず、本質的なユーザー価値を完全に代弁するものでもありません。
- 現時点での実証は、特定のFOLM、埋め込み空間、拡散アーキテクチャ、ならびにファッションや音楽のタスクに限られています。フレームワークが論理的に拡張可能であることと、他のモダリティ、検索バックボーン、ビジネスゴールにおいて検証済みであることとは同義ではありません。
したがって、この研究は1つのメソドロジー(方法論の道筋)として捉えるのが最も適切です。アノテーションが困難な集合レベルの目的を強化学習によって訓練データへとコンパイルし、コストの高いオンラインでの思考を拡散モデルによる高速な並列サンプリングへと置き換える。価値判断、報酬設計、データ変更に伴うコストそのものを消し去ったわけではありませんが、それらのコストを個々のユーザーリクエストから切り離すことに成功したのです。