Claude Code 团队公开了他们审查 AI 代码的具体工作流程
Claude Code 团队把审查拆进开发全程,让机器找错、人按风险把关,还给 AI 互审设定收敛规则。
Claude Code 团队称,Claude Code 自身约 90% 的代码由 Claude 编写。随着改动越来越多,工程师很难再逐行读完每一次提交。
从 6 月到 9 月,Claude Code 代码库合并的 PR 数量增长了一倍以上,而需要回滚的占比下降了超过 40%。(PR,即 Pull Request,是提交给代码库审查和合并的一组改动;回滚是撤销已经合入的改动)
当 AI 承担了如此大比例的代码编写,传统的人工逐行审查越来越难以跟上,成为开发流程中的瓶颈。代码审查也开始从最后一道人工关卡,转向贯穿开发全程的持续检查。Claude Code 团队公开了他们审查 AI 代码的具体工作流程。
这套流程的核心,是将大部分代码阅读工作交给机器,让工程师把时间与注意力集中在需要人类判断的关键风险上;同时,让失误能够被更快发现、更容易撤销。
代码改动激增时,重新审视代码审查的目标
代码审查通常承担两项任务:
- 合入前发现并修复问题。
- 在团队中建立代码理解与共识。
过去这两项诉求往往绑定在同一个环节:写好代码,提交 PR,等待同事逐行审查。
审查消耗的人工时间有两部分:上线前花多久检查,以及漏掉问题后花多久修复。如果仅仅削减前者,却导致后者大幅增加,整体时间并未节省。
团队希望,多数 PR 合并时最多只需一位人类参与,可以就是发起者本人。为判断人工负担有没有下降,他们追踪每个 PR 的人工批准次数、人工评论,以及等待人来处理的时间;批准次数同时看中位数和第 95 百分位(P95),了解常见情况之外,那些需要较多人工参与的请求。
这些指标与机器审查了几轮不同:自动检查即使很快完成,PR 也可能一直排队等人。如果审批变少,却让上线后的事故与修复工作增加,也只是把人工成本移到了后面。因此,回滚率和事故率是这项优化不能突破的底线。
这里的 Claude 提供模型能力,Agent 则是使用模型和工具执行具体任务的 AI 代理。在这套流程中,编写代码、运行验证和审查改动,可以分给不同的 Agent;下文把负责代码审查的一侧称为“审查 Agent”或“审查器”。
当 Agent 大量编写代码后,改动数量激增,传统的事后人工门禁容易成为瓶颈。“是否有人类读过代码”,往往并不能准确对应“这次改动可能出什么问题”。
因此,审查的核心思路转向了一个更实际的问题:“这次改动可能出什么错,哪道自动化检查或人工判断最适合发现它?”
这也改变了审查发生的时机。审查不再只是最后等待人工批准的一道门禁,而更像是边写边运行的拼写检查。大部分常规失误在进入人工视野前,就已经被自动化检查和修复过一遍。
假设团队要为命令行工具引入一个名为 --retry-timeout 的参数,用于控制网络中断时的重试耗时,并输出提示文案。这样一个改动不再只是排队等待同事逐行查阅,而是先经过多层针对性的自动化检验与分级处理。

分层防御:一次改动从本地验证走到上线之后
面对快速增加的改动量,单一的人工审查既容易出现盲区,也难以承受负荷。Anthropic 在实际流程中组合了多层检查:每一层检查都有其擅长捕获的问题,也各自存在漏检的可能;少数穿透所有检查的问题,则依赖合并后的快速回滚与开关来兜底。

1. 提交前验证:在他人审阅前先让代码自证
绝大多数常规错误应在创建 PR 之前解决。要求 Agent 实际运行并展示结果,比单纯询问它是否完成更可靠:
- 运行并展示结果:为模型提供可以实际运行的环境与命令(如运行测试套件、执行构建、输出命令行结果,或在浏览器与模拟器中比对界面截图),要求其提供真实的运行输出作为证据。
- 全新上下文复审:单独启动另一个负责复审的子 Agent,让它不沿用编写代码时的那段对话,而是重新读取项目资料、检查本次代码差异(Diff)。这样可以减少编写阶段的既有思路对审查的影响。
- 工程规范内化:简短的
CLAUDE.md说明项目技术栈、约定、目标与明确不做的事,再指向更详细的文档。审查器既检查代码是否违反这些约定,也检查新改动是否让文件中的说明过时。
不少工程师在提交前还运行几种内部技能,分别寻找缺陷、简化代码差异和检查端到端行为;界面改动还要对照设计规范。测试通过与整个使用过程正确,是两种需要分别检查的证据。
各模块负责人编写的 REVIEW.md 则告诉审查器:在这里,什么问题值得报告。除了具体的失败定义,它还限制琐碎意见,列出可以跳过的路径,要求指出文件与行号作为证据,而不是凭函数名猜测问题;结果摘要先说发现了几个问题,没有值得修的就明确说没有。团队还会另行检查审查器是否真的遵守了这些要求。
例如,为本文的重试参数假设自拟一条教学规则:“检查重试是否遵守设定的总耗时;若超出,请给出相关文件、行号与触发条件。不要只因变量命名偏好提出修改;未发现问题时直接说明。”它给出了要找的错误和证据要求,比一句“仔细审查代码”更容易执行。反复出现的问题还会被写回指导文件、技能或静态检查规则,让下次开发更早避开它。
在 --retry-timeout 的例子中,Agent 在本地必须真正运行覆盖超时场景的测试,并将包含实际耗时与日志的输出贴出来。如果拼错了参数名或类型不匹配,在本地就会暴露,无需等到同事介入。
2. 持续集成检查(CI)
代码推送到远端后,统一运行跨平台的代码风格检查、类型检查、单元测试与打包构建。CI 出现失败(红灯)会直接阻止代码合并。
3. 每个 PR 都先接受 AI 审查
每个 PR 在人工查看前都会先经过自动化审查。这套审查的公开产品版本名为 Code Review for Claude Code。具体做法是:
- 结合全库上下文与意图:模型结合整库代码与 PR 说明中陈述的意图,评估改动是否解决了目标问题、是否契合现有系统、是否会破坏其他模块。该功能推出研究预览(research preview)后,内部获得实质性审查意见的 PR 比例从 16% 上升到 54%。这说明更多 PR 得到了有内容的反馈,并不表示已知漏洞中有 54% 被检出。
- 寻找缺陷与验证分离:多个 Agent 在后台并行寻找潜在缺陷,随后由另一组 Agent 对每条发现进行投票,仅在有足够共识时才发布评论,从而过滤纯粹的代码风格或琐碎挑刺。
- 分级与回应要求:保留下来的意见按重要、琐碎或既有代码问题标记。PR 作者必须做出修复,或给出理由关闭讨论,无法直接忽略。
4. 独立的自动化安全审查
安全审查作为独立检查运行。若安全审查或代码审查中存在未解决的问题,合并就会被阻止。在重试参数的例子中,如果日志输出中不慎包含未经脱敏的认证凭据,安全审查若检测出该问题就会阻止合并。作者修复问题或说明误报理由后,限制才会解除。
5. 按风险分级的人工审批
不同改动带来的潜在破坏不同。文档修正、常规功能开发与修改自动更新逻辑所承担的风险各异,系统会根据变更本身的风险等级决定需要多少人审批。
6. 合并队列与员工先行使用
合并队列会在最新主干上重新运行全部检查,避免两个各自通过的 PR 合并后破坏主干。特性开关把“代码已经合入”和“功能对用户开放”分开:代码可以先进入主干,再逐步打开功能。新功能通常放在开关之后,先由 Anthropic 内部员工在日常工作中实际使用,往往能在外部用户之前发现回归问题。公开发布时,新版本先推向 latest 正式发布通道,稳定通道(stable)随后跟进。
7. 快速发现与快速撤销:降低失误成本
即便存在多层检查,依然可能有问题流入生产环境,因此关键在于快速响应:
- 特性开关可以直接在线关闭,无需等待重新构建与发版;团队表示,开关、回滚与分阶段发布能让大多数失误在几分钟内撤销。
- 团队设有每周值班轮岗(on-call),作者和值班人员结合运行遥测、内部使用反馈与看板发现回归问题,追踪回滚与事故情况。事故复盘着眼于系统漏洞——排查哪一层检查本应接住该问题却未接住,而不针对个人追责。
把这条路径放回 --retry-timeout 的假设:Agent 先在本地运行超时测试,再提交 PR 接受跨平台 CI、代码与安全审查;处理完意见并满足相应人工审批要求后,改动进入合并队列,在最新主干上重新检查。合入后先通过开关让内部人员使用,再逐步向用户开放。假如真实网络环境与其他功能组合出了测试未覆盖的问题,就根据监测结果关闭功能、修复或回滚。前面的检查尽量减少错误,后面的措施则缩小漏检造成的影响。
按风险分配人工审批与责任机制
在审查流程中,减少审批人数的前提是更严格的自动化约束与明确的责任归属,而非放任无人把关。
由改动本身决定风险等级
在 Claude Code 的代码库中,审批人数由改动性质决定:
- 低风险:文档、文案、仅供内部使用的特性、受开关保护的增量改动,在满足可信作者等简化条件且自动化检查通过后,可以免人工审批。
- 中风险:普通产品功能,以及涉及缓存、自动更新器或系统提示词等敏感区域的改动,需要一人审批;在由 Agent 编写的 PR 中,指导 Agent 的作者本人即可作为该审批人。
- 高风险:最高风险的代码,加上一小部分固定路径,需要两人审批。
分级由分类器分析代码后确定,并由第二道分类器复核该改动是否仍有必要引入额外的人工审阅。同时,任何 CI 工作流文件以及代码所有者明确标记为敏感的路径,都至少需要一人审批。
先看改动风险,再看有没有额外条件
以下是假设场景,预设分类结果用于解释规则,不是实际风险判定器。
这里假设 CI 已通过,代码与安全审查的意见都已修复,或说明理由后关闭。
低风险、可信作者、没有额外人审要求,才可以走这条路径。
把改动放到最新主干上重新检查,才能发现单独通过、组合却冲突的问题。
不变的规则:Agent 的批准不能占人工席位;指挥 Agent 的人仍对改动负责。一次批准绑定具体提交,后续改动若无法由系统担保,就要重新批准。
审批边界与白名单机制
- 受信作者名单:较宽松的审批路径仅向仓库的受信作者名单开放(多为维护该仓库的团队成员);其他作者提交的代码则需要发起者之外的另一人批准。
- Agent 无法替代人工批准:自动化审查可以在低风险场景免除人工审批,但只要某个级别要求人类参与,Agent 的通过就不能计入人类名额。
- 新提交需重新核验:人工批准针对特定的提交生效。若后续合入了系统无法担保的新提交(例如 Agent 新推的补丁或人工手动解决的合并冲突),原批准需要重新给出。
谁发起改动,谁负责到底
在责任归属上,指导 Agent 编写代码的工程师与自己亲手写代码一样,对合入的改动负责。如果小幅或中等改动上线后出现异常,通常由发起者负责修复,因为发起者对这段改动拥有最完整的上下文。
这一责任约定能运转,还依赖改动本身足够小:出问题时更容易定位到具体变化,修复和撤回也更简单。团队配合特性开关、分阶段发布与快速回滚,让多数错误可以及时撤销;再通过运行遥测和内部高频使用尽早暴露异常。影响范围越大、出错代价越高的改动,则配置更多人工和检查。
因此,“谁合入谁负责”背后是一套降低修复难度的工程安排,并不意味着个人独自承担所有后果。团队复盘关注的是系统与机制漏洞,而非针对个人的责难。同时,代码所有权也是团队共同承担的,工程师在开放频道中协作,任何人都能看到他人正在构建的内容并提供反馈。
在这种分工下,工程师的时间从逐行通读常规差异,转移到机器不擅长的五个关键决策上:
- 是否应该做这项需求:方向、业务判断与需求范围。
- 高风险代码的把关:涉及计费、自动更新与 CI 工作流等关键区域。
- 架构与设计模式:新引入的模式是否会被后续改动大范围模仿。
- 审读客观证据:检查测试输出、命令执行结果、界面截图及审查器报告,判断自动化检查可能遗漏了什么;如果无法判断自动化会漏掉什么,就应发起真正的人工审查而非快速通过。
- 对交付结果负责:无论代码由谁键入,最终上线的每一笔改动背后都由具体的人承担责任。

当 Agent 审查 Agent:为什么交互难以收敛,怎样建立约束
当代码由 Agent 编写、第一道审查也交给 Agent 时,工程团队遇到了审查与修复无法收敛的问题。
琐碎意见在这里会产生更大的成本。人看到无关紧要的建议,可能几秒钟就决定不改;编写代码的 Agent 却可能照着修改,产生一个新提交,再触发一轮审查。于是,一条没什么价值的意见也会变成“建议—修改—提交—复审”的整轮工作。
在早期实践中,一个由 Agent 编写的 CLI 变更在夜间经历了五十多轮审查与修改,直到作者主动叫停。代码编写 Agent 对审查意见逐项修改并提交新代码,审查 Agent 又在新的上下文中提出新的建议,导致轮数不断增加。
轮数膨胀的原因:59% 是初审时已存在的代码
团队使用 git blame 追溯审查器反复指出的内容后发现:约 59% 被指出的代码自审查器第一轮审查时就已存在。
这说明审查器在后续轮次中很少是在发现新提交引入的新缺陷,而是在原本已存在的代码中每轮多翻出几个问题。由于第一轮审查未能一次性报完已有的问题,每一轮修补又触发新的审查,导致反复交互难以收敛。此外,团队早期习惯了多轮审查的模式,虽在某些高危场景有价值,但在所有 PR 上推行则带来了不必要的开销。
促使审查收敛的四项调整
为确保审查能有效收敛,团队除了跟踪真实缺陷中能找出多少(召回率),也开始监控“通过所需的审查轮数”:既要找出问题,也要避免无休止地往返。为此,他们推行了具体改动:
- 设置轮数上限:经历三轮审查后,审查器会要求作者退后一步重新审视实现方案,而不是继续在局部微调中打转。
- 前几轮后仅复审增量差异:在经过前几轮审查后,后续复审只针对最新提交的新增差异(Diff-only),避免不断在旧代码中翻找。
- 指出同类缺陷模式:审查器按缺陷类型归类指出问题,促使作者一次性处理所有同类问题,而非单行单点修补。
- 不重复提出已有批注:已经发出的意见不再换用不同措辞重复提出。
仍用重试参数作假设:如果多条重试路径都没有正确限制总耗时,只指出其中一行,作者可能只修那一处,下轮又被指出另一处。“指出同类缺陷”则要求把这个共同问题讲明白,让作者一次检查并修正所有相关路径。经过最初几轮检查后,复审只看新补丁引入的差异,重点确认这次修复有没有带来新问题,而不是每轮重新遍历整批旧代码、继续零散挑错。
旧问题并没有因此无人检查。审查 Agent 还会在夜间对存量代码执行扫描,让历史问题有专门的排查途径。三轮后要求重新审视方案,也不等于三轮一到就自动通过。
平均轮数下降,还要看少数拖得很久的请求
收敛措施实施后,Anthropic 内部 PR 的审查轮数指标出现了相应变化:
审查收敛调整前后
Anthropic 内部 PR 的前后对照。每组条形共用比例尺,不同组的量纲不同。
一轮审查与修复后通过
更多请求在一轮内结束;不表示代码无需修复。
需要五轮及以上
反复往返的请求明显减少,仍未归零。本组以 10% 为满刻度。
平均通过所需审查轮数
整体往返更少。本组以 2.5 轮为满刻度;轮数不等于耗时。
第一组满刻度为 100%。原图未给出样本量及具体统计时间窗;这些数字描述审查轮数,不是漏洞检出率。
查看原文图 D:审查轮数数据

一轮审查与修复后通过的比例从 65% 增至 78%,说明更多请求能在一次往返后结束,并不是说它们完全不需要修复。
这些指标来自内部 PR 数据,未标注样本量与具体时间窗口。在平均轮数从 2.08 轮降至 1.32 轮的同时,更直接的变化体现在需要 5 轮及以上的长尾比例从 8.9% 压低到 1.5%,说明那些需要反复往返的请求变少了;节省了多少实际时间,还需另行测量。
审查器自己也要考试:用真实事故校准
收集过去引发故障或导致回滚的 PR,由熟悉业务的工程师确认缺陷与所在位置。把历史 PR 当作题目,对应的修复或回滚记录帮助确定答案,就有了一套贴近真实风险的评测集。评测时,让审查器重新检查这些 PR 中有缺陷的改动,再将它报告的问题与工程师已确认的缺陷对照,看真正的问题有没有被找出来。

这套案例集会随着新事故不断扩充,而不是整理一次就固定下来。发现漏检时,团队也会追问:模型当时缺少了什么信息?相应修正可能进入 CLAUDE.md、某个技能,或一项新的检查。
团队每日运行审查器执行评测。每当修改它的提示词、工具或模型,都要在完整案例集上检查,评测改善才保留修改。这样就接成了一个持续过程:真实事故由工程师确认,加入案例;针对漏检补信息或改检查,再回测所有案例,判断新版本是否值得保留。既要学会抓住刚发生的问题,也要检查以前能发现的问题有没有再次漏掉。
但多报问题也可能提高检出率,所以还得看误报。团队会追踪每条意见后来是被修复、被认定错误、属于有意行为,还是被认为不重要;还会让审查器检查已知干净的 PR,统计它会不会提出反而有害的修改建议。
他们明确把抓住真实缺陷放在第一位,减少审查轮数放在第二位。否则,一个很快通过所有代码的审查器,也可以交出漂亮的轮数成绩。
代码阅读减少后,团队如何理解系统全貌
代码审查的第二项传统功能是在团队中传播代码理解。如果大部分代码阅读交给机器,团队如何保持对系统的认知?
Claude Code 团队表示,团队目前并没有针对这一环节设立正式流程。团队中没有人保留整套代码的完整心智模型,也认为不需要做到这一点。
当工程师需要了解或修改某个不熟悉的模块时,通常会直接要求 Claude 针对该模块生成针对当前代码切片的讲解说明,或者借助模型生成可视化图表来辅助理解。

这种按需讲解并不能替代一切必要的代码阅读,但在面对琐碎改动时,能减少通读无关差异的精力消耗。同时,团队默认在开放的 Slack 频道中工作,工程师可以实时看到其他人在构建什么,通过公开频道的讨论与协作保持对系统变化的了解。
普通团队如何落地这套流程
工程团队若想借鉴这套审查机制,需要先厘清公开工具与内部机制的区别。
面向 Team 与 Enterprise 用户的托管 Code Review 功能、本地运行的 /code-review 命令行命令,以及开源的 GitHub Action,是面向不同使用场景的独立工具形态,并非单一绑定的固定套餐。其中,托管 Code Review 只负责分析代码并发布批注:它不会批准或阻止合并,也不替团队运行构建测试或推送修复。
Anthropic 内部能够让部分低风险改动在没有人工审批的情况下合并,依靠的是团队自身搭建的 CI 检查、安全过滤、合并队列与快速回滚制度。
对于普通团队,更稳妥的推进路径是从基础约束逐步过渡,而非直接照搬零人审批:
- 先让 Agent 能自查:在简短的
CLAUDE.md中列出验证命令,用 hooks 自动运行格式化和代码检查;提交前运行/code-review、/security-review,或让全新上下文的子 Agent 复审。维护由模块负责人编写的REVIEW.md,明确本模块真正值得报告的问题。 - 先在一个仓库试点:将 CI 测试设为合并的必要条件;PR 模板增加“如何测试”(Testing)、“风险”(Risk)与“如何回滚”(How to revert),由发起者确认。接入 AI 审查后,先根据真实反馈调整
REVIEW.md几周,再推广到更多仓库。 - 把审查意见接到合并约束上:代码与安全审查负责找问题,仓库规则负责执行“检查通过、讨论已处理才能合并”。日常改动用快速检查,漏检代价高的改动用深度检查;托管 Code Review 可按仓库选择 Quick、Standard 或 Deep。报告了问题与真正阻止合并,是需要分别配置的两件事。
- 写清人工审批规则,同时限制无效往返:按改动风险分级,简化路径只给受信作者。用
CODEOWNERS指定敏感路径的负责人,再通过分支保护落实必须获得相应人工批准的要求;认证、计费、CI、发布流程和安装器等路径要有人把关。机器人不能替代所需人工批准,新提交需要重新核验审批。同时约束复审轮数,在最初几轮后只审新增差异。 - 把上线与恢复路径一起准备好:使用合并队列、特性开关、内部先用和分阶段发布,并准备一步回滚的手段。收集出过问题的 PR、修复与回滚记录,持续加入评测集;审查器的提示词、工具或模型一有修改,就重新检验真实缺陷与误报。
- 依数据决定是否逐步放宽审批:明确划分改动的风险层级,关键路径与 CI 工作流坚持人工把关;在实践中持续追踪人工审批耗时,并以回滚率和事故率为安全底线。当自动化检查、特性开关和撤回手段逐步成熟且回滚保持低位时,团队可根据自身情况逐步放宽部分低风险改动的审批门槛,而不必在初期就绝对排除这一方向。
尚未建立的自动化熔断器与交付把控
Anthropic 内部仍未建立指标恶化时的自动熔断器,无法在事故率或回滚率抬头时自动收紧审批要求,依然依赖值班工程师在看板前进行人工监测。团队工程师也希望在更广泛地放开零人审批之前,先将自动熔断器建立起来。
此外,Agent 极大地降低了编写代码的门槛,但并不意味着所有写出来的代码都应该合入主干。关于一项需求“该不该做”,更适合尽早在公开的讨论频道中沟通,而不是等到代码写完、PR 提交后再行阻拦。因为生成代码的成本已经很低,在方向出现偏差时,及时关闭 PR 更容易接受,不必仅仅因为代码已经写成而勉强合并。
Claude Code 团队公开了他们审查 AI 代码的具体工作流程
Claude Code 团队称,自身约 90% 的代码由 Claude 编写。只靠同事在合并前逐行通读,越来越难以跟上改动量。PR(Pull Request)是一组等待审查与合并的代码改动。
合并 PR 数量
回滚即撤销已合入的改动
一次改动:先拿证据,再按风险放行
Agent 是使用模型和工具完成任务的 AI 代理。编写、验证与审查可由不同 Agent 承担。各层都可能漏检,因此检查之外还要准备恢复路径。
实际运行,再独立复审
编写 Agent 运行测试、构建或界面检查,出示日志与截图;全新上下文的子 Agent 重新看差异。CLAUDE.md 交代项目约定,REVIEW.md 说明模块的失败模式与报告证据。
CI(持续集成)、代码审查、安全审查分工
CI 运行跨平台检查;AI 结合全库与改动意图找缺陷,由另一组 Agent 验证、投票后报告。安全审查独立运行。CI 红灯,或代码、安全意见未处理,都阻止合并;作者可修复或说明误报理由。
风险越高,所需人工越多
分类器定级,第二道分类器复核是否还需人审。所有 CI 工作流与标记为敏感的路径至少一人;非受信作者另需他人批准。Agent 不能占人工名额,新提交可能使旧批准失效。
合入代码,逐步开放功能
合并队列在最新主干重验;特性开关分开“已合入”与“对用户开放”,先让员工实际使用,再分阶段发布。
漏检后:发现 → 关开关或回滚 → 复盘
作者与值班人员结合遥测、反馈和看板发现异常。小改动更容易定位,开关可在线关闭,无需重新发版;团队称,多数失误能在几分钟内撤销。影响越大、撤销越难,就越需要前置检查与人工。
AI 互审也要收敛:避免每轮多翻几处旧问题
人会忽略的琐碎意见,编写 Agent 也可能照做,从而触发整轮工作。一次 CLI 改动曾往返 50 多轮,直到作者叫停。追溯发现,约 59% 被指出的代码在第一轮审查时已存在,后续审查不断分批翻出问题;这不等于 59% 来自 PR 创建前的代码。
三轮后,退后看方案
提醒作者重新审视实现;不是到点自动通过,也不是强制停止审查。
前几轮后,只看新差异
把复审聚焦新补丁;存量代码另在夜间扫描。
一次指出整类缺陷
让作者查全所有相关路径,避免每轮只补一个点。
已有意见不换词重复
减少没有新增信息的往返。
少往返的前提:审查器仍抓得住真实缺陷
否则,对所有代码都说“通过”,也能让轮数漂亮。团队先看真实缺陷能否检出,再看轮数。
人的角色:做判断,对结果负责
指导 Agent 的工程师对改动负责;能否履责,依靠小改动、可观测与快速撤销,团队复盘聚焦系统漏洞。代码理解按需补充:让 Claude 讲解当前模块,再通过开放频道协作。
普通团队先建底座,再放宽审批
先在一个仓库建立真实验证、CI 与合并规则,明确人工审批,再备齐开关、回滚与事故评测。公开 Code Review 只分析并批注;阻止合并、运行测试及推送修复需要另行配置。
Anthropic 自己尚无指标恶化时自动收紧审批的熔断器,仍由值班人员看板监测。零人审批依赖这些工程前提,不能只靠接入一个审查工具。
How the Claude Code team does code review
How do you review code at the volume agents produce it? On the Claude Code team, once we had high coverage and deep reviews, we started optimizing for the minimum amount of human review time that doesn't raise reverts or incidents.
We've said before that Claude writes about 90 percent of Claude Code's own code. So how do we review code at the volume we produce it? Does anyone read code anymore? And if something breaks, who catches it?
This post covers the code review flow on the Claude Code team and how it has evolved. From June to September, merged pull requests to Claude Code's codebase more than doubled while the share that had to be reverted fell by more than 40 percent.
We didn't remove review. But we did move most of the reading to machines, optimized for human time and attention, and invested heavily in making it fast and easy to undo mistakes.
RETHINKING THE PURPOSE OF CODE REVIEW
When agents write code, the number of changes goes up, fast. In Anthropic's monorepo, changes landing per day went from about 2,500 in May to more than 30,000 in September this year.
Claude Code lives in its own repository, separate from the monorepo, but it's seeing a lot of pressure too. When you are shipping this fast, manual, line-by-line code review is incredibly difficult if not impossible.
Code review does two jobs:
- Find and fix issues before they ship
- Build shared context and codebase understanding across the team
This article mainly focuses on finding and fixing issues, but we will come back to the second job near the end.
We think "did a human read the code?" is an imprecise proxy for "what could go wrong with this change, and which check—automated or human—is the right one to catch it?"
Asking that question also changed when review happens. Before, review was a gate at the end of the road: write the code, open a PR, wait for your colleague.
Now, review runs continuously, more like spellcheck while you write. Most changes have been reviewed and fixed by Claude at least once before a human is asked to look. This catches most routine mistakes, and saves team attention for higher-level questions and scrutiny.
THE SCARCE RESOURCE: HUMAN TIME AND ATTENTION
We want to preserve human time and attention for issues only humans can solve and make sure automated checks catch the rest. At our current rate of change, there is still an incredible amount of work for humans to do, and our team encounters new and novel challenges almost daily.
Human time covers both sides of review's cost: the time people spend reviewing, and the time they spend fixing what bad code breaks. Cutting the first doesn't help if the time just shows up in the second.
So the goal is that most pull requests in the Claude Code repos (the CLI, the desktop and web apps, and the mobile apps) merge with at most one human in the loop, who can be the author, with no increase in reverts or incidents. To measure human time, we track human approvals per PR (median and 95th percentile), human comments, and how long a PR waits on a person. Revert and incident rates are the guardrail: if they rise, we haven't saved human time, we've only moved it.
THE LIFE OF A CHANGE
A typical change, from an engineer's laptop (or a Claude session in Slack), goes through multiple layers of code review.
FIG AMost of the path is automated; a person's attention goes where the risk is
LAYER BY LAYER
FIG BEach layer catches some problems and misses others. Few get through all of them, and rollback handles the rest.
1. The work is verified before anyone else looks
Most review now happens before a PR exists. We give Claude something it can run—like tests, a build or a screenshot to compare against the design—and ask it to show the output instead of saying it's done. Then a subagent reviews the diff with fresh context. Both habits come from our best-practices guide.
Before opening a PR, many of us also run a few internal skills: one hunts for bugs, one simplifies the diff, and one checks the behavior end to end. UI changes also get checked against our design guidelines.
Boris Cherny, who created Claude Code, has called giving Claude a way to verify its work probably the most important thing for getting good results. He estimates it makes the final result two to three times better, and writes, "Verification looks different for each domain. It might be as simple as running a bash command, or running a test suite, or testing the app in a browser or phone simulator."
When the automated reviewer keeps flagging the same thing, we fix it at the source: in the skill, with a lint rule, or with updates to instructional files such as:
CLAUDE.mdtells Claude what the project is: the stack, the conventions, the goals and the non-goals. Every review loads it, so in a large codebase we keep it short and point to other docs from there. The reviewer also flags code that breaks a convention in it, and changes that make a line in it out of date.REVIEW.md, written by code owners, tells the reviewer what matters in their part of the code. We check separately whether the reviewer actually follows it. The good ones are short. They say what failure looks like in that repo (for docs it's "it lies," for config it's "it misroutes"), cap the nits, list paths to skip, and ask for a file and line as evidence instead of a guess from a name. They also ask for a summary that starts with a count and says plainly when there's nothing to fix.
2. AI review on every pull request
Every pull request gets a Claude review before a person looks. It reads the diff against the whole repo and the PR's stated intent, and asks: does the change solve its problem, fit the system, or break something else?
On a bug fix, it looks for the root cause. The public version, Code Review for Claude Code, is now generally available on Team and Enterprise plans, and /code-review runs a lighter version locally.
When we launched the research preview, the share of internal PRs getting substantive review comments went from 16% to 54%. Most PRs over 1,000 lines get findings, and most small ones come back clean. Admins set each repo to Quick, Standard, or Deep. Deep is worth it where one missed bug costs more than the extra review time.
Findings get verified by other agents before humans review them. Several agents look for bugs at the same time. Then a separate group votes on each finding, and it only gets posted if enough of them agree it's real. Findings that are only about style, diagnostics, or cleanup get dropped. We A/B tested those filters on our own PRs before keeping them. What's left shows up as inline comments sorted by severity. Each is tagged Important, Nit, or Pre-existing, so a bug the PR didn't introduce doesn't look like the author's fault.
Every finding has to be answered. You either fix it or resolve the thread with a reason. Often an agent picks up the fix overnight, so the author comes back to a PR that's already been through another round.
3. Security review that can block
Security gets its own automated review too. A PR can't merge while any finding from the bug review or the security review is still open. You either fix it or close the thread with a short reason, which is how you clear a false positive.
If a later commit fixes the issue, the finding clears on its own. You can set up the same thing with the open-source security review GitHub Action or the /security-review command. Setup is covered in automated security reviews in Claude Code.
4. Automated checks that block
The usual: lint, type checks, tests on every platform, and a build. (We wrote about scaling CI for this volume here.) A typical CLI pull request may run dozens of checks before anyone looks at it. The PR template asks how the change was tested and how to undo it. Claude can fill that in, but the person who asked for the change signs off on it.
5. Human approval, scaled by risk
A docs fix and an auto-updater change carry different risk, so they get different review.
| Risk | Examples | Human approvals |
|---|---|---|
| Low | Docs, copy, internal-only features, additive changes behind a flag | None required once automated review and security checks are green |
| Medium | Ordinary product changes, and changes to sensitive areas such as caching, the auto-updater, or system prompts | One person |
| High | The highest-risk code, plus a small set of paths that always need two people | Two people |
The change sets the tier, not the author. A classifier reads the change and picks its risk tier. A second classifier asks whether this particular change needs another person even when its tier says it doesn't. Some paths always need a person, anything owners have listed as sensitive and any CI workflow file.
Only trusted authors get the lighter paths. Only authors on the repo's trusted list get the lighter paths, mostly the team that owns it. Everyone else needs a second person to approve. An agent's approval never counts as a person's, either. Automated review can clear a low-risk change, but it can't fill a slot that calls for a human.
Whoever prompted the change is on the hook for it. On an agent-written PR, the person directing the agent counts as one of the required reviewers, the same as if they'd typed the code themselves.
An approval covers one specific commit. If new commits land that the system can't vouch for, like an agent's push or a merge someone resolved by hand, the approval has to be given again.
6. Merge queue, flags and a gradual release
The merge queue re-runs every check against main with the change applied, so two PRs that pass separately can't combine into a broken main. New behavior usually ships behind a flag to Anthropic employees first, and our heavy use often surfaces regressions before users do. Public releases go to the latest channel first. The stable channel trails it.
7. Fast detection, fast rollback
Some mistakes will still get through, so the last layer is about catching them fast. Flags turn off without a deploy. Claude Code has a weekly on-call rotation, and incident reviews ask which layer should have caught the issue.
Noticing a bad merge still depends on the author and on-call as well as the revert and incident dashboards. We don't yet have circuit breakers that tighten approval when those numbers move; engineers here want them before more code moves to zero-human merges.
One colleague said slowing down does lower your error rate, but mostly because you're doing less of everything. We'd rather get faster at noticing and fixing problems.
HOW WE MAKE THE REVIEWER BETTER
Our code review process is constantly improving in a loop.
Any incidents are now an eval. The team collected past PRs that caused incidents, with their fix-forwards and reverts, and had engineers who know that code confirm each bug and where it lived. The reviewer runs against that set daily.
FIG CThe eval grows with every incident, and every change to the reviewer is scored against all of it.
We measure noise by watching what people do with the comments. It's easy to catch more bugs if you don't mind flagging a lot of non-bugs, so we need a check on that. We sort every comment the reviewer leaves by how the person on the PR responded: they fixed it, said it was wrong, said the behavior was intentional, or decided it didn't matter. We also run the reviewer on PRs we know are clean and count how often it reports something that would have led someone to make a harmful change. Our priority, written down, is catching real bugs first and cutting review rounds second.
Noise costs more when the author is an agent. A person can wave off a nit in seconds. An agent fixes it, which means another commit and another round of review.
Review has to converge. An agent author and an agent reviewer can keep each other busy indefinitely. One CLI PR went through more than fifty rounds of review and fixes overnight before its author stopped it.
When we ran git blame on what the reviewer kept flagging, about 59% of it was code that had been there since the reviewer's first pass. The reviewer was rarely finding new bugs, it was finding a few more old ones each round.
We made it worse ourselves. We'd gotten used to running several rounds by default, since each pass catches something new. This can be worthwhile on a risky change, but not on every PR. The team now tracks rounds-to-pass alongside recall, and changed re-review:
- A round cap. After three rounds, the reviewer asks the author to step back and reconsider the approach.
- Diff-only re-review after the first few passes.
- Flag the class of bug, so the author fixes every instance, not one line.
- No repeats of findings already posted.
Review agents also run nightly over existing code, helping us catch old bugs before they show up somewhere else.
FIG DFewer review rounds per internal pull request after the convergence changes
WHERE HUMANS STAY IN THE LOOP
Pulling a senior engineer out of deep work to catch a routine mistake costs far more than an automated review. At Anthropic, our jobs have moved from reading every diff to the decisions machines are bad at:
- Should we build this at all? Direction, taste and scope. One team that declared its review bottleneck solved still kept human review for changes from outside the team, so someone asks "should we even do this?"
- Risky code such as billing, the auto-updater and CI workflows.
- Architecture that sets a pattern others will copy.
- Reading the evidence. Test output, the command that ran and what it returned, a screenshot, the reviewer's findings. If you can't say what the checks would miss, ask for a real review rather than a quick approval.
- Owning the outcome. A person is accountable for every change that ships, whoever typed it.
FIG EPeople moved from reading every diff to the decisions machines are bad at
SHARING CONTEXT ACROSS THE TEAM
Code review's second job has always been to spread codebase understanding. Reading a teammate's diff is how you learn what changed and how the pieces fit. If machines do most of the reading, how does anyone learn the code?
We don't have a formal process for this. Nobody on the team keeps a complete mental model of Claude Code in their head, and we don't think anyone needs to. When someone wants to understand a part of the codebase, they ask Claude to write an explainer for exactly that slice. It takes minutes and reflects the code as it is today.
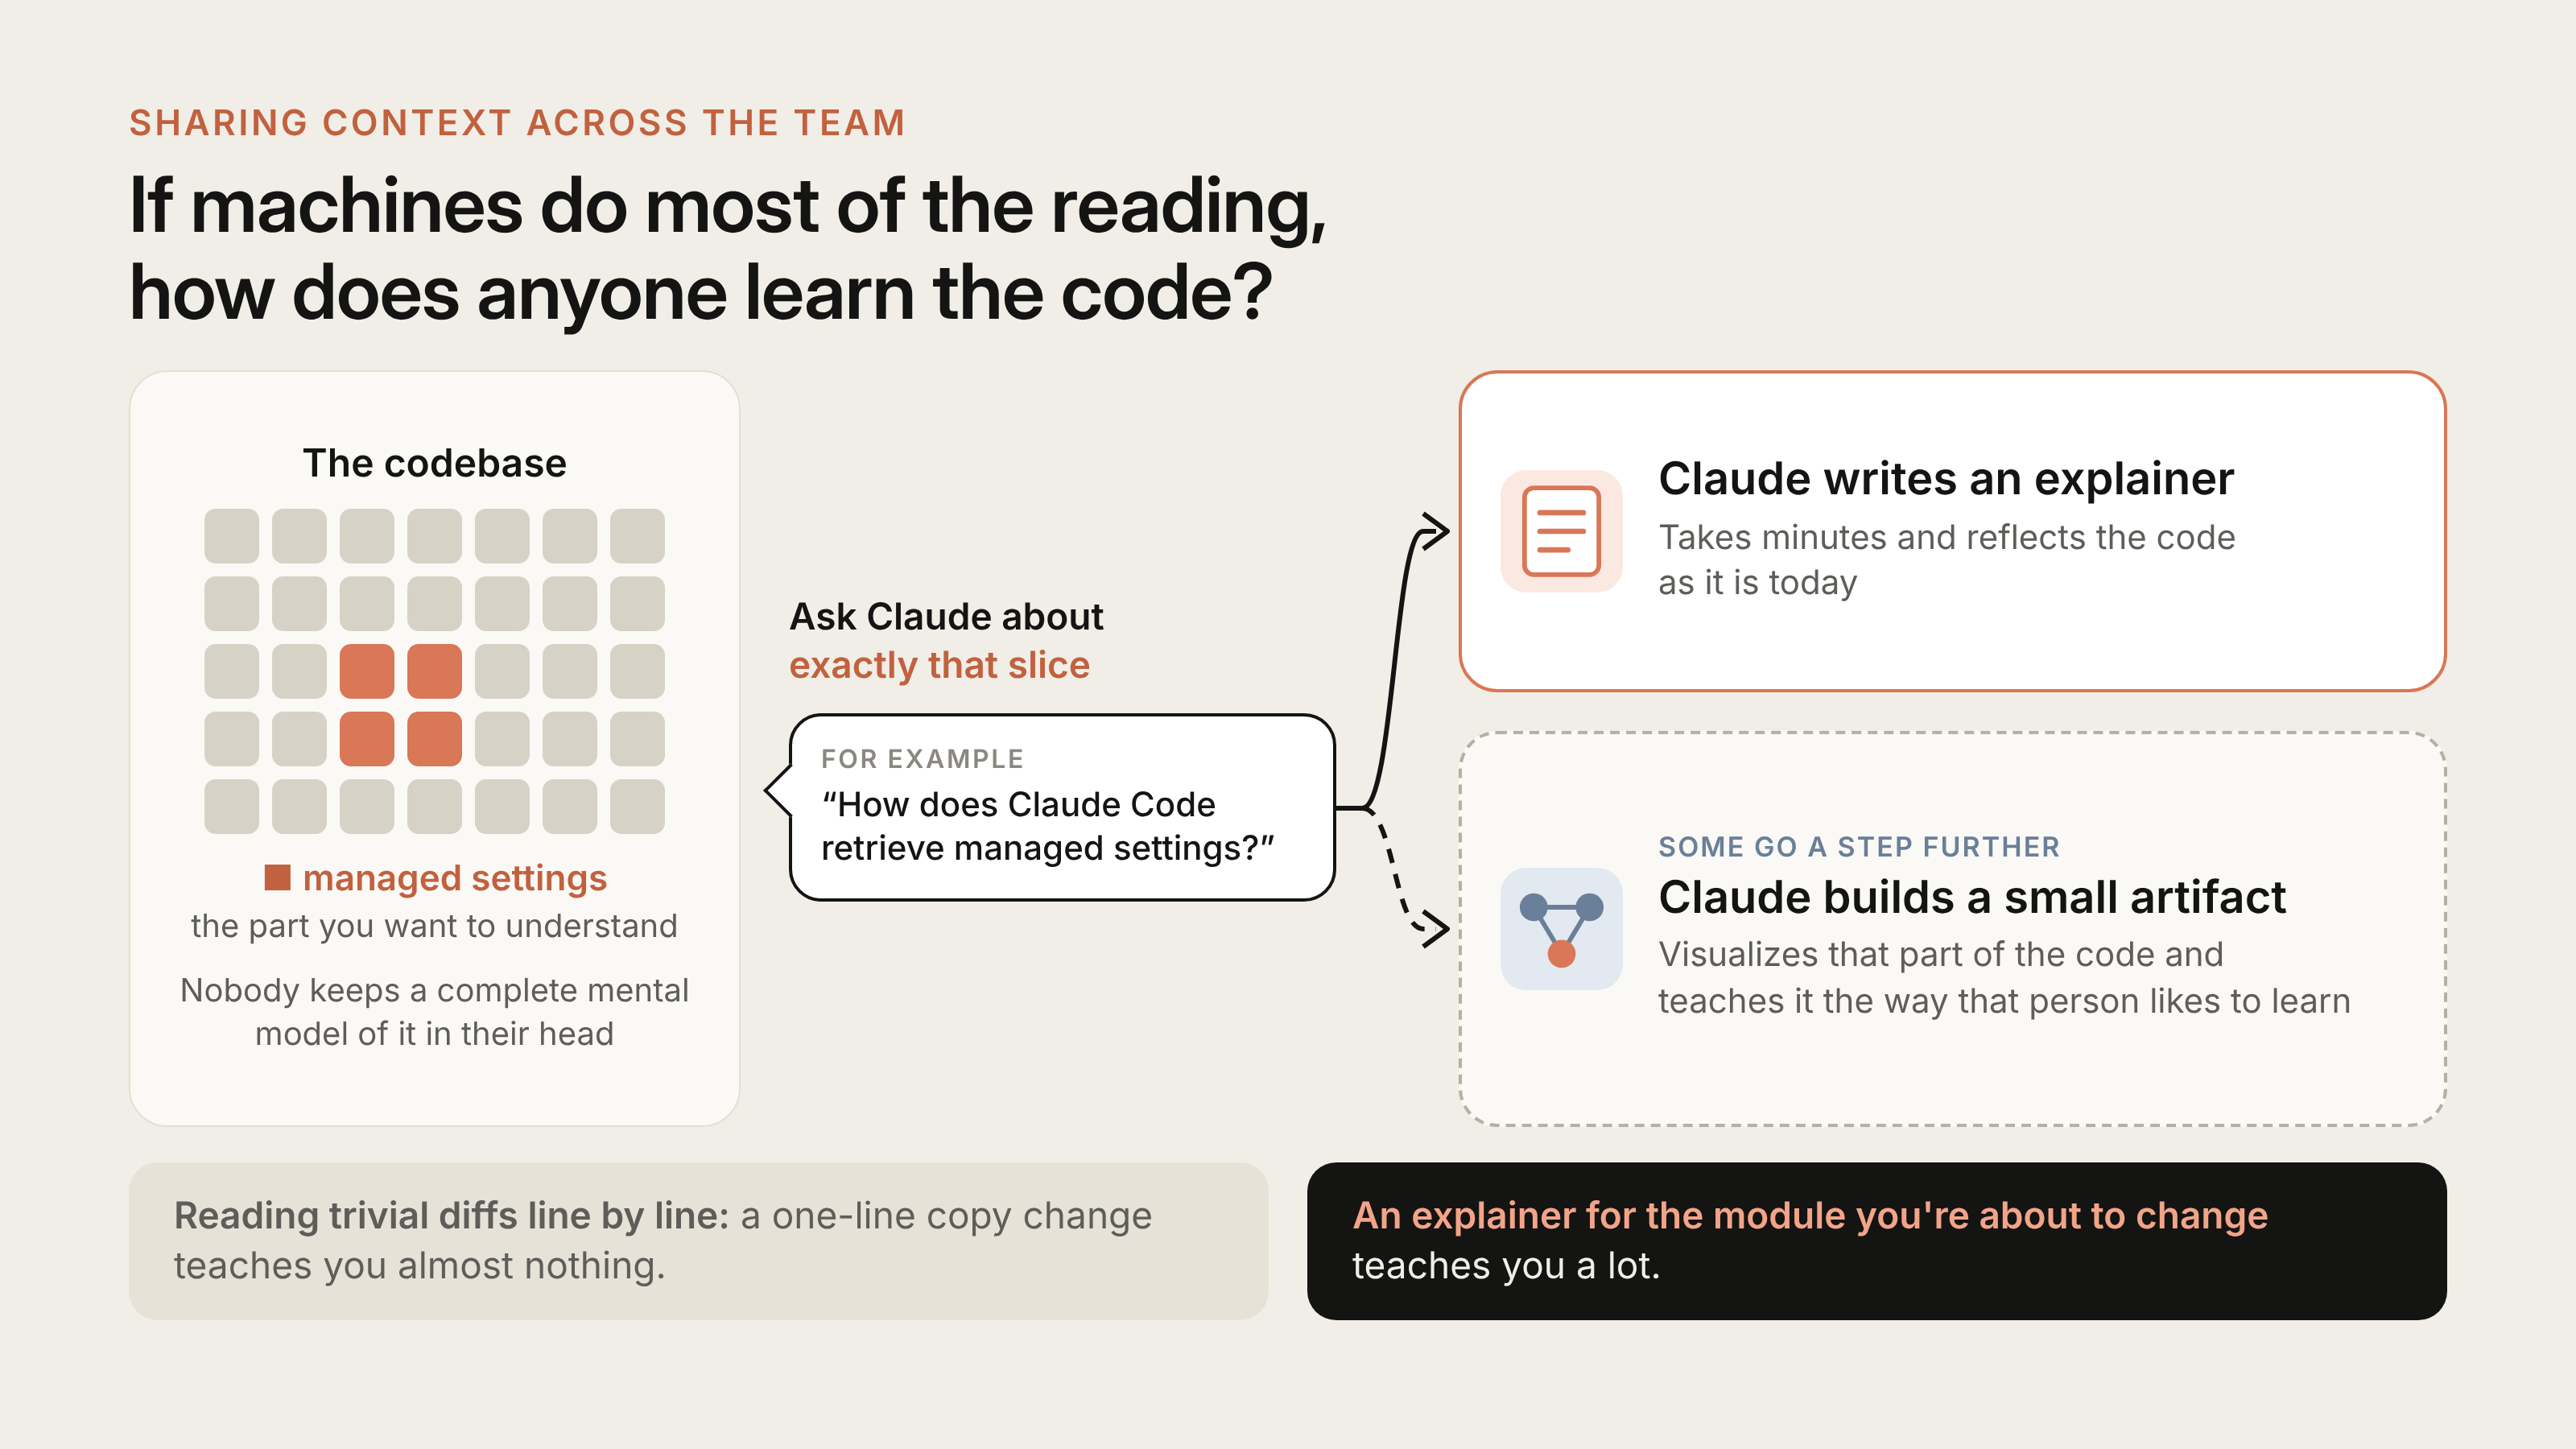
Some of us go a step further and have Claude build a small artifact that visualizes that part of the code and teaches it the way that person likes to learn.
If the goal is to spend human attention well, this beats reading trivial diffs line by line. A one-line copy change teaches you almost nothing. An explainer for the module you're about to change teaches you a lot. Our culture of defaulting to working on open Slack channels helps too, since you see what others are building while they build it.
"YOU LAND IT, YOU OWN IT"
If you land a small or medium change and something still goes wrong, it's a team norm that you usually fix it. A few things keep this from going badly:
- Changes are small, so they're easy to review, debug and revert.
- Everything is reversible. Flags, reverts and staged releases undo most mistakes in minutes.
- Blast radius sets the bar. Expensive code gets more people and more checks.
- Regressions surface fast through telemetry and internal use.
- It isn't blame. Owning a fix means you have the most context; incident reviews look at the system.
Ownership is also shared. Much of the team works in open channels where anyone can see what others are building, pick up a thread, or point a Claude at a gap, and feedback comes from people who don't own the code too. That openness is a big part of how quality stays high without a gate on every line.
WHEN WE CHANGE DIRECTION
Agents make it cheap to start things, so some work shouldn't land. Usually someone in the channel asks why, points at an earlier decision, or suggests a simpler route, and the author closes or reshapes the PR.
Since the code was fast to write, closing the PR doesn't feel like a loss. The trick is to raise a different direction in the thread early, not as a blocking comment on a finished PR.
HOW YOU CAN ADOPT THIS PROCESS
Most of the pieces to do this with your team exist today.
Before the pull request
- Give your agent checks it can run, listed in a short
CLAUDE.md, plus hooks that run formatters and linters. - Run
/code-reviewand/security-reviewlocally, or a fresh-context subagent review. - Add a
REVIEW.md, and move repeated review comments into it.
On every pull request
- Require CI, and add "Testing", "Risk" and "How to revert" to your PR template.
- Add an AI reviewer (Code Review for Claude Code, or the Claude Code GitHub Action) on one repo, tune
REVIEW.mdfor a few weeks, then widen. - Add automated security review, and require every review thread resolved before merge.
- Match review effort to risk: a quick pass on routine changes, a deep one where a missed bug is expensive (Quick, Standard or Deep in Code Review).
- Cap review rounds; after the first few, re-review only the new diff.
Approval
- Write down risk tiers, set from the change rather than the author; start strict and loosen with evidence.
- Keep the lighter approval paths for authors you trust.
- Use CODEOWNERS and branch protection so auth, billing, CI and release workflows, and installers always need a person.
- Never let a bot's approval replace a required human's; dismiss approvals on new commits.
Merge and after
- Use a merge queue, feature flags, internal use first, staged releases and one-step rollback.
- Turn incidents and reverts into an eval set, and rescore the reviewer whenever its prompts, tools or model change.
- Measure human time, with revert and incident rates as the guardrail.
WHERE THIS IS GOING
Code Review's announcement said approving a pull request is still a human call; the product posts findings, not approvals. Our own repos go further, letting owners decide which low-risk changes merge on automated checks alone, and that line keeps moving.
When a review misses something, we ask what the model didn't have in front of it and put the fix into a CLAUDE.md, a skill or a new check. The goal hasn't changed: less human time per change, and no more reverts than before.
If your team lets agents open pull requests, we'd like to hear which checks you've automated, which still need a person, and what you think we have wrong.
With thanks to Emma Webb, Michael Segner and Amie Rotherham for their reviews.