Databricks 实测:在数百万行复杂代码库中,到底哪种模型和 Harness 框架性价比最高、用起来最顺手
- Databricks 把主流 AI 编程助手拉到自家几百万行代码上考了一遍,考题从工程师已经合并的 PR 改造而来,网上搜不到、模型没背过
- 最反直觉的一条:按 token 单价挑模型会挑错。Sonnet 5 每 token 比 Opus 4.8 便宜 1.7 倍,一道题做下来反而更贵($2.09 对 $1.94),分还低 6 个点
- 外壳比模型更影响花销。同一个模型同一个思考档位(thinking effort),换个外壳成本能差两倍以上,差别在每轮往模型嘴里塞多少上下文:Opus 走 claude code 每题累计 742k token,走 pi 只要 236k
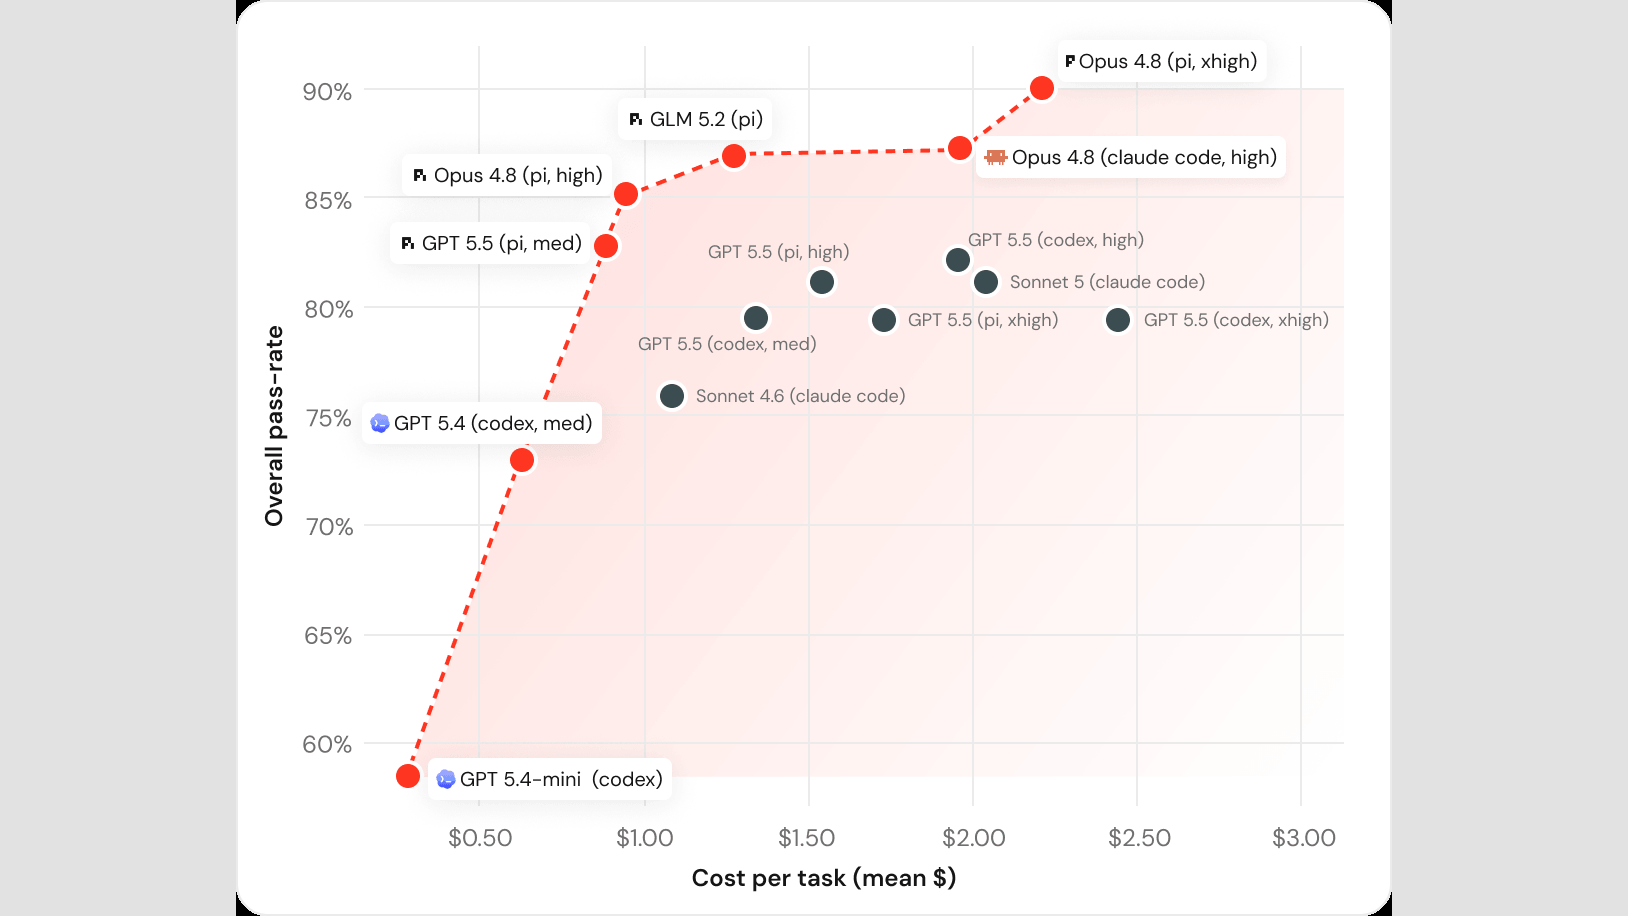
- 开源模型进了第一梯队:GLM 5.2 质量和 Opus 4.8 打平(都是 87%),每题 $1.28 对 $1.94
- 思考档位不是越高越好:Opus 4.8 拉到 max 档,每题 $3.6 只拿 82 分,比 high 档的 $0.93、85 分又贵又差
这是 Databricks 官方发的一份内部实测总结,要回答的问题是:在一个几百万行的大型代码库里,哪种 AI 编程 Agent(模型 + 运行框架的组合)性价比最高、用起来最顺手。7 月 8 日发布,五位作者里包括他们的 CTO、Spark 的作者 Matei Zaharia。
先说说 Databricks 是谁
做数据和 AI 平台的公司,2013 年由 Apache Spark 的原班人马创立。Spark 是大数据处理领域用得最广的开源引擎之一,全世界的企业拿它跑数据管道和机器学习任务。这家公司现在给一万两千多家企业提供数据平台,2026 年 2 月完成 L 轮融资,估值 1340 亿美元,年化收入 54 亿美元。
作者分量。五位署名作者里有两位是 Databricks 的联合创始人:Matei Zaharia 是 Spark 的作者、现任 CTO,Patrick Wendell 同为联合创始人。
代码库够复杂。Scala、Go、Rust、Java、Python、TypeScript、Bazel、Protobuf 都在用,工程师每天合并上千次代码改动。这种复杂度是公开测试集模拟不出来的。
动机是省自己的钱。他们做这套测试是为了让自家工程团队用 AI 更划算,属于内部体检,做完把方法和数据一起公开了,不是对外的产品评测。
做法说起来不复杂:拿自家工程师平时写的真实代码改造成考题,跑一遍主流的模型和框架组合,看谁做得对、各花多少钱。得出的几条结论,和大部分人现在的选型习惯是反着的。

下面是六条结论,最后一节是可以照着做的部分。
模型分成了「三大梯队」,没必要凡事都用最贵的
他们没有盯着名次看,因为几个点的差距在真实任务里会被拉平。有用的是分组:所有模型和外壳的组合,清楚地落进三个能力档。
| 档位 | 通过率 | 里面有谁 |
|---|---|---|
| 第一档 | 82–90% | Opus 4.8、GLM 5.2、GPT 5.5 的高配组合 |
| 第二档 | 71–82% | Sonnet 5、Sonnet 4.6、GPT 5.5 中配、GPT 5.4 |
| 第三档 | 51–60% | GPT-5.4-mini、Haiku 4.5 |
日常小活不用顶配。改个开关、更新个配置这类操作,中低档模型完全够用,而且便宜得多。但他们过去的默认设置一直是最贵的那些。
分工比升级更划算。看完数据,他们决定把更多任务推给 Haiku 和 GPT 5.4 Mini 这一档,只有复杂的架构探索和深层排错才调最聪明的模型。

该把哪些活推下去,先看日志算出来
动手之前,他们先把所有 AI 编程会话的日志捞出来,看工程师到底在让 AI 干什么。

约四分之一是低复杂度的活,六成是中等难度,真正需要深度设计探索的只有 12.1%。而默认配置里用的一直是最贵的模型,这中间的浪费是明摆着的。
开源/国产模型崛起,完全能当日常「主力机」
第一档里坐着一个开源模型:GLM 5.2,智谱做的。
质量和 Opus 4.8 打平。两者的通过率都是 87%,统计上分不出高下。
每题便宜约三成。GLM 5.2 每道题 $1.28,Opus 4.8 是 $1.94。
正在往主力位置上放。此前已有内部开发者拿它做日常开发试用,这次的分数和这些人的反馈对上了,据此他们判断可以开始把它铺开当日常主力。
「单 token 便宜」不等于「最终省钱」
挑模型时几乎所有人都在看同一个数字:每百万 token 多少钱。这个数字预测不了你最后要付多少。
该看的是每做完一件事花多少钱。它和 token 单价之间隔着一个变量:模型为了做完这件事,到底要读多少、想多久。
反直觉的例子在 Sonnet 5 身上。它的 token 单价比 Opus 4.8 便宜约 1.7 倍,但每道题花 $2.09,Opus 4.8 花 $1.94。单价便宜的那个,总账更贵。
贵出来的钱花在绕路上。Sonnet 5 读更多文件、想更久、来回更多轮,吃掉 1.9 倍的 token,通过率还低 6 个点(81% 对 87%)。
运行框架(Harness)对成本的影响巨大
同一个模型、同一个思考档位,只换外壳,每题成本能差两倍以上,质量基本没动。大部分人根本没把外壳当成一个可以选的东西。
同一个厨师在不同的厨房里做同一道菜,出菜速度和成本能差一倍,厨房就是外壳。
成本差两倍,质量基本不动。pi 在每一组对照里都更便宜,倍数从 1.20 到 2.08;六组里五组的通过率差在 3 个点以内。
差别全在上下文管理上。每完成一道题累计喂进模型的内容,Opus 4.8 走 claude code 是 742k token,走 pi 只要 236k。


| 模型 · 思考档位 | pi 便宜 | 通过率(pi / 原生) |
|---|---|---|
| Opus 4.8 · high | 2.08× | 85% / 87%(−2) |
| Opus 4.8 · xhigh | 1.46× | 90% / 88%(+2) |
| Opus 4.8 · max | 1.20× | 82% / 89%(−7) |
| GPT-5.5 · medium | 1.54× | 83% / 80%(+3) |
| GPT-5.5 · high | 1.22× | 81% / 83%(−2) |
| GPT-5.5 · xhigh | 1.44× | 78% / 80%(−1) |
pi:工具箱里只有四件东西的编程助手
pi 和 Claude Code、Codex 是同一类东西:装在自己电脑上,在终端里跑,你用一句话说清要干什么,它自己去翻代码、改文件、跑测试,做完了告诉你。
整个工具箱只有四件。读文件、写文件、改文件、执行命令。别的能力等真用上了再临时加载。
常驻说明书不到 1000 个 token。大约五六百个汉字的量。
谁做的。Armin Ronacher 和 Mario Zechner。前者在 Python 圈子里很有名,Flask 和 Jinja2 这两个被用了十几年的框架都是他写的。项目开源免费,GitHub 上大约 5.4 万颗星,接哪家的模型都行。
薄,就是它省钱的全部原因。每一轮对话,外壳都要把一批东西重新塞给模型:常驻说明书、所有工具的用法、之前聊过的内容、这次要看的代码。工具越多、说明书越长、留存的历史越全,这一坨就越大,而它每轮都要重新付一次钱。
少喂的那部分信息并没有丢,等模型真需要的时候,它自己调「读文件」去取。这套做法能成立,前提是模型肯主动去找、也找得回来。
思考档位拉满,又贵又差
把模型的思考档位调到最高,不一定更准,但一定更贵。
| 组合 | 每题成本 | 通过率 |
|---|---|---|
| Opus 4.8 · pi · high | 约 $0.93 | 85% |
| Opus 4.8 · pi · xhigh | 约 $2.20 | 90% |
| Opus 4.8 · pi · max | 约 $3.60 | 82% |
| GPT 5.5 · codex · med | 约 $1.33 | 79.5% |
| GPT 5.5 · codex · xhigh | 约 $2.42 | 79.5% |
档位和成绩不是单调关系。Opus 4.8 走 pi:high 档每题不到一块钱拿 85 分,max 档花到三块六反而掉回 82 分。中间的 xhigh 档才是这个组合的最高点,90 分。
有时多花的钱一分没换来东西。GPT 5.5 走 codex,med 档和 xhigh 档的通过率完全一样,都是 79.5%,后者贵了将近一倍。
档位名跨模型不可比。high、xhigh、max 是各家自己定义的名字,别把不同厂商的同名档位当成同一件事。
为什么不直接用公认的 SWE-Bench 等测试集
上面这些结论能不能信,取决于这套考题是怎么出的。公开题库回答不了他们的问题。
答案会泄露。题目和解法都是公开的,时间一长就漏进了模型的训练数据,考的就不再是能力。
不贴合真实环境。他们的代码库横跨十几种语言,Scala、Go、Rust、Java、Python、Bazel、Protobuf 都有,还有大量微服务,通用题库反映不出这种复杂度。
所以他们把自家工程师每天合并的代码改造成考题。一个通过评审的 PR 本身就是一份好材料:有开发者一步步修改的提交记录,有人工评审,还有验证这次改动对不对的测试。
先筛,再改造
| 筛选条件 | 为什么 |
|---|---|
| 够新 | 用最近的记录,题目才反映现在的框架、写法和规范 |
| 人写的 | 机器人提交、服务账号、AI 生成和自动生成的改动全部剔除 |
| 带高质量测试 | 没有测试就没有判卷标准 |
| 改动集中 | 只动少数几个模块,不是横跨半个代码库的大重构 |
| 覆盖全栈 | Scala 后端、Rust 系统代码、React 和 TypeScript 前端、protobuf 和 gRPC 接口、Bazel 配置都要有 |
重写题面时删掉解法。PR 描述里通常会解释这个 bug 为什么该这么修,那等于把答案写在了题面上。只留下"要达到什么结果"和"有什么限制"。
测试单独拎出来藏好。他们的构建系统本来就能算出哪些测试依赖被改动的文件,直接把这些测试整套跑起来当判卷标准。
每一道题人工过一遍。脚本和 AI 只用来生成候选题。有些题原来的测试要重写:只允许一种实现方式的要放宽,太松的要收紧,这些改写没用 AI,全部手工做。

不用 AI 判卷,因为那会奖励听起来对的答案
判卷的流程是这样:模型自己说"我做完了",就把这一刻的代码存档,把之前藏起来的测试打回去,跑一遍,全过算这道题通过。整个评判过程没有用大模型当裁判,理由是:
We did not use an LLM judge to evaluate correctness, since we've found that this rewards sounding right over being right. 我们没有用大模型来判断对错,因为我们发现那样会奖励「听起来对」而不是「真的对」 · Databricks
测试跑不跑得过是二值的,不存在解释空间。这也是为什么"必须带高质量测试"那道筛子不能省:判卷标准的可信度,全押在这批测试上。
Databricks 是怎么防作弊、做测试的
早期实验里有几个模型的分数好得不真实。把这些运行的完整轨迹调出来人工看,问题出在环境上:每道题都来自一个已经合并的提交,而完整的 git 历史就摆在工作目录里。一个能执行 shell 命令的 Agent,完全可以顺着 git 历史往前翻,直接把当初那个"标准答案"翻出来。
解法很干脆:每次运行期间,把工作副本和仓库整个断开,让 git 历史取不到。

所有编程 Agent 的外壳和模型都用各自开箱即用的标准配置,配上 Databricks 工程师日常能用到的那些常规工具,没有为测试做特殊调优。
总结与启示
这套东西不需要 Databricks 的规模才能做。任何团队只要有一批已合并的 PR,手上就已经躺着一套没有模型训练过的基准,判卷标准就是你自己写的那些测试。
混着用,别指望单一模型。能力前沿同时包含 OpenAI、Anthropic 和开源模型,今天没有哪一家能独占所有档位。
按难度分发任务。六成的活是中等难度,简单任务走便宜模型,复杂设计才调顶配。他们下一步是把这个分发做成自动的。
先量一量外壳这一层。选对外壳有时比换模型更省钱,而这一层大部分团队根本没测过。
成本按每完成一件事算。token 单价预测不了总账,思考档位也不是越高越好。
他们会继续往里加题,尤其是更难的题,之后每出一个新的 Agent 或外壳都过一遍这套考试。
Databricks 在自家几百万行代码上考了一遍:按 token 单价挑模型,会挑错
Databricks 用工程师已经合并的真实代码出题,把 7 个模型、3 种运行框架、4 个思考档位跑了一遍,一页带图讲完。
↓ 一页读完 · 有一张会动的图
公开题库(比如 SWE-Bench)的题目和答案都在网上,时间一长就漏进了模型的训练数据,考的不再是能力。Databricks 换了个办法:拿自家工程师上周刚合并的代码改造成考题。全部数字由 Databricks 自己采集、自己判卷,第三方尚未复现。
同一批题、同一套判卷标准,7 个模型 × 3 种运行框架 × 4 个思考档位跑下来,成绩落进三个档。第一档里坐着一个开源模型:智谱的 GLM 5.2 拿 87%,和 Opus 4.8 打平,每题 $1.28 对 $1.94。
挑模型时几乎所有人都在看每百万 token 多少钱。这个数字和你最后要付的钱之间,隔着一个变量:模型为了做完这件事,要读多少、想多久。
外壳(harness)是把模型的输出变成实际操作的那层软件:决定每轮给模型看多少代码、能调用哪些工具、失败了怎么重试。Claude Code、Codex、pi 都是外壳,底下换成谁家的模型都能跑。同一个模型、同一个思考档位,只换外壳,每题成本能差两倍以上。
同样跑 Opus 4.8、同一批题,每完成一道题累计喂进模型的内容差 3.2 倍。少喂的信息没丢,模型需要时自己调「读文件」去取。pi 是 Armin Ronacher(Flask、Jinja2 的作者)和 Mario Zechner 的开源项目,GitHub 约 5.4 万颗星,这层背景原文没交代。赢下这局的是个第三方开源项目,Databricks 自家的产品 Omnigent 做的是让你随时换模型换外壳。
1.7×
token 单价
便宜呢!
钱怎么差一倍?
↓
236k
token,claude code
换成 pi
让模型答之前
多想一会儿的旋钮
- × 数字全由 Databricks 自己采集、自己判卷,第三方还没复现
- × 「换外壳质量不变」是六组里五组成立,max 那组差了 7 个点
- × 档位名 high / xhigh / max 各家自己定义,跨模型没法比
token 单价。