Uber 工程团队分享如何在超大规模业务下落地软件工厂:六块底座、Agentic SDLC 与成本控制
一份完整拆解 Uber 软件工厂的工程指南:模型与工具网关、托管 DevPod、Skill 市场、Context Graph、端到端 Agentic SDLC、维护闭环与成本工程。
- Uber 的软件工厂建立在六块底座上:Model Gateway、MCP Gateway、托管 DevPod、Skill Marketplace、Context Graph 和覆盖 Slack、CLI、Web 的 Cortana。
- 一项功能从业务研究、需求和 Figma 设计交给 Minion,先在 inner loop 完成视觉与前后端验证,再进入 CI、深度评审和人工验收;上线后继续进入受控维护循环。代码生成扩大后,CI、实验容量和产品决策会成为新的系统瓶颈。
- 2026 年 2 月到 8 月中旬,Uber 的 Agent 周活增长 7 倍、请求增长 9.4 倍;总支出在 4 月后趋稳,固定模型后的单次会话成本较峰值下降 52%。
- Uber 用真实任务评测、模型分级、上下文压缩、动态工具、code-mode、Context Graph 和会话诊断消除无效 Token,并把运行结果持续反馈给模型路由与 Skill。
Uber 工程团队分享了他们如何在超大规模业务下落地“软件工厂”:把模型、工具、代码、组织知识和执行环境接入统一平台,让 Agent 从辅助个人写代码,走向负责完整、可验证的开发任务。
从 2026 年 2 月到 8 月中旬,Uber 全体员工使用的 Agent 产品周活增长 7 倍,周请求量增长 9.4 倍。请求量接近十倍增长,总 AI 支出却在 4 月后趋于稳定。固定同一个模型观察,每 1,000 次模型请求的成本较峰值下降约 34%,单次会话成本较 6 月峰值下降 52%。
与此同时,超过 70% 的 Pull Request 被归因于本地或云端 Agent;工程师建立了 3,600 多个覆盖软件开发生命周期的 Agent Skill,每天执行超过 30,000 次。代码评审、CI 自愈、带视觉验证的端到端 PR、告警分诊、Bug 调试和代码维护,越来越多由托管 Agent 自动发起,再由人审核或在异常时接管。
这些结果背后是一套完整的工程体系。Uber 用统一模型网关控制身份、隐私、预算和审计;用 MCP 网关向 Agent 开放内部 API;用预启动 DevPod 提供隔离、可复制的跨仓库开发环境;用 Skill 市场治理可复用流程;用 Context Graph 提供服务、团队、数据和事故背景;再通过 Cortana、Minion 等产品,把这些能力组织成一条从业务研究、需求、设计、编码、验证、CI、评审到长期维护的流水线。
成本优化不是这套工厂之外的财务动作。Uber 把总账单拆成六个可测量的乘数,在每一层减少无效轮次、无效请求和无效上下文:强模型只做需要强推理的工作,工具按需载入,轮询和批处理留在脚本,Agent 先查询组织知识再搜索代码,成本和失败轨迹最终又回到模型路由、Skill 和平台默认值中。
下面是 Uber 团队在 AI Engineer World's Fair 2026 的完整演讲,已加入中文在上、英文在下的双语字幕。视频长 18 分 25 秒,字幕采用经确认的 C2 版式,居中显示在 PPT 演示区域内。
演讲人:Uday Kiran Medisetty、Adam Huda(Uber)。字幕为中文在上、英文在下。
核心背景:AI 已经进入大部分开发日常
Uber 的规模数据需要分成“采用”“吞吐”“自动化范围”和“单位经济”四层理解。
- 采用范围:从 2026 年 2 月到 8 月中旬,Agent 周活增长 7 倍,请求量增长 9.4 倍。使用者覆盖工程师和非工程员工,已经超出小规模 AI 试点。
- 开发渗透:超过 70% 的 PR 被归因于本地或云端 Agent。这说明 Agent 已经进入大量真实代码变更,但 Uber 没有公开 attribution 的具体计算方式,因此不能把它改写成“70% 的代码完全由 AI 无人值守生成”。
- 流程资产:截至 8 月,Uber 已有 3,600 多个 Agent Skill,每天执行超过 30,000 次。Agent 的能力不再只存在于个人对话里,而是逐渐沉淀成组织可复用的工作流。
- 托管任务:越来越多会话不由人类即时输入 Prompt 发起。代码评审、CI 修复、告警处理、Bug 调试和代码维护可以由事件或计划触发,人工主要负责目标、审批和异常升级。
6 月的 AI Engineer 演讲还给出两组吞吐数据:Uber 表示,每位工程师的代码行数同比约为原来的两倍;250 多项自动迁移累计处理了约 900 万行代码。自动迁移比“生成更多新代码”更能说明 Agent 的组织价值——大规模依赖升级、API 替换、配置迁移和机械性重构,以前需要许多团队分批排期,现在可以由统一流程批量执行。
代码行数只能表示产出体量,不能替代质量、业务效果或工程价值。大量低质量代码同样会推高行数。Uber 后续仍然用回滚率、F1、MTTR、PR 是否合并等指标判断 Agent 是否交付了可接受结果。

请求量增长 9.4 倍,总支出没有按相同斜率增长,说明单位成本在下降。不过,“总成本趋稳”不等于总成本持续下降。模型版本、任务类型和采用率一直在变化,直接比较月度账单会把多种因素混在一起。
Uber 因而固定同一个模型观察单位经济:每 1,000 次请求成本较峰值下降约 34%,单次会话成本较 6 月峰值下降 52%。后一个指标从 5 月底才开始记录。

这些结果也不是突然出现的。Uber 明确提到,此前六年向 monorepo 和 Bazel 的迁移,为软件工厂打下了基础。统一代码组织、可重复构建、依赖图、远程执行和标准测试,让 Agent 能够可靠定位代码、跨仓库修改并重复验证。代码库仍然碎片化、构建过程依赖个人电脑时,托管 Agent 很难获得稳定环境,更难安全地扩大并发。
软件工厂的结构:四层工作模式与六块基础设施
Uber 用两个互补视角描述软件工厂。
第一个视角是工作如何发起:从人类直接操作通用 Agent,到系统自动分配边界清楚的任务。第二个视角是所有 Agent 共同依赖什么:模型、工具、执行环境、Skill、组织知识和统一产品入口。
四层工作模式:平台逐步接管不确定性

第一层是原始交互会话。工程师在本地使用 Claude Code、Codex、OpenCode 等工具,自行提供 Prompt、上下文和过程指令。任务边界随对话变化,平台很难预先判断一次 session 最终会交付什么。
第二层是带 Skill 的交互会话。工程师仍然主动发起工作,但重复任务有了共享步骤、工具和验收方式。个人经验开始变成组织资产。
第三层是通用托管 Agent。Agent 在统一云环境中运行,可以调用多个 Skill。安装、认证、权限、算力和代码环境不再依赖个人机器,平台也能观察每个任务的成本、延迟和结果。
第四层是专用托管 Agent。每个 Agent 对应一个稳定结果:Minion 生成 PR,uReview 做代码评审,Conan AI 分析告警根因,Fawkes 执行周期性代码维护。成本可以按“每个合并 PR、每次 review、每个 alert、每次 cleanup”计算,再与 F1、回滚率和 MTTR 一起评估。
越接近第四层,平台越能固定输入、限制工具、选择模型、提供背景、运行 benchmark、验证结果,并在失败时升级给人。开放式聊天由工程师吸收不确定性;托管 Agent 则要求平台把不确定性变成可配置、可观察的工程问题。
六块基础设施:让托管 Agent 真正能够运行
| 基础设施 | 负责什么 | 解决的规模问题 |
|---|---|---|
| Model Gateway | 模型接入、身份、隐私、策略、计量和审计 | 不让每个产品分别连接供应商、分别计算成本 |
| MCP Gateway | 把内部 API 与 SaaS 工具统一开放给 Agent | 不让每个团队重复处理认证、安装和工具协议 |
| DevPod | 提供隔离、预启动、可复制的完整开发环境 | 不让长任务依赖个人电脑,也避免冷启动和环境漂移 |
| Skill Marketplace | 管理可复用工作流的发现、质量和版本 | 不让 Skill 重复建设、难以安装或质量失控 |
| Context Graph | 汇集服务、代码、团队、数据、事故和设计关系 | 不让 Agent 到几十个系统里盲目搜索背景 |
| Cortana | 把模型、工具、Skill 和知识带到 Slack、CLI 与 Web | 不让底层能力变成只有平台专家才能使用的组件 |
1. Model Gateway:所有模型流量先经过一个控制平面
Uber 将内部应用、编码 Harness 和外部用例收束到同一个兼容 OpenAI 与 Anthropic 的入口。工程师使用普通客户端,只需提供项目 ID,平台处理其余工作。
这个网关有三个硬目标:默认不让 PII 离开 Uber 边界;新增安全控制的延迟必须有严格上限;每次请求必须能归因到具体用户、项目和团队。
为此,请求先经过基于 SPIRE 的身份认证,再由数据匿名化层清理 20 多类 PII,随后由五个专用模型执行安全与策略检查。Uber 表示,整套控制的延迟保持在 100 毫秒以内。
网关同时记录审计日志和 session trace,并将它们送入数据湖、benchmark 与持续改进流程。预算分层、模型成本分析和会话诊断之所以能够跨工具统一运行,根本原因是模型调用已经在这里获得统一身份和项目归因。
演讲时,这个入口服务 800 多个内部项目,每天处理超过 1 亿次模型请求。这个数字覆盖编码与非编码用例、前沿模型与开源模型,也包含内部托管和供应商托管模型,不能与文章里的 Agent 周请求量直接相加。
2. MCP Gateway:统一工具接入,再消除工具目录的 Token 税
Uber 原本有数千个内部 API,但它们不会自动变成 Agent 可调用工具;Google、Slack、Jira 等 SaaS 又各有不同的认证和安装过程。
MCP Gateway 用自动爬虫把内部 API 投射为 MCP Server,也统一托管第三方 SaaS MCP,负责 Token 交换、认证和策略。工程师只面对一个入口和一种安装方式。
直接 MCP 模式随后暴露出新的规模问题:工具越多,发送给模型的 Schema 越多。Uber 先推出 Omni MCP,让一个 MCP 负责发现和调用网关内其他工具;随后把工具投射成 CLI,使工具定义和大量响应不必长期留在上下文;再自动安装 code-mode Skill,让 Python 脚本在子进程中完成循环和汇总。
演讲给出的总体结果是,这一组 MCP 优化为全公司带来超过 40% 的节省。8 月文章进一步公开了 Schema 开销和 SQL 对照,后文会展开其具体机制。
3. DevPod:给 Agent 一个秒级启动、隔离且跨仓库的工作台
长时间运行的托管 Agent 需要比本地终端更稳定的环境:启动要快,任务之间要隔离,可以同时实例化很多份,还要覆盖 Uber 的全球技术站点。
Uber 将已有的云端远程开发环境 DevPod 改造成 Agent 执行底座。Kubernetes balloon pod 会提前创建,代码仓库快照和搜索索引也预先准备好。Agent 获得任务时直接接管一个现成环境,可以在几秒内开始工作。
原来的 DevPod 按 Go、Java、Android 等技术栈区分。Agent 出现后,任务和工程师角色都开始跨越仓库边界。Uber 因而构建 mega-DevPod,把多个代码仓库放在一个统一环境中,供自主编码 Agent 同时修改前端、后端和共享依赖。
托管在这里的含义很具体:Agent 的代码、依赖、构建工具、搜索索引、权限和生命周期都由平台准备,而不是让每个工程师临时拼装一台“能跑 AI”的机器。
4. Skill Marketplace:把工作流当作需要治理的软件产品
Uber 早期看到大量工程师在不同仓库重复开发相同 Skill。发现、安装和配置困难,一部分 Skill 的质量也不稳定。
平台因此为 Skill 建立完整生命周期:核心 Skill 与领域 Skill 进入统一市场,经过 lint 和自动化 review,达到基础质量线后才能分发;工程师用一条命令发现和安装插件;平台还会根据工程师角色自动配置默认 Skill,让 Agent 能够直接选择正确流程。
Skill 上线不是终点。Uber 开始收集执行 trace、用户评论和持续评测,把失败、返工和使用摩擦反馈给 Skill 作者。这样,Skill 的改进不再依赖作者偶尔听到抱怨,而是依赖真实执行数据。
6 月演讲披露 2,500 个 Skill、每天 20,000 多次执行;8 月官方文章已经增长到 3,600 多个、每天 30,000 多次。正文使用较新的数字,早期数字只说明这套市场仍在快速扩张。
5. Context Graph:把分散在几十个系统里的组织背景连起来
Agent 在大型 monorepo 中往往有能力写代码,却缺少服务位置、负责人、依赖关系和工程模式等背景。答案分散在代码目录、服务目录、设计文档、Jira、事故系统、数据目录和历史查询中;如果每个系统都需要独立 Skill 和 MCP,Agent 会先花大量 Token 拼背景。
Uber 将这些关系连接到一张 Context Graph。它覆盖移动端、后端、数据湖、设计文档、事故、Bug、团队和服务关系,并向 on-call 根因分析、规划、数据分析和安全扫描提供统一上下文。
6 月演讲使用“4,000 万条目、150 种节点与边类型”的口径;8 月文章改用“2,400 万节点、8,000 万条边、86 种节点和 117 种边类型”。条目、节点和边不是同一单位,两组数据不能拼接。后文涉及精确规模时采用较新的 8 月口径。
6. Cortana:把基础设施包装成每个人能使用的入口
模型、工具、环境、Skill 和知识图谱如果只能通过内部平台 API 使用,软件工厂仍然停留在基础设施层。
Uber 用 Cortana 把这些能力带到 Slack、CLI 和 Web。员工可以在团队 Slack 频道提出问题,Cortana 查询 Context Graph、调用 Skill、检查任意代码库,再把答案带回原来的协作场景。团队还可以加入自定义 Skill 和 Prompt,形成了解该团队背景的 persona。
演讲前一个月,Uber 创建了 300 个团队 persona,每天产生超过 20,000 次 Cortana session。这个数字说明统一入口不只服务写代码,也服务业务研究、数据查询、规划和多人协作。
六块基础设施之间不是并列采购清单。Model Gateway 决定模型调用如何受控;MCP Gateway 决定工具如何受控;DevPod 决定执行如何受控;Skill Marketplace 决定流程如何受控;Context Graph 决定背景如何受控;Cortana 决定这些能力如何进入真实工作。
一项功能如何穿过完整的软件工厂
六块底座组合起来后,软件工厂才出现。Uber 在演讲中用一项世界杯功能演示了完整路径:大型场馆散场时,为乘客推荐一个更容易离开拥挤区域的上车点。
这个例子展示了任务如何交接。不同 Agent 沿同一条生命周期消费上游产物、调用专门环境,并向下游交付可验证对象。
第一步:先判断是否值得做
团队从 Slack 中讨论想法,随后邀请 Cortana 加入。Cortana 利用 Context Graph 研究历史大型活动、可能适合的场馆和业务机会。
这一步已经超出“根据一句需求写代码”。Agent 首先帮助团队理解问题、寻找内部数据并形成决策材料。演讲最后强调的新瓶颈也从这里出现:当代码越来越容易生成,团队需要更早回答“是否应该构建”。
第二步:把想法收敛成需求和实验
团队确定先在北美范围试验,并让 Cortana 协助形成 Figma 方案。界面准备两个按钮文案版本,用 A/B 实验比较表现。
需求、发布范围、实验变量和设计规格成为后续 Agent 的明确输入。没有这些约束,编码 Agent 只能自行猜测产品行为;有了它们,系统才可能判断生成结果是否符合预期。
第三步:从产品上下文交接到编码 Agent
Cortana 分析现有 App 中可以复用的页面、后端能力和预期代码改动,然后把任务交给 Uber 的云端编码 Agent Minion。
Minion 可以交互运行,也可以自主执行。它获得一个完整 mega-DevPod,在同一环境里修改前端和后端代码。交接内容包括需求、设计、代码背景、工具和可执行环境,远多于一段孤立 Prompt。
第四步:只生成 draft PR,暂时不进入 CI
Minion 完成代码后停在 draft PR,不立即把修改推入 CI。
这项设计针对一个容易被忽略的规模问题:Agent 提高代码吞吐后,未经验证的变更也会大量增加。如果每个自动生成 diff 都直接占用完整 CI,软件工厂只是把瓶颈从工程师时间转移到构建队列和测试资源。
因此,Uber 先要求 Agent 在更便宜、更靠近代码的 inner loop 中完成自我验证。
第五步:把更多验证移入 inner loop
inner loop 包含原有静态检查,也加入过去往往要等 CI 或人工评审才发现的问题:
- 启动移动端模拟器;
- 调用 Skill 截取页面;
- 将截图与 Figma 规格比较;
- 启动后端 staging 服务;
- 验证前端与后端是否能够真实联通;
- 发现问题后直接修改,再重新执行检查。
视觉验证需要确认页面可运行,也要核对 A/B 版本中的按钮文字、布局和交互是否与设计输入一致;前端截图正确但后端接口失效,同样不能进入下一阶段。
第六步:通过内层验证后再进入 CI 和深度评审
完成 inner loop 后,PR 才进入 outer loop。CI 中仍可能出现错误,Uber 使用 self-healing CI 自动诊断并修复一部分失败。
代码评审也分层运行:inner loop 使用更小、更快的模型做即时检查;outer loop 使用能力更强的模型和专用 Skill 做深度 review。分级同时匹配成本、反馈速度和问题难度:本地小问题需要快速迭代,合并前风险判断需要更强推理。
第七步:把验证证据交给人,而不只交付一段代码
自主 diff 最容易让审阅者不安的地方,是不知道 Agent 在生成第一版后还做过什么。Uber 因而在 PR 中附上检查表,列出已经运行的静态检查、模拟器验证、前后端集成、CI 和代码评审,并附带截图。
人类看到的不再只是“Agent 生成了这些代码”,而是“这份变更经过哪些步骤、哪些检查通过、哪里仍需要人工判断”。人工 review 没有消失,它获得了更完整的证据,也把注意力集中到需求、风险和异常上。
这条流水线揭示了软件工厂的核心变化:开发对象不再只是代码文件,而是一份从需求、设计、实现到验证证据都能被机器读取和继续处理的任务包。
成本拆解:六个乘数怎样落到软件工厂
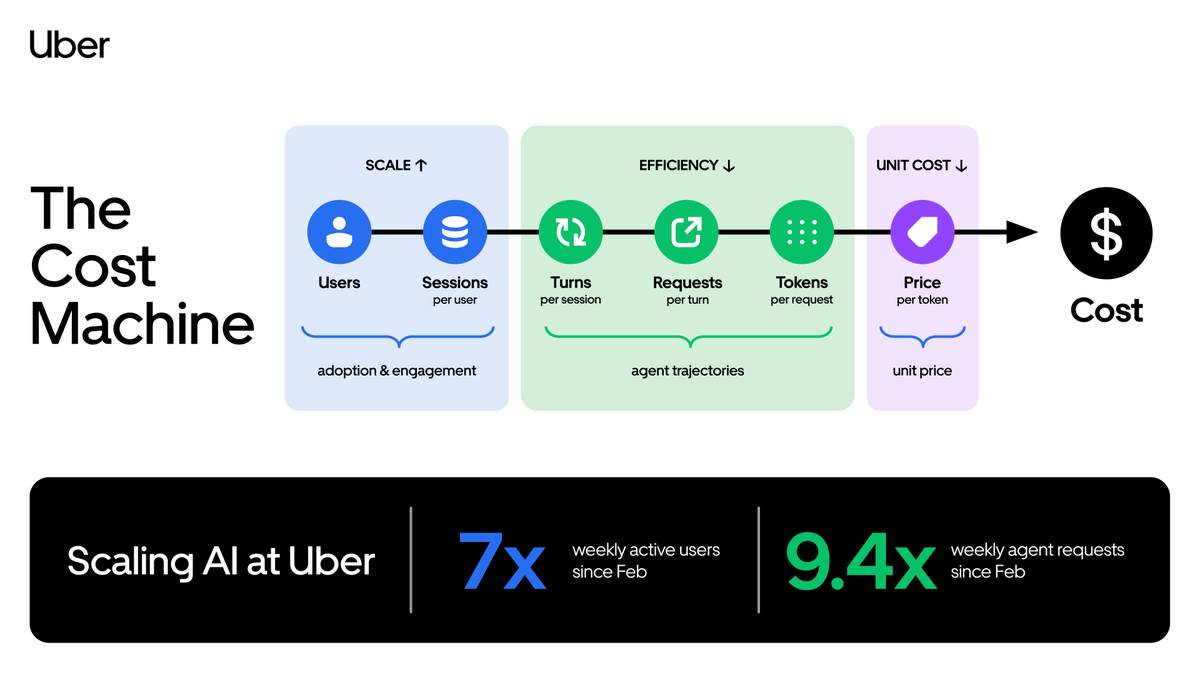
Uber 用一个乘法公式拆解 Agent 总支出:
总支出 = 用户数 × 人均会话数 × 每次会话轮数 × 每轮请求数 × 每次请求 Token 数 × 每 Token 价格

六项的管理目标不同:
| 成本项 | 希望怎样变化 | 对应的软件工厂手段 |
|---|---|---|
| 用户数 | 增长 | Cortana、多入口和统一认证降低使用门槛 |
| 人均会话数 | 增长 | 让 Agent 接手更多有价值、可验收的任务 |
| 每次会话轮数 | 下降或更有效 | 明确需求、Skill、inner-loop 验证和及时停止错误路径 |
| 每轮请求数 | 下降 | Context Graph、正确工具和减少无效 Sub-Agent |
| 每次请求 Token 数 | 下降 | 压缩、缓存、按需工具和 code-mode |
| 每 Token 价格 | 按任务下降 | benchmark 驱动的模型路由 |
前两项代表采用和参与度。软件工厂成功时,它们应该继续增长。Uber 主要压缩中间三项:Agent 在完成用户目标之外,为搜索、轮询、重试和携带冗余上下文制造的额外工作。最后一项由模型选择控制。
调节四组乘数,观察增长和优化如何共同改变相对总支出。
基准:所有乘数均为 1.00×。
乘法关系会放大小浪费。一个从未使用的工具 Schema 如果进入每次请求,会被轮次、会话和用户规模反复放大;一个缺少背景的任务如果搜索十轮,每轮又携带不断增长的历史,请求数和 Token 数会同时恶化。
Uber 因而同时观察五层指标:公司总归因成本、每个工具的单位经济、不同模型的请求和成本份额、成本变化的驱动分解,以及托管 Agent 的结果成本与质量。
真正需要优化的是结果单位:完成一个合格 review、合并一个 PR、处理一个 alert 或清理一项技术债,需要多少钱,质量是否守住。单看“每百万 Token 有多便宜”无法回答这个问题。
成本方法一:用真实任务决定模型分工
模型厂商决定 Token 标价,Uber 决定哪一种任务使用哪一种模型。它没有依赖通用排行榜,而是给每类托管 Agent 建立真实业务 benchmark。
以 uReview 为例,Uber 从带已知 Bug 的真实 PR 中建立评测集,并按 easy、medium、hard 分级。每个模型配置在同一套 Harness 中运行,同时记录:
- precision、recall 和 F1;
- 每次 review 的实际成本;
- 延迟、超时和输出噪声;
- 任务是否稳定完成。
随后只选择位于“成本—质量”帕累托前沿的配置。帕累托最优意味着不存在另一个配置,能在质量不下降时更便宜,或在成本不增加时质量更高。模型能力持续变化,这条前沿每隔几周就可能移动,因此模型路由是一项持续评测工作。

交互式 Agent 采用主模型与 Sub-Agent 分级:主 Agent 理解目标、拆解任务、分配工作和验收结果,默认使用能力更强的模型;Sub-Agent 接收范围更窄、输入更明确的任务,默认使用更便宜的模型,同时保留人工覆盖入口。
完整 SDLC 进一步展示了另一种分级:inner-loop review 需要低延迟,可以使用较小模型;outer-loop review 负责合并前的深度风险判断,使用更强模型和专用 Skill。
便宜模型只有在任务边界清楚、结果可验收时才真正便宜。主 Agent 拆解错误、工具不完整或系统无法判断完成状态时,低价调用产生的返工可能高于模型差价。
普通团队可以先从代码评审、依赖升级、测试生成或 Feature Flag 清理建立小型 benchmark。评测对象应当是“合格结果”,不是模型输出看起来是否聪明。
成本方法二:压缩请求、工具调用与盲目搜索
Agent 的每一轮通常会重发对话历史、项目说明、工具定义和工具结果。无用信息只要留在上下文里,后续请求就会继续为它付费。Uber 从默认参数、缓存、工具协议、执行方式和组织知识五个位置减少载荷。
1. 在超长上下文失控前主动压缩
即使模型支持 100 万 Token 上下文,Uber 的交互 Harness 也会在 40 万 Token 触发自动压缩。上下文最大容量不等于经济使用容量;历史越长,每轮重复输入越贵,缓存失效后的前缀重建也越昂贵。
推理强度默认设为 Medium。输出 Token 和内部 reasoning Token 通常比输入 Token 更贵,大量日常任务使用 Medium 能在质量和成本之间取得较好平衡。高难任务仍可以提高推理档位,但高档位不再成为所有会话的默认值。
2. 缓存 TTL 按真实会话节奏配置
Prompt Cache 可以复用已经发送的上下文前缀。材料给出的价格关系是:缓存读取约为普通输入价格的 0.1 倍,5 分钟缓存写入约 1.25 倍,1 小时缓存写入约 2 倍。
长 TTL 写入更贵,但工程师可能离开终端查文档、等待构建或开会。5 分钟缓存频繁过期后,下一轮只能重新按全价构建前缀。

Uber 把人类交互主线程从 5 分钟调整为 1 小时;只执行短任务的 Sub-Agent 继续使用 5 分钟。正确做法是统计真实 turn 间隔,再决定 TTL,而不是让所有工作流使用同一个缓存时长。
3. MCP 工具按需加载,取消工具目录的入场税
标准 MCP 会在会话启动时把已安装工具的完整 Schema 塞进上下文。Uber 测得,安装 100 多个工具会给初始 Prompt 增加约 50K—70K Token,并在后续 turn 中重复发送。几个大型 SaaS MCP 叠加后,工具说明甚至可能比要编辑的文件更长。

Uber 使用两条路径消除固定税:CLI 在调用时动态解析目标工具,1,000 多个工具无需预先进入上下文;Tool Search 先搜索目录,只载入当前任务真正需要的 Schema。
统一网关仍然负责认证、策略、审计和计量。变化的只是模型什么时候看到工具定义,以及工具的原始响应是否需要留在历史中。
4. code-mode 把轮询、循环和大结果留在沙箱
异步 SQL 查询通常要经历提交任务、获取 run id、轮询状态 2—5 次、读取结果。标准工具调用让模型参与每一步,所有中间状态都进入上下文。
code-mode 让模型生成 Python 脚本,由子进程完成提交、轮询、过滤和汇总,只把最终摘要送回模型。交互轮次从 3—7 次缩成一次脚本执行。

| 查询 | 标准工具调用 Token | code-mode Token | 节省 |
|---|---|---|---|
SELECT 1,1 行 |
903 | 402 | 55% |
COUNT(*),1 行 |
954 | 403 | 58% |
GROUP BY LIMIT 20,20 行 |
1,600 | 457 | 71% |
SHOW COLUMNS,175 行 |
2,200 | 900 | 59% |
宽表 SELECT *,50 行 |
1,431,594 | 900 | 约 100% |

小结果集也节省一半以上,说明收益不只来自过滤宽表。Schema 初始化、多轮轮询、重复状态和逐步推理都被移出模型上下文。批量工作流把 N 次模型 turn 变成一次脚本,节省可以超过 90%;Uber 已为常用 MCP 服务部署 25 个以上预制 code-mode Skill。
5. Context Graph 先给正确入口,再让 Agent 行动
没有组织背景的 Agent 往往失败得很慢。它找不到服务所有者、数据表、历史 PR 或事故记录时,会继续搜索仓库、打开文档、启动 Sub-Agent、重试工具;每条错误分支都会增加请求,也会让下一轮携带更长历史。
Uber 的 AI Context Graph 连接 30 多个内部系统,包含 2,400 万节点、8,000 万条边、86 种节点和 117 种边类型,覆盖服务、团队、事故、PR、架构文档、部署、数据集和历史表使用记录。
同一道内部问题、同一个模型的对照中,有 Context Graph 的 Agent 调用 4 次工具,用 38 秒找到一张被 50 多名分析师使用的正确数据表;没有 Graph 的 Agent 花了 20 分 09 秒,启动 2 个 Sub-Agent、遇到 3 次错误,最后错误地判断数据无法查询。

这是单题内部案例,不能外推成所有任务都能获得相同倍数加速。它揭示的机制很稳定:高质量背景会同时减少搜索请求、错误分支、等待时间和返工。
小团队不需要先复制一张数千万节点的图。可以从最常见的查找失败开始:服务目录、代码所有者、历史 PR、事故记录、常用数据表、告警和部署记录。目标是让 Agent 在开始盲搜之前获得正确入口。
从实时成本到托管维护:让反馈回到系统
软件工厂有两条反馈回路。第一条处理一次会话如何减少浪费;第二条处理一种自动化如何在长期运行中改进。
会话反馈:浪费发生时就让工程师看见
Uber 在终端状态栏持续显示 Token、上下文占用、当前 session 成本和推理强度。所有交互 Harness 共用一个预算层级,托管 Agent 使用独立层级;达到预期支出的 50%、80% 和 100% 时,通过 Slack 提醒,超出层级需要经理审批。
状态栏让工程师在会话进行中判断是否应该换模型、压缩上下文、拆分任务或停止错误搜索,而不是等月底才看到汇总账单。
session 分析看板进一步读取本地与云沙箱 trace,识别 16 类浪费反模式:
- 简单多轮任务使用过重模型;
- 40KB MCP 响应留在历史中,被后续请求重复计费;
- 长时间后恢复旧会话,缓存已经过期;
- 用户尚未输入任务,就预载 100,000 Token 系统说明和工具定义。

诊断不只教育个人。相同问题反复出现时,平台团队会修改默认模型、TTL、Skill、工具网关或上下文供给,让下一批会话从更好的默认值开始。
维护反馈:自动化循环必须有统一调度和结果标签
功能合并后,软件工厂仍然要处理 Feature Flag 清理、依赖升级和周期性维护。Uber 允许服务加入维护 Skill,但不允许每个团队随意启动一个永久 Agent 循环。
周期任务进入统一 managed loop。平台可以把维护安排在 CI 容量较空的周日,并限制周一早上发送给工程师的自动 PR 数量。这解决了两个现实问题:后台 Agent 不能无限争抢构建资源,也不能用大量低优先级 diff 淹没工程师。
维护 Skill 生成的 diff 会收到评论、被合并或被拒绝。这些结果构成真实标签数据,反馈给 Skill 的评测和改进。Uber 还计划大约每月从事故复盘中提取可重复的修复模式,将它们转成新的维护 Skill,再应用到更多服务。
这样形成一条闭环:事故暴露模式,团队把模式编码为 Skill,托管循环执行 Skill,PR 结果生成标签,标签继续改进 Skill。自动化不依赖一次完美 Prompt,而是在受控运行中积累组织经验。
人工审核负责目标和例外
全托管仍然需要明确的人类责任。人决定任务是否值得做、需求是否合理、风险是否可接受,并处理 Agent 无法可靠判断的异常。
平台承担重复执行、环境准备、证据收集和常见修复;人类把注意力从逐步操作转向目标、验收和边界。PR 检查表、截图、成本 trace 和 Skill 运行记录,都是这种责任分工所需的证据。
新瓶颈与落地指南:从写得更快走向系统吞吐
当 Agent 生成更多代码,原有工程系统会承受新的压力。
第一项是 CI 容量。自动 diff 增长后,构建、测试和模拟器资源可能先耗尽,因此 Uber 把验证前移,并按容量调度维护任务。
第二项是 实验容量。产品能够快速生成更多方案,但用户流量、实验周期和统计资源有限,团队不可能同时运行无限个 A/B 测试。
第三项是 决策能力。实现成本下降后,组织更容易回答“能不能做”,却仍然需要判断“应不应该做”。业务价值、风险、用户体验和战略优先级不会因为代码生成加速而自动解决。
Uber 的实践可以整理成一条分阶段建设路线。
第一步:先修建可重复的工程地基
统一代码组织、构建、测试、依赖和远程开发环境。Agent 如果无法稳定复现工程师的构建过程,后面的自主运行只会放大环境问题。
第二步:收束模型和工具入口
所有模型调用经过统一网关,获得身份、项目、团队和成本归因;内部 API 与 SaaS 通过 MCP Gateway 统一认证和策略。没有控制平面时,预算、审计和模型路由都会碎片化。
第三步:从一个可测量结果开始
选择代码评审、依赖升级、测试生成、Feature Flag 清理或告警分诊等边界清楚的工作。定义结果单位和质量线:每次 review、每个合并 PR、每个 alert,同时绑定 F1、回滚率、MTTR 或人工验收。
第四步:先 Skill 化,再托管化
把任务输入、步骤、工具和验收方式固化成 Skill,在市场中治理质量和版本。只有重复、边界稳定、结果可验收的流程,才适合升级成自动触发的专用 Agent。
第五步:为 Agent 准备环境和上下文
预启动隔离环境,准备代码快照、搜索索引和跨仓库能力;把服务归属、历史 PR、事故和数据目录连接起来。Agent 获得任务时应当先拿到正确入口,而不是自己花十轮猜测组织结构。
第六步:把验证前移,并交付证据
在占用完整 CI 之前运行静态检查、模拟器、视觉对照和前后端集成。PR 不只包含代码,还应包含检查表、截图和已运行步骤,让人类能够高效验收。
第七步:写出六项成本公式
把用户、会话、轮次、请求、Token 和模型单价分开统计。检查历史、系统说明、工具 Schema、轮询响应和大结果;能按需加载的不要预载,能在脚本里循环的不要让模型参与轮询。
第八步:用真实任务持续选择模型
建立带已知答案和失败模式的 benchmark,记录质量、延迟、超时、噪声和实际成本。主 Agent、Sub-Agent、inner-loop review 和 outer-loop review 可以采用不同模型,但每种路由都要以结果质量为前提。
第九步:集中管理长期循环
周期性维护必须受预算、CI 容量、任务频率和 PR 数量限制。把评论、合并、拒绝和事故复盘变成改进 Skill 的数据,而不是让每个团队维护一个不可观察的定时 Agent。
第十步:重新管理组织瓶颈
持续观察 CI 队列、实验容量和评审负担。代码生成速度提升后,投资重点需要转向验证基础设施、产品决策和优先级管理。
Uber 能够同时扩大 Agent 吞吐和压低单位成本,靠的是把软件开发改造成一套可测量的生产系统:模型、工具、环境、Skill、知识和产品入口都有统一控制;任务从需求到维护拥有明确交接;每个 Agent 都有结果指标和评测集;每次浪费和失败最终又回到平台默认值与 Skill 改进中。
请求增长 9.4 倍而总支出相对稳定,是这套系统运行后的财务结果。更深的变化是,工程师不再需要亲自完成每个机械步骤,但组织必须更清楚地定义什么值得做、什么算完成、哪些风险只能由人判断。
Uber 软件工厂:Agent 吞吐与成本控制
六块平台底座承接 Agentic SDLC;六乘数成本机器逐层挤掉无效搜索、工具目录、轮询与冗余上下文。
请求增长 9.4 倍,单位成本却向下
周活 7×,周请求 9.4×。
70%+ PR;3,600+ Skill;日执行 30,000+。
固定模型:千次请求 −34%,单会话 −52%。
Uber 自报;70% PR 有 Agent 参与,不等于 70% 代码无人生成。
六块底座,把模型调用变成可治理的任务执行
身份、隐私、策略、计量与审计。
内部 API 与 SaaS 工具按需发现。
预热、隔离、跨仓库执行环境。
流程发现、安装、评测与版本治理。
连接服务、团队、数据、事故与 PR。
统一进入 Slack、CLI 与 Web。
交付物不只是代码,而是“代码 + 验证证据”
先补齐历史、范围、实验与验收条件。
Figma + 代码上下文交给 Minion。
截图、视觉、静态与联调先行,保护 CI。
CI、深评审后,代码连同证据交给人。
验证前移,让 CI 与人类注意力处理更成熟的候选。
总成本 = 用户 × 会话 × 轮次 × 请求 × Token × 单价
真实任务评测;主 Agent 强,子任务便宜。
Medium;400K 压缩;主线程 1h TTL。
工具按需载入;脚本包住轮询与大结果。
4 次调用、38 秒命中;无图谱 20:09 且误判。
优化每个合格结果的成本,而非只盯 token 单价。
先建可复现底座,再扩大 Agent 自主范围
统一代码、构建、测试与远程环境。
集中模型、工具、身份、预算与审计。
先选边界清楚、可回退、可度量的任务。
先固定流程与验收,再升级为托管 Agent。
结果写回评测;监控 CI、实验与评审负荷。
Agent 请求涨了 9.4 倍,为什么账单没有一起失控?
林舟流量接近十倍,不能靠等模型降价来救账单。
规模增长本身是目标;需要压缩的是完成任务之外的无效轮次、请求和上下文。
林舟先把共同能力做成平台,Agent 才能被托管。
统一控制面让每个请求都能归因、计量、审计,并在可复现环境中执行。
林舟别只盯单价;每次无效请求都会把历史再带一遍。
Uber 优先优化轮次、请求和每次请求的 Token,再用真实任务评测决定模型路由。
绿色Agent小车给我正确入口,我就不用一边猜一边烧 Token。
同一内部问题中,带图谱的 Agent 4 次调用、38 秒找到正确表;无图谱版本耗时 20 分 9 秒并误判。
林舟人不必重演每一步,但必须看见你验证过什么。
验证前移减少不成熟 diff 对 CI 的占用;人类继续负责需求、风险和异常判断。
林舟软件工厂不是一次部署,而是一套会从结果中继续变好的系统。
Uber 把运行轨迹、成本、质量和人工结果写回默认模型、Skill 与调度策略,让下一轮任务使用更好的默认值。
We just published a deep dive on how we keep AI coding costs under control at Uber, even as usage keeps climbing. Since February, weekly active employees across all functions on our agentic offerings grew 7x, and weekly agent requests grew 9.4x. Over that same stretch, total spend has relatively stabilized. We broke total spend into an equation: users, sessions per user, turns per session, requests per turn, tokens per request, price per token, and treated each term as something we could measure and shrink on its own. A few examples: benchmark-driven model selection instead of a single fixed default, prompt-cache lifetimes matched to how long engineers actually pause mid-session, MCP tools resolved through a CLI instead of preloaded into every session's context, and a session dashboard that automatically flags more than a dozen categories of wasted spend.
Introduction
AI tools are now embedded in every phase of software development at Uber. More than 70% of pull requests are attributed to local or cloud agents. Engineers have built over 3,600 agent skills across the software development life cycle, and executed more than 30K agent skill executions per day.
At the AI Engineer 2026 conference, we shared our vision for the Software Factory and the building blocks and managed agents we are building across the lifecycle. As we progress on that vision, a growing share of sessions aren’t initiated by humans, but by automated managed agents handling code review, self-healing CI failures, completing E2E PRs with visual validation, triaging on-call alerts, debugging incoming bugs, and handling a variety of code maintenance tasks with human reviews/escalations.
As shown in Figure 1, from February to Aug 2026, weekly active users across all agentic offerings across all our employees (engineers & non-engineers) grew 7x, and weekly agentic requests grew 9.4x. Meanwhile, our total AI spend has relatively stabilized since April due to optimizations across the board.
Figure 1: Weekly active users, agent requests, and cost from Feb–Mid Aug 2026, with users deduplicated across tools.
Since adoption, workload mix, and model upgrades are all continuously changing, isolating our own optimization gains means holding one model fixed, since behavior shifts with every upgrade and model family. We did that from February to July: cost per 1,000 model requests is down almost 34% from its peak, and cost per session is down 52% from its June peak.
Figure 2: Cost optimization impact with model held constant. *Cost/session data starts from end of May.
This blog walks through how we think about our software factory: the four layers agent sessions run in, the cost equation we use to decompose spend, how we measure each term, and how we optimize those terms across every layer.
All pricing and vendor metrics in this comparison are based on publicly available information, with cost efficiency gains driven by routing our internal Uber workloads more intelligently within standard tier-pricing. While specific cost reductions we measure are unique to our environment and your mileage may vary depending on your codebase, team size, and agent workflows, the methodology of benchmarking real work and optimizing for accuracy and cost is universally applicable.
The Software Factory and Its Cost Equation
Four Layers of Agent Usage
We organize AI usage into four layers, from the most specialized to the most general. As shown in Figure 3, the higher the layer, the more control we have over cost, quality, and model selection.
Figure 3: The four layers where agent sessions run. The Cost Equation
Across any of the layers above, we can decompose the cost of an agentic session into the following terms, which we could measure and optimize independently.
Figure 4: Total spend, decomposed into six terms that multiply.
The first two terms represent adoption & engagement, which we want to keep growing across our overall user base, whether users use it interactively or agents handle tasks on their behalf. The three middle terms provide opportunities for optimization: the work the agent does on its own behalf, on top of the request an engineer actually made. That is where most of our effort goes. This includes mechanisms that help agents plan faster, reduce unwanted turns or errors, optimize input tokens, and more.
How We Measure
Below is the full set of metrics we track weekly and monthly that enable us to forecast & plan our efforts short-term and long-term.
| Layer | Metrics | What it answers |
|---|---|---|
| Portfolio | Total attributed cost Distinct attributed usersPer-tool/agent cost, users, and spend share | Where the money is going, and which tool moved |
| Unit economics, per tool | Cost per userRequests per userCost per 1,000 requestsInput, output, and total tokens per requestCost per 1 million tokensCost per 1,000 sessionsCost per active session hourPrompt Cache hit rate | Whether the tool is getting cheaper or usage is just shifting |
| Model economics | For every modelCost and cost shareRequests and request shareCost per 1,000 requestsCost per 1 million tokens | Which model releases actually changed the bill, at identical or different per-token prices |
| Driver decomposition | Cost change decomposed sequentially intoadoption (users)engagement (requests per user)input workload (input tokens per request)output workload (output tokens per request) | Why the number moved, stated exactly, with nothing left in an unexplained residual |
| Managed agent outcomes | For each managed agent: Outcome-denominated cost (cost per merged PR, cost per review, cost per alert, cost per cleanup);Quality signal (revert rate, F1, MTTR);Volume (diffs landed, reviews posted, alerts triaged) | Whether each managed agent is getting cheaper per unit of value delivered, and whether quality holds through model migrations |
Optimization Levers
In the following sections, we detail the key levers we used to optimize each part of the cost equation. Some of these levers affect one or more rows in the cost equation.
| Price / Token | Benchmark-driven, Pareto-optimal model selectionModel defaults |
|---|---|
| Tokens / Request | 400K context cap & Medium reasoning effort by defaultPrompt CachingTool search and CLI-resolved MCP callsCode-mode batching of tool callsGateway-routed SaaS MCPs |
| Requests / Turn | Graph-grounded contextContinuous Skill Optimization |
| Visibility & Education | Live cost counter in the status lineVisibility and spend tiersSession analysis dashboard |
Optimizing Price / Token
The vendor sets the token price. We pick which model runs which workload. Across all our managed agents’ layers, we pick the model that’s most Pareto efficient for that workload. For us, Pareto efficient means cost/completed task, output quality, and model reliability.
Benchmark-Driven Model Selection
Model selection happens in four steps, the same for every managed agent we run.
- Build a benchmark out of the agent’s real work.
- Run the agent on a harness that serves any model, frontier or open-weight, behind one interface.
- Move to whatever is Pareto optimal, and keep moving. The frontier shifts every few weeks.
Looking ahead, we continually refine our workload performance by leveraging aggregated insights from our managed agents to test and deploy various model routing strategies.
For example, we use uReview, which handles AI code review for all pull requests. We built its benchmark from real pull requests with known bugs and graded them easy, medium, and hard. We score precision, recall, and F1 against those bugs, plus cost per review, latency, timeouts, and noise. As shown in Figure 5, switching models improved our F1 while dramatically reducing cost/PR. In the figure, the dashed line is the Pareto frontier. Everything below and left of it is beaten by something cheaper or better.
Figure 5: Every configuration we tested for uReview.
Using thousands of real-world PRs across our large monorepos, we internally also have an Uber SWE Benchmark that runs frontier and open-weight models across different task types. We use it to inform model selection across all our SDLC-managed agents.
Default Model Selection
In the interactive interface, token unit costs remain fixed; however, you can strategically manage token distribution across models. Two default settings primarily govern this distribution: the initial session model and the subagent model.
The subagent default setting has proven to be the most impactful lever, and its significance continues to grow. The proportion of sessions initiating subagents has steadily increased as the latest model capabilities enable more effective multi-agent orchestration. Because subagents perform well-defined tasks with specified inputs that often do not require frontier-level reasoning, we default them to a weaker, more cost-effective model while still allowing manual overrides. The primary model handles task decomposition and evaluation while subagents execute the work.
Optimizing Tokens / Request
Every turn re-sends the full conversation history, project context, and tool results. Anything that reduces the per-request payload compounds across the session.
Defaults
All interactive harnesses use a unified wrapper for installation management, configuration, authentication, and cost visibility. Two standardized default configurations directly reduce token consumption per request:
- Automatic compaction is triggered at 400k tokens even for 1M context window models: This threshold balances model performance against cache bursts and repeated input token costs. Our measurements show a meaningful reduction in fleet-wide input tokens per request.
- Reasoning effort defaulted to Medium: Output tokens, including internal reasoning tokens, are billed at multiples of the rate of input tokens on primary models; this policy adjustment directly reduces spend in the highest-cost token category. For a large category of tasks, Medium reasoning hits a good balance between cost vs quality.
Prompt Caching Strategy
Our prompt caching strategy is driven by the economics of provider prompt cache reads and writes. Since each turn re-transmits the full conversation history, caching the preceding context avoids paying the full cost repeatedly, reducing subsequent reads to just 0.1x the standard input token rate. However, write premiums vary: 5-minute cache entries cost 1.25x, while 1-hour entries cost 2x. Choosing an optimal TTL (Time-to-Live) therefore depends on the duration of gaps between turns. Available TTL options include 5 minutes and 1 hour from Anthropic®, alongside 30 minutes from OpenAI®.
Figure 6: A comparison of 5 turns under both TTL durations.
Because engineers often leave interactive sessions idle for more than 5 minutes, we transitioned from the default 5-minute TTL to a 1-hour window. These frequent idle gaps previously invalidated the prefix cache, forcing costly full-price context rebuilds. Sub-agents, by contrast, retain a 5-minute cache TTL because their execution focus is limited to single, short-lived tasks.
Executing MCP Tools via the Shell
At Uber, all MCP (Model Context Protocol) interactions are routed through a unified gateway. This single entry point encompasses more than 1,000 MCP servers across internal and third-party SaaS MCP, enabling centralized authentication and policy enforcement.
However, standard MCP loads all tool schemas directly into every session, regardless of whether an engineer will ever invoke them in that session or not. For example, with over 100 tools installed, this pre-loading added approximately 50K-70K tokens of schema overhead to the initial prompt, which was subsequently re-sent on every context turn.
Figure 7: What an agent is already carrying at the start of a session, under 3 ways of reaching the same tools.
To address this context bloat, we introduced two complementary optimization mechanisms:
- CLI tool resolution: Replaces direct MCP integration by allowing the model to execute a shell command. The CLI resolves and invokes the required tool against the gateway dynamically at call time, eliminating Uber MCP schemas from the session context. All 1K+ MCP tools from our internal MCP gateway are projected as CLI commands.
- Tool search: Scales to thousands of tools by allowing the model to search the tool catalog and load only required tools on demand. This approach mitigates context bloat, typically reducing token usage for tool definitions, and maintains high selection accuracy even as the available tool library expands, preventing degradation associated with large tool sets.
Code-Mode
When tools call functions directly as shell commands, models can batch multiple actions within a single script. This batching is particularly advantageous for chatty tool protocols. Under standard MCP workflows, each action requires a separate model turn to emit a request, load the raw response into the context window, and process the results sequentially. For instance, executing a single SQL query requires submitting the request, polling status 2 to 5 times, and retrieving the output. Code-mode streamlines this entire flow into an automated Python loop, keeping intermediate polling out of the model’s active context. As shown in Figure 8 on the left, the model participates in the polling loop, and every response lands in its context. On the right, the loop runs in a subprocess, and only the summary comes back.
Figure 8: The same warehouse query, both ways.
We measured this by running 5 identical SQL queries through both paths in the same session:
| Query | LLM tool-use | Code-mode | Savings |
|---|---|---|---|
| SELECT 1 (1 row) | 903 | 402 | 55% |
| COUNT(*) (1 row) | 954 | 403 | 58% |
| GROUP BY LIMIT 20 (20 rows) | 1,600 | 457 | 71% |
| SHOW COLUMNS (175 rows) | 2,200 | 900 | 59% |
| SELECT * wide table (50 rows) | 1,431,594 | 900 | ~100% |
| Tokens per query, measured in the same Claude Code session. |
The initial three rows highlight the main finding: even for minimal result sets far below response-size limits, code-mode reduces token usage by more than 50%. Rather than bypassing large data payloads, these efficiencies stem from eliminating unnecessary overhead, including schema initialization, multi-turn polling, and redundant step-by-step reasoning.
Bulk workflows compound the effect, because the loop that would have been N model turns becomes one script and the savings compound to more than 90%. By deploying more than 25 pre-built code-mode skills for our most-accessed MCP servers, we ensure standard workflows default to the most cost-effective path.
SaaS MCPs
Managing third-party software proved significantly more challenging than our internal servers. Vendors design MCP servers to expose full product capabilities because they can't anticipate specific customer usage. For instance, a workspace suite bundles 49 tools into a single server, requiring ~22K tokens of schema, while messaging and project tracking vendors ship 34 and 46 tools, respectively. Loading two or three vendor servers makes the agent carry more schema overhead than the file being edited before a user even enters a prompt.
To address this, we route SaaS MCP servers through our MCP gateway using the same mechanism we do for our internal MCPs. We also expose all these MCPs as CLIs that any agentic surface can invoke. Additionally, we author dedicated skills within our code-mode plugin for each server to encapsulate common workflows. This unlocked efficient agentic workflows across many SaaS vendors.
Figure 9: Every SaaS MCP server is exposed behind our MCP gateway to ensure a unified, efficient access pattern. Optimizing Requests / Turn
An ungrounded agent fails slowly rather than cheaply, repeatedly sending an expanding context window to search one more location. Providing richer information upfront remains the single most powerful lever to reduce this search overhead.
Context Engineering
Across Uber’s vast codebase and data ecosystem, comprising hundreds of millions of code lines and thousands of tables, agents spend most of their turns locating information rather than generating code. To address this, we engineered the AI Context Graph: a unified network containing 24 million nodes and 80 million edges across 86 nodes and 117 edge types. It integrates data from over 30 internal systems, including services, engineering teams, incident logs, pull requests, architectural design docs, deployments, datasets, and historical table usage queries, and lets any agent query it in natural language.
Figure 10: Comparing execution paths for the identical prompt submitted to the same model, with and without graph grounding.
The grounded agent queried historical usage, identified the specific table used by over 50 analysts, and delivered the answer in 38 seconds. Conversely, the ungrounded agent lacked visibility into that table; it spent 20 minutes inspecting service code, spawning 2 subagents, and hitting 3 errors before incorrectly concluding the dataset was unqueryable.
Visibility & Education
The levers here are visibility and feedback loops that help engineers and agents converge faster.
The Status Line
We put a live cost counter in the harness status line that tracks live spend per harness and across all harnesses for each user.
Figure 11: The status line, with the session analyzer and efficiency guide that ship alongside it.Visibility and Spend Tiers
To avoid imposing strict caps, we implemented real-time spend tracking and automated nudges:
- Statusline live counter. Running session cost is always visible in the terminal.
- Harness pool. One shared tier across all interactive harnesses, not per-tool budgets. And separate tiers for managed agents.
- Slack nudges. Alerts at 50/80/100% of expected spend so engineers have time to plan.
- Easy approval flows. Manager sign-off for tier upgrades with quick propagation.
- Cost check skill and tips. A dashboard skill for on-demand cost breakdown and live status line coaching.
These enable engineers to evaluate task ROI independently while mitigating runaway expenses.
Session Analysis Dashboard
While the status line highlights a session's total expenditure, it lacks visibility into cost drivers or actionable efficiency steps. General guidance provides high-level principles, but can’t evaluate individual developer workflows. The session analysis dashboard bridges this gap by inspecting session artifacts directly.
Built directly into the runtime, it requires zero setup or opt-in. Executing the cost dashboard skill analyzes all session traces for the user across local and remote cloud sandboxes across all harnesses they use. Rather than producing an aggregate metric, it flags 16 distinct anti-patterns across sessions, pairing each with its financial impact and a targeted remediation. Some of the categories include:
- Suboptimal model routing: Executing simple multi-turn sessions on Opus that Sonnet could easily fulfill.
- Context window bloat: Large MCP payloads (for example, 40KB responses) persisting in context and incurring repeated billing on subsequent turns.
- Cache expiration inefficiencies: Resuming sessions after extended breaks where expired prompt caches force full-price prefix rebuilds.
- Prompt initialization overhead: Pre-loading 100,000 tokens of system instructions and tool definitions before any user input is provided.
Figure 12: Session-level cost dashboard identifies waste patterns and potential savings.. What’s Next?
Current initiatives in progress include:
- Growing the fleet of managed agents: For every new agent, we follow a consistent roadmap: establish target outcome metrics, assemble evaluation benchmarks, and identify a Pareto-optimal model. This systematic approach aims to elevate each stage of the SDLC higher up the factory maturity model.
- Dynamic Model Routing: We’re expanding benchmark coverage across diverse programming languages, code repositories, and agent modalities. Effective model routing relies heavily on comprehensive evaluation, given that model capabilities vary widely.
- Deepening context-graph integration: We’re unlocking graph query capabilities across a wider selection of autonomous agents.
- Evolving session analytics into real-time developer guidance: By shifting from periodic batch detection of anti-patterns to continuous trace monitoring, we aim to deliver personalized, real-time efficiency recommendations directly to engineers.
- Continuous Skill Improvement: We are working on an automated way to record papercuts from agent skill executions and auto-generate skill updates from the collected traces.
Conclusion
Managing and curbing rising AI coding expenses is also a tractable engineering challenge. By eliminating wasted, zero-value token consumption rather than relying solely on lower unit prices or downgrading tooling, we scaled usage 7x while simultaneously reducing unit costs across all metrics and improving/maintaining output quality.
The core strategic shift is moving from interactive developer workflows to fully managed agents. Transitioning SDLC workloads into managed environments grants complete control over model routing, execution harnesses, and operational spend. Optimizing a fleet of specialized managed agents, each paired with dedicated evaluation benchmarks and a Pareto-efficient model, is inherently more cost-effective and scalable than optimizing individual terminal sessions across thousands of engineers.
Acknowledgments
This is a collective effort by many engineers who are building the most efficient blocks to implement Software Factory at Uber scale, while ensuring we get ROI for every token we spend. We would like to thank our core team involved in various efforts across Software Factory listed here: Abhishek Bhatia, Adam Huda, Aditya Patel, Alok Srivastava, Ameya Ketkar, Anil Purohit, Atakan Kandemir, Ben Chou, Brandon Barker, Danielle Yim, Deepanshu Mehndiratta, Gaurav Gill, Israel Marban, Jason Varbedian, Karen Xu, Lei Shi, Mager Mager, Meghana Somasundara, Peng Liu, Preet Inder, Qiushen Wang, Rush Tehrani, Shesh Patel, Shiven Tripathi, Shubham Gupta, Stas Khalup, Ting Chen, Tse-Shi Wang, Ty Smith, Vikram Hullukunte, Viv Keswani, Weiqiang Wang, Will Bond.
Also would like to thank Johannes Gehrke, Mattie Toia, Sumanth Sukumar, and Praveen Neppalli Naga for their leadership.
Cover Photo Attribution: Himer Romana
Anthropic® is a registered trademark of Anthropic PBC.
Claude Code™ and Claude® are trademarks of Anthropic, PBC.
OpenAI® and its logos are registered trademarks of OpenAI®.