Google 开源多模态向量模型 EmbeddingGemma 2:用自然语言搜索文字、图片、声音和视频
Google 把文字、代码、图像、视频和音频放进同一个检索空间。理解它如何找资料,以及模型内存、输入预算和向量压缩之间的取舍。
手机里存着相册、会议录音和视频,想找其中一段内容,却未必记得文件名。要按内容来搜索,需要一类模型——嵌入模型(Embedding Model,负责把文字、图片、声音等现实内容压缩成高维数学向量,让计算机能够比对语义相似度的算法)。上一代纯文本小模型发布后,已累计超过 2,000 万次下载,能够处理文本资料;新一代进一步扩展到图片、录音和视频。
Google DeepMind 针对端侧设备推出了全新的开源多模态嵌入模型 EmbeddingGemma 2。它基于 Gemma 4 架构打造,采用允许商业使用的 Apache 2.0 许可证,不仅将上下文扩大四倍至 8,192 个 token,并在 7.4 亿(740M)的总参数下,把文本、代码、图像、视频和音频全部收纳进同一个 768 维的向量空间中。借助可拆卸的模块化设计与俄罗斯套娃式的向量截断技术,它可以按任务只加载必要的编码器,并让开发者用较短的向量换取更低的存储占用。
同一句搜索,怎样找到文字、图片和声音
一种常见的本地搜索或私有 RAG(检索增强生成,即先检索相关资料,再交给生成模型作答)系统做法是先把不同格式转换成文字:想在相册里搜一段视频,系统得先调用语音识别模型把视频里的对话转成文字,再调用图像识别模型生成标签,最后用文本嵌入模型去比对。这会增加处理步骤,也可能丢失难以用简短文字描述的信息——比如海浪的背景声、吉他的和弦,或是视频中某个特定运镜的画面感。
EmbeddingGemma 2 的本质突破在于原生多模态对齐。它让文本、图像、视频与音频在训练时就共享同一个 768 维的数学空间。例如在官方演示视频中,一张猫的照片、文本“cat”以及一段猫叫声,在编码后都会被映射到这个共享高维空间中彼此临近的位置;正因为不同模态的内容被投射到了同一个向量空间,系统可以直接通过计算几何距离或余弦相似度来比对它们的相关性,而无须先把声音或画面转译成文字。
查询与资料即使格式不同,也可以直接比较语义相似度。在具体落地中,这一过程包含清晰的分步机制:
- 资料预先编码与建库:本地相册中的照片、视频片段或录音资料,预先经由 EmbeddingGemma 2 编码提取为 768 维向量,并存入端侧向量索引库。
- 查询实时编码:系统将查询编码为同一空间的向量。比如,录下一句“找海边日落的视频”,可以把这段语音直接转换成向量,与视频片段的向量比较。这是帮助理解流程的示例。
- 同空间相似度比对取回:在统一向量空间中计算查询向量与各资料向量的相似度,按得分高低排序并取回候选原始资料。
- 若需生成再交大模型:如果仅是检索定位,直接向用户呈现候选原件;若应用需要进一步归纳、问答或推理,再把检索到的候选内容送入端侧 Gemma 4 等生成式模型作答。
同一套表征也能用于分类与聚类。分类是把输入向量与预设类别向量比较,选出更接近的一类;Google 的 MediaPipe Decision Task API 小游戏演示,就根据多模态输入,在 JUMP、DUCK、SPRINT 等预设动作中做选择。(分别是跳跃、下蹲和冲刺)聚类则不先指定类别,而是把向量位置相近的资料分成一组,便于组织不同格式的内容。
EmbeddingGemma 2 输出的是数字表征。检索出的内容是否能回答问题,仍需要后续处理;当这些步骤都在设备上运行时,整套向量提取与比对全部在本地芯片上执行,相册与录音不需要上传到任何云端服务器,减少了网络往返,也让原始资料留在设备上。
只搜文字时,为什么不用加载整个模型
只需要搜索文字或代码的应用,无须把图像和音频组件一起放进内存。EmbeddingGemma 2 采用模块化架构:
整个模型由 24 层 Transformer 构成,内部维度为 512,再通过投影层输出标准的 768 维向量。其 7.4 亿(740M)的总参数可按任务选择加载:
- 文本骨干(270M 参数):由 1.3 亿参数的 Transformer 主干网络与 1.4 亿参数的嵌入层组成,负责所有多语言文本与代码的解析。
- 视觉编码器(170M 参数):专门负责解析静态图片与视频抽帧。
- 音频编码器(300M 参数):专门负责解析多语言语音与各类环境声音。
加载哪些部分,取决于应用要处理哪些资料:
- 纯文本/代码任务(Text only):在 Sentence-Transformers 等框架中通过配置直接把视觉和音频编码器置为空,此时模型只加载 270M 参数。Google 给出的 Pixel 11 Pro 量化结果中,文本权重的活动 RAM 占用低至约 191 MB。
- 图文检索任务(Text + Vision):关闭音频组件,组合参数量仅为 440M。
- 文本+音频任务(Text + Audio):关闭视觉编码器,组合参数量为 570M;在只需要处理语音或环境声音、不需要视觉检索的场景下,可以不加载视觉编码器。
- 视听全开(Full Multimodal):挂载全部组件,参数量达 740M。同一手机上量化后,全模态模型权重的活动 RAM 占用低至约 567 MB。这两个数不包含整个应用、检索索引和生成模型的全部开销。
此外,由于 EmbeddingGemma 2 源自 Gemma 4 架构,它与 Gemma 4 生成式模型共享了相同的文本分词器与音频编码器。这意味着如果开发者在手机端搭建一套完整的端侧 RAG 流程(由 EmbeddingGemma 2 负责找资料,Gemma 4 负责总结作答),两个模型在内存中可以共享部分通用底层权重,有助于降低组合运行时的内存占用。
8K 是共同预算,混合输入要一起算
上一代纯文本模型的上下文窗口只有 2,048(2K)个 token,面对长篇技术文档或多轮对话常常不得不切得很碎。EmbeddingGemma 2 将上下文直接拉长 4 倍,达到了 8,192(8K)个 token。
值得注意的是,这 8,192 个 token 是所有模态共享的统一度量池。模型定义了一套清晰的模态换算标准:
- 文字与代码:按照常规的分词机制,大约 1 个 subword(子词,分词器拆分的最小语义单元)消耗 1 个 token。如果只输文字,最多可达 8,192 个 token。
- 音频信号:要求提供 16 kHz 单声道(mono)音频,消耗速率为固定的 每秒 25 个 token。在纯音频状态下,8K 窗口足以直接塞进长达 327 秒(约 5.5 分钟) 的连续音频。
- 视频信号:默认采用 1 fps(每秒抽 1 帧)的采样率,每帧视频画面默认消耗 140 个 token,单次最多可输入 约 58 帧(即约 58 秒连续抽帧视频)。
- 静态图像:单张图片默认消耗 280 个 token,单次最多可容纳 约 29 张图片。
这些上限分别按单一模态计算。文字、图片、视频和音频混合输入时,会一起消耗这 8K 预算,不能同时装满各自的上限。这也厘清了在长音频库中检索与单次 8K 编码上限的关系:要实现介绍中的“从数小时录音里找内容”,可以先把长录音切成适合上下文的片段,分别建立索引,再按查询取回相关片段。这和一次编码整段录音是两回事。
更为灵活的是,官方还提供了视觉软 Token 弹性预算调节机制:开发者可以根据任务需要,把每张图片或视频帧占用的 token 数量在 70 到 1,120 个软 token 之间自由调节。如果面对的是对细节要求不高的普通分类,降到 70 个 token 后,单次甚至能塞入多达约 114 张图片或视频帧;若面对的是精细电路图、复杂工程图表等视觉文档,则可以拉大 token 配额,用稍多一点的计算资源换取更细的视觉表达。
不仅如此,EmbeddingGemma 2 支持真正的多模态自由交错输入。在一段输入文本中,你可以随时使用 <|image|>、<|video|> 和 <|audio|> 占位符。例如对一件在售跑鞋进行建库索引时,输入可以写为:
emb = model.encode({
    "text": "越野防水跑鞋。<|image|> 采用透气网面设计。<|image|> 湿滑岩石抓地力实测:<|video|>",
    "image": ["shoe.jpg", "mesh.jpg"],
    "video": "demo.mp4",
})
模型会根据占位符的相对位置,把文字描述、两张局部特写图和一段实测小视频融合为一个完整的 768 维向量。用户随后用一句简单的自然语言搜索“湿岩石防滑鞋”,可以检索这条图文视频综合记录。
向量缩短以后,省下多少空间、损失多少质量
端侧设备不仅计算核心紧张,本地存储和内存更是寸土寸金。以往 768 维的浮点向量如果存储上百万条,对手机存储空间是极大的负担。
为此,EmbeddingGemma 2 原生集成了 MRL(Matryoshka Representation Learning,俄罗斯套娃表示学习) 技术。该技术在训练时优化损失,使得预设的多个前缀维度都成为可用的有效表征,但这并不保证向量的每一维按重要性严格排序。因此,开发者不需要重新训练模型,只需在导出向量时截取对应的前缀维度,就能把 768 维截断为 512 维、256 维甚至 128 维:
把向量缩短,省的是索引空间
选择维度,比较同样数量资料的存储占用与官方基准成绩。
10 万条、256 维:原始向量约 102.4 MB,为768 维的三分之一。
计算假设:每条资料一个向量,每维 float32 占 4 字节。MB = 条数 × 维度 × 4 ÷ 1,000,000;不含索引结构、原始文件及模型权重。
| 维度 | 向量体积 | 多语言文本 | 代码 | 多模态综合 |
|---|---|---|---|---|
| 768 | 100% | 61.36 | 78.68 | 59.01 |
| 512 | 66.7% | 61.17 | 77.24 | 58.38 |
| 256 | 33.3% | 60.41 | 76.18 | 56.24 |
| 128 | 16.7% | 57.89 | 71.41 | 45.65 |
128 维更适合文本用途,多模态综合成绩下降明显。不同列来自不同基准,不能横向当作同一量尺;成绩也不是你资料库的命中率。
从官方测试数据中可以提炼出非常清晰的工程选型法则:
- 256 维可以作为评估起点:相较于完整 768 维,256 维将向量存储体积缩至原来的三分之一,官方基准中的质量下降较小(多语言只从 61.36 降至 60.41,代码从 78.68 降至 76.18,音频也下降了约 0.48 分),但是否满足应用要求,仍要看实际资料的检索结果。
- 128 维慎用于多模态:虽然 128 维能把向量体积缩至原来的六分之一,文本和代码指标表现尚可,但在复杂的视觉和跨模态评测中(MMEB v2 从 59.01 剧烈跌至 45.65),信息损失非常明显。因此 128 维仅建议用于极度严苛的纯文本端侧场景,如果要在多模态中使用,必须经过严格的业务离线验证。
小模型的价值,要看质量与规模一起比较
Google 公布的评测显示,它以较小规模接近或超过部分更大的模型,但图中也有成绩更高的较大模型。这里的价值是有限资源下的质量,而不是每项指标都排第一:
- 代码检索有所提升:在 Google 公布的全精度 MTEB Code (v1) 代码基准上,EmbeddingGemma 2 取得了 78.68 的成绩(NDCG@10,衡量前十条检索结果的排序相关性),相较于第一代纯文本模型的 68.76 分,增加了 9.92 分(相对提升近 14%)。这些结果支持将它用于本地 IDE 的代码索引、语义化代码搜索以及端侧编程 Agent 的上下文召回。在博客附带的对比图表中,270M 文本核在代码检索上高于部分小模型(如 Qwen3 0.6B 的约 75.4 分),接近数倍于其体量的 8B 大模型水准(约 80.8 分)。(注:官方原图点位估读值约 76.7 分,与官方模型卡表格正式标注的 78.68 分存在出入,评测精确成绩应以模型卡列出的数据为准)

- 图像与文档理解表现抢眼:在 MIEB Lite 图像嵌入基准上取得 64.64 分,高于 jina-v5-omni-small(约 61.5),逼近 3B 规模的 LCO-Embedding-Omni-3B(约 65.7);在多模态视觉文档理解(MMEB v2 VisDoc)上更取得 67.84 的成绩,这项基准对应视觉文档检索,不能直接等同于整份报告的推理或问答能力。

- 音频表现高于图中若干专用模型:在 MAEB 音频基准测试中,模型取得了 49.39 分,在 MSEB 检索评测中取得 69.54 分。接近 30 亿参数体量的 e5-omni-3B(约 48.6),也高于图中若干音频专用模型(如 large_clap 的约 34.5、MuQ-MuLan 的约 28.4 以及 Qwen2-Audio-7B 的约 35 分)。(注:原图横轴将多模态点位标在约 670M 估读位置,且音频得分图上散点估读约 48.7,与模型卡精确值 49.39 略有差异,模型卡列出的参数规模为 740M、得分为 49.39)

- 多语言文本与前代接近:在覆盖超过 100 种语言的 MTEB multilingual (v2) 测试中,取得 61.36 分,与前代(61.15)基本持平,主要增量来自代码和新增的多模态支持。
接入前,先检查数值精度、归一化和任务前缀
在将 EmbeddingGemma 2 接入实际业务流水线时,有三处设置需要留意:
陷阱一:严禁使用 float16,必须使用 bfloat16 或 float32
EmbeddingGemma 2 的内部激活值范围超出了 float16 的动态表示范围。
如果使用 torch.float16 推理,模型可能返回 NaN(非数值)或质量下降的向量,而不明确报错。
- 正确做法:在支持硬件加速的环境中,必须选用
torch.bfloat16(它与 float32 的指数范围相同,每个数所需存储约为 float32 的一半);而在不支持原生 bfloat16 的环境(模型卡建议多数 CPU 使用 float32)中,必须回退使用torch.float32。
陷阱二:MRL 截断后必须重新做 L2 归一化
若用归一化向量的点积来计算余弦相似度,需要让向量长度为 1。当你用切片语法把 768 维切成 256 维时,截断后的前 256 个分量平方和显然不再等于 1。 如果你截断后忘记做 L2 归一化(L2 Normalization,即将向量除以其欧氏长度,使其模长重置为 1 的几何操作),后续用点积比对向量时,相似度计算可能不会报错,而是可能产生静默偏差——计算出表面看似合理、实则失真的相似度得分,导致排序质量悄然受损。官方模型卡推荐在调用时直接通过参数完成截断与归一化,以避免手动切片产生这一问题。
- 正确做法:直接在库调用中设置自动归一化参数,或手动执行归一化:
query_emb = model.encode(
    query,
    truncate_dim=256,          # 声明截断维度
    normalize_embeddings=True  # 强制要求截断后重新归一化!
)
同时注意:查询与底库的维度必须绝对一致。绝不能用 768 维的查询向量去检索 256 维的向量底库。
陷阱三:规范使用任务前缀,且不要给非文本输入加前缀
EmbeddingGemma 2 在训练中使用了简短的任务前缀。在输入文本前附带匹配任务的前缀,有助于提高质量。
- 非对称检索(Asymmetric,如文档检索、代码检索、问答):检索词与被检索内容的形态不同,应分别使用查询和资料前缀。
- 网页/文档检索:Query 格式为
task: search result | query: {query};被检索文档格式必须严格拼接标题:title: {title} | text: {content}(若无标题,写title: none | text: {content})。 - 代码搜索:查询可使用
prompt_name="CodeRetrieval",对应task: code retrieval | query: {query};代码文件设为title: {文件名或类名} | text: {代码}。
- 网页/文档检索:Query 格式为
- 对称比对(Symmetric,如句子相似度、文本分类、聚类):两边使用相同的指令前缀(例如
task: sentence similarity | query: {content})。 - 最关键原则:所有前缀指令仅对纯文本生效!图片、视频与音频请直接传入原始信号,绝对不要拼装任何文字指令前缀。
从体验应用到开发工具,如何开始试用
可以先从官方给出的参考应用了解多模态嵌入在端侧的具体用途:
- Google AI Edge Gallery(照片与视频定位):包含以文字或图像检索相册的 Instant Media Search,以及通过自然语言或语音定位视频特定时刻的 Video Moments Finder。在官方发布视频中,演示者以“吹蜡烛”搜索一段生日录像,返回的结果直接定位到视频时间轴上吹蜡烛的精确时间位置,而非整份视频文件,用户可以直接点击跳到该时刻播放。
- Google AI Edge Foresight(端侧多模态 RAG 串联):在演示中,应用在后台实时收听提问、对音频流编码,据此检索本地存储中的文本、图片和系统架构图,再由 Gemma 4 本地生成回答摘要,把“嵌入模型负责找资料”与“生成模型负责作答”实际串联起来,敏感数据无须离开设备。
- MediaPipe Decision Task API(预置分类与决策路由):利用输入表征与预设候选向量的相似度比对,为应用提供低延迟的实时意图分类与决策路由能力。
目前模型权重已在 Hugging Face 与 Kaggle 正式发布,Gemini Enterprise Agent Platform 的 Model Garden 也即将提供支持。
开发者可以按运行环境选择入口:
- 模型下载与端侧运行:权重已上线 Hugging Face 与 Kaggle,LiteRT Community 提供了经过端侧量化优化的专用版本。移动端开发者可以通过 Google AI Edge 提供的 MediaPipe 套件实现开箱即用的向量提取,也可以用 LiteRT(原 TensorFlow Lite)进行高度定制的模型内嵌;网页端则支持通过 transformers.js 与 WebGPU 纯前端本地跑。
- 服务端与本地工具箱:发布文章列出的工具包括 sentence-transformers、transformers、vLLM、SGLang,苹果生态的 MLX,以及面向个人开发者的 llama.cpp、Ollama 和 LMStudio;生成的向量可存入 Qdrant 等现代向量数据库;模型微调可遵循 Unsloth 提供的专项指导。
在 Google 完整发布视频中,官方还说明开发者可以通过微调来适配特定专业领域的词汇与资料(例如视频中提及的法律合同、医学影像或技术产品目录等)。微调的作用在于让模型更好地理解垂直领域的专门表征,在不增加模型规模的前提下提升检索精度;但视频中提及的法律和医学场景仅作为适用方向举例,使用时仍要以自己的资料评估检索效果。开发者可以参考 Unsloth 提供的微调指导,或通过 Gemma Cookbook 中的相关范例开始上手。
模型支持 100 多种语言,但不同语言的表现不一定相同;检索质量也取决于实际资料与任务。EmbeddingGemma 2 负责生成表征,应用仍需要处理检索结果的过滤与使用规则,并用自己的资料验证效果。
Google 开源多模态向量模型 EmbeddingGemma 2:用自然语言搜索文字、图片、声音和视频
手机里存着相册、录音和视频,想按内容搜索往往需要嵌入模型将现实世界的多媒体压缩为数学向量。一种常见的本地检索方案采用“级联转译”:先用语音模型转文字、图像模型打标签,再做文本向量比对。这会增加处理步骤,也可能遗失难以用文字形容的海浪背景声、吉他和弦或镜头画面感。
核心突破:原生多模态对齐
EmbeddingGemma 2 的本质突破在于原生多模态对齐。它让文本、图像、视频与音频在训练时就共享同一个 768 维的数学空间。正因为不同模态的内容被投射到了同一个向量空间,系统可以直接通过计算几何距离或余弦相似度来比对它们的相关性,而无须先把声音或画面转译成文字。
若编码和索引均在端侧执行,向量提取与比对可在设备本地运行,相册与录音无需上传云端服务器,让原始资料留在设备内并减少网络往返。
模块化架构:按任务裁剪内存占用
只需要搜索文字或代码的应用,无须把图像和音频组件一起放进内存。EmbeddingGemma 2 采用模块化架构:模型由 24 层 Transformer 构成,总参数 7.4 亿(740M),分为 270M 文本骨干、170M 视觉编码器与 300M 音频编码器三大独立模块:
上述 RAM 数据不包括应用、检索索引和生成模型的全部开销。
底层权重协同:由于继承自 Gemma 4 架构,模型与端侧生成模型 Gemma 4 共享了文本分词器与音频编码器底座。在移动设备搭建端侧 RAG 时,两模型可复用内存中的通用底层权重,显著减少系统总开销。
8K 共享上下文:多模态统一度量池
上下文窗口较前代纯文本模型的 2K 扩展 4 倍至 8,192(8K)个 token。这 8,192 个 token 是所有模态共享的统一度量池,而非各自独占。文字、图片、视频和音频混合输入时,会一起消耗这 8K 预算,不能同时装满各自的上限:
交错输入与长音频切片:文本中可随时使用 <|image|>、<|video|>、<|audio|> 占位符融合为单一复合 768 维向量。面向数小时长录音,工程上应先将其切成符合 8K 预算的片段独立建库,再按检索定位对应区间,而非单次吞下整段长音视频。
MRL 向量截断:存储与精度的工程选型
端侧存储与内存极为紧俏。模型原生集成了俄罗斯套娃表示学习(MRL),前缀维度在训练阶段即完成可用表征优化。开发者无需重新训练,在导出时截取前缀即可缩减向量尺寸:
工程选型法则:端侧存储吃紧时优先以 256 维作为基准评估;128 维仅建议用于严苛纯文本环境,若在多模态中使用必须经过严格离线业务验证。
小模型的价值:有限资源下的高性价比
EmbeddingGemma 2 的价值在于用轻量规模逼近数倍体量的大模型水准,而非在所有指标上盲目争第一:
落地实施三项铁律
1. 严禁使用 float16,必须使用 bfloat16 或 float32:模型内部激活值范围超出了 float16 的动态表示范围,若强行使用将返回 NaN 或产生静默降质。硬件加速环境务必选用 torch.bfloat16,CPU 环境回退至 torch.float32。
2. MRL 截断后必须重新做 L2 归一化:切片截断后的前缀向量模长不再等于 1。若直接用点积计算余弦相似度,将引发静默相似度失真。调用时务必开启 normalize_embeddings=True,且查询向量与底库维度必须绝对严格一致。
3. 规范任务前缀,非文本严禁拼前缀:非对称检索区分 Query 与 Doc 格式;对称任务使用统一前缀。最关键原则:所有前缀指令仅对纯文本生效!图片、视频与音频请直接传入原始信号,绝对不要拼装任何文字指令前缀。
EmbeddingGemma 2: an open, lightweight multimodal embedding model
Introducing EmbeddingGemma 2, an open multimodal embedding model optimized for privacy-first use cases
Oct 06, 2026
|
EmbeddingGemma 2 is the most capable model for on-device multimodal embeddings, natively mapping combinations of text, images, audio, and video into a unified embedding space.
Sahil Dua
Research Engineer, Google DeepMind
Henrique Schechter Vera
Research Engineer, Google DeepMind
Your browser does not support the audio element.
Listen to article
[[duration]] minutes
This content is generated by Google AI. Generative AI is experimental
We introduced EmbeddingGemma last year to provide a lightweight option for high-quality text embeddings, to help your apps organize, search, and connect information directly on consumer hardware. The developer community’s response blew past our expectations. With more than 20 million downloads, builders have used it to power smarter on-device search tools and privacy-first retrieval augmented generation (RAG) pipelines.
Today, we’re launching EmbeddingGemma 2, expanding beyond text to unify code, images, video, and audio in a shared embedding space. Built on the Gemma 4 architecture and released under a commercially permissive Apache 2.0 license, EmbeddingGemma 2 has 740 million parameters, making it optimal for on-device inference. It can help find a specific video clip from a voice memo, or search through hours of audio recordings based on a text query, all processed by a single, natively multimodal model.
Built from the same technology as Gemini Embedding models, EmbeddingGemma 2 is:
- Best-in-class for its size: Achieves leading scores among sub-1B multimodal embedders for its size across benchmarks like MTEB (Massive Text Embedding Benchmark) Code and MAEB (Massive Audio Embedding Benchmark), while matching or outperforming many larger models across text, vision, and audio tasks.
- Modular by design: Requires as little as 270M parameters for text-only workloads with optional vision (170M) and audio (300M) encoders for full multimodal support.
- Storage-efficient: Using Matryoshka Representation Learning (MRL), developers can dynamically truncate output vectors from 768 dimensions down to 512, 256, or 128 dimensions. This provides up to 6x storage reduction for local vector databases and memory usage.
- Optimized for on-device performance: Runs efficiently within tight resource constraints. With quantization, on a Google Pixel 11 Pro, EmbeddingGemma 2 requires as little as ~191MB active RAM for text-only weights and ~567MB for the full multimodal model.
- Extended context ready: Features an 8K token context window (4x larger than EmbeddingGemma 1), allowing it to process up to 5.5 minutes of audio, 29 images, 58 video frames, or interleaved combinations thereof directly on local hardware.
Achieving top-tier quality for code, vision, and audio
EmbeddingGemma 2 matches the strong multilingual text performance of EmbeddingGemma while delivering a significant 9.92-point improvement on code performance (in MTEB Code, from 68.76 to 78.68), making it well-suited for local codebase indexing, semantic code search, and coding agent retrieval. Across image, video, documents, and audio, it sets a new standard in quality-per-parameter for sub-1B models and even outperforms some specialist models more than twice its size.
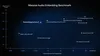
Find full evaluation metrics and model information in the EmbeddingGemma 2 model card.
Enabling semantic search, routing, and retrieval, fully on-device
EmbeddingGemma 2 brings robust capabilities directly to edge hardware. Generating embeddings locally helps ensure data privacy, reduces pipeline latency, and empowers developers to build cross-modal search and retrieval that works entirely offline.
When paired with generative models such as Gemma 4, EmbeddingGemma 2 enables on-device RAG pipelines that understand complex multimodal data. Because EmbeddingGemma 2 is built on Gemma 4 and shares its text tokenizer and audio encoder, developers can run both models together in a unified pipeline with a lower combined total memory footprint.
To learn how to build on-device search and RAG systems with LiteRT, read the Google AI Edge blog post.
Getting started with EmbeddingGemma 2
We worked closely with the following partners to ensure EmbeddingGemma 2 works immediately where you build:
- Download the models: Find the model weights on Hugging Face and Kaggle, with Gemini Enterprise Agent Platform Model Garden availability coming soon. Visit LiteRT Community on Hugging Face for models optimized for on-device.
- On-device deployment: Develop cross-platform apps with Google AI Edge MediaPipe for turnkey embedding, retrieval & decision tasks or LiteRT for custom model integration. Build for the browser with transformers.js or WebGPU.
- Use your favorite development tools: Serve the model efficiently using transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, and LMStudio. Store your embedding vectors with Qdrant.
- Fine-tuning: Follow guidance by Unsloth for how to fine-tune EmbeddingGemma 2 for your use cases.
Explore our developer guide, documentation, and guides for inference and fine-tuning.