改一改函数名,14 种模型读同一份代码最多少烧三分之二的 token
- 你给函数起的名字,决定 AI 改它的时候是翻 19 个文件还是翻 459 个。Modem 用 1680 次对照跑出了这笔账
- 根子在这里:AI 找代码靠的是纯文本搜索,没有编译器给依赖图,也没有语言服务器解析符号。Claude Code 团队早期试过向量库,后来扔了
- 把名字换成一搜就中的,14 种模型和工具组合读同一份代码全部少烧 token:省得最多的那个从平均 7 万降到 2.4 万,中位数省三成,而且自信满满答错的情况归零
- 省下的检索预算会直接变成判断力:同样给八轮预算查 bug,弱模型在巨石文件里只查出 3/8,代码拆开重命名之后是 8/8。那些失败的审查大多没给出错误答案,预算全烧在了翻文件上,没走到下结论那一步
AI 到底是怎么找代码的?(底层机制)
你让 AI 编码的时候,要它改个函数名,它第一件事是在你的仓库里搜。
这个「搜」没有任何高深的地方:把整个仓库的文字过一遍,看哪些行里出现了你要的那串字符,跟你在编辑器里按 Ctrl+F 是同一回事。这个动作在命令行里叫 grep,几十年前就有了;AI 用的是它的加速版 ripgrep(命令写作 rg)。
它不会去问编译器要一张依赖关系图,也没有语言服务器帮它把符号解析明白。它认的只有字面。搜一次、读命中处前后那一段、不够就换个词再搜。
这不是某个工具偷懒。Claude Code 团队早期试过向量库那一套,后来扔掉了,因为纯文本搜索效果更好。学术界做的 SWE-agent 也落在同一个地方:给模型的就是专门做的关键词搜索工具,没有更花哨的东西。
路径也是搜索词。你问 session broker(会话中介)是怎么工作的,AI 会拿 session-broker、sessionBroker、session_broker 三种拼法去扫文件名,一个叫 session-broker/ 的目录,在它读到第一行代码之前就已经是一次命中。
它就在这个圈里转:搜一次、读命中处附近那一段、不够就换个词再搜,够了才开始改。
所以这条链上有一个输入完全握在写代码的人手里:你代码里的词和文件上的名字,能不能当好搜索词。
这笔账是 Modem 算出来的。这家公司 2025 年初创业时就决定全用 AI 写代码,一年下来 36 万行 TypeScript 应用代码加 32 万行测试代码,99.9% 由模型生成;下面的经验和 1680 次对照实验,都出自这一年。
名字起得泛,代价有多大?
那「能不能当好搜索词」到底差多少?他们拿三个函数做了对比。
这三个函数功能完全一样,都是创建一个调用外部服务的 API 客户端,区别只在名字:
export function create(apiKey: string) { ... }
export function createClient(apiKey: string) { ... }
export function createStripeClient(apiKey: string) { ... }
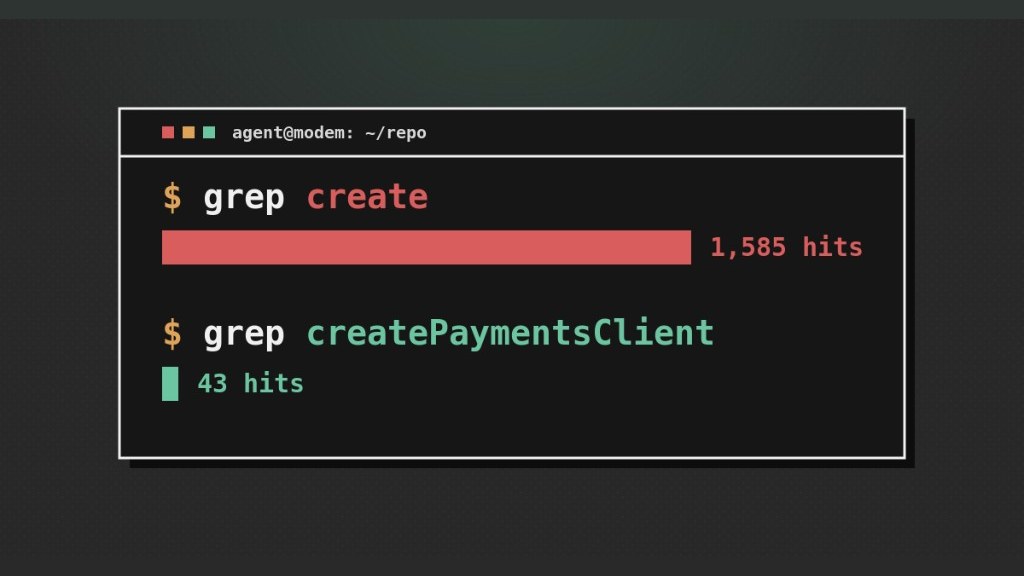
在 Modem 那个约 2900 个 TypeScript 文件的仓库里各搜一遍:
所以问题不在搜得快不快。grep 交回来的是匹配的行,不是答案。一行 const client = create(config) 并不能告诉 AI 这是不是你要的那个客户端,还是那几百个同样叫 create 的东西之一。
要弄清楚,它得打开文件读命中处周围那一段,经常还要往外扩,或者再打开别的段落。一个文件几十到上千行,一行按十个 token 算(token 是 AI 读写文字的计量单位,一次对话能装多少、要花多少钱都按它算,大致一个英文单词一个多),排除掉一个错误候选就是几百到几千 token。挨个排除十几个,几万 token 已经没了,而你交代的活还一个字没动。
那 1585 个命中散在几百样不相干的东西里:测试用的假数据、往数据库里插记录、注册后台任务。而 createStripeClient 的 43 个命中,就是定义、调用点和测试,全都在讲同一个客户端。
省下来的还不止是这一次。上下文是有限的,花在排除那些无关 create 上的每一个 token,都是你这次改动用不上的了。更麻烦的是,当上下文被这些似是而非的匹配填满,模型使用里面信息的可靠程度会下降。一个 grep 一跳就能定位的名字,同时保住了 AI 的注意力和预算。
有 import 指路,为什么还不够?
讲到这里会有人问:文件顶部不是写着这个东西从哪儿来吗(那行 import),顺着它去找不就行了,何必满仓库搜。
如果目标只是从调用点找到定义,这话对。import 是一个指向前方的路标。但开头那个任务是改名,那是反过来的方向:从定义出发,找出所有调用它的地方。纯文本搜索没有反向索引,定义所在的文件里没有任何一行记录着谁引用了它。
同一个 create 的三个调用点,分别用相对路径、包名、重命名导入。搜路径只找到第一个,因为包名里根本没有路径;搜函数名找到两个,漏掉被重命名的那个,还顺带捞回一堆不相干的 create。
import 说这个东西来自 @modem/common,可那不是一个路径。AI 得先翻 package.json 或者搜包名,才知道这个包在哪。找过去落在一个 barrel 文件上,里面全是 export *,这个 barrel 文件就是包门口的一张总目录,只写「这个包的东西都从下面几个文件出去」,不写谁是谁。AI 翻到它,等于翻到一张没有姓名的花名册,还得进包里再 grep 一次。绕了三跳,回到它一开始就能做的那次搜索。
client.getUsers() 这样的调用,任何一条 import 语句里都不会出现 getUsers。import 管的是模块和它的顶层导出,方法两样都不是。这跟 TypeScript 没关系,同样的空白在 Python、Go、Ruby、Java 里一模一样。
模块只指一个方向,遇上 barrel 和包名就模糊;至于你对象上的方法,它一个字都不提。活还是名字在干。
写清参数类型能帮 AI 省掉哪些活?
上面讲的都是「它能不能找到你的代码」。找到之后怎么用,靠的是另一样东西:类型。
类型和注释、README 有个根本区别:注释它可以不读,类型是编译器强制的。跑一次编译,类型错误就是一条具体的反馈,AI 常常一轮之内就能自己改对。
在编译器开口之前,类型其实已经在省钱了。看到这样一行签名,进什么出什么一目了然,很多时候没必要打开函数体:
function enrichUser(user: User): EnrichedUser;
function enrichUser(data) 或者 data: any,想知道 data 是什么就得读实现;读了实现发现它又传给了别的东西,再读那个;可能还得看一两个调用方。少写一个类型标注,一行的阅读变成好几个文件的阅读。TypeScript 的 any 更阴一点:伤害一样大,它还长得像个类型。
类型起得准不准,也一样要紧
下面这个函数,三个参数都是字符串,传错顺序编译器一声不吭:
transferOwnership(
  userId: string,
  orgId: string,
  projectId: string
)
调用时把顺序传拧了,构建照样通过,错误留到运行时。
transferOwnership(
  userId: UserId,
  orgId: OrgId,
  projectId: ProjectId
)
同样传拧,构建当场失败,而且报错里点名了 OrgId 不能当 UserId 用。
有研究观察过这个自纠循环:让模型拿着编译器报错反复改几轮,成功率大约能翻三倍。
而这里有个连环,正好接回前面。那条报错里点名的 OrgId,多半定义在另一个文件。AI 要按报错去改,就得读那个定义,而它找过去的唯一办法还是搜这个名字。
类型名和函数名遵守同一条规矩:OrgId、UserEnrichmentResult 一搜就到定义;叫 Result、Data、Config 就把 AI 又扔回了大海捞针。编译器告诉它去哪儿看,名字决定这一看要花多久。
any 的问题就在这儿:编译器没话可说,AI 也没词可搜。一个起得差的名字,至少还留了条线索。
实验数据:这样做真的有效吗?
到这儿全是道理:名字要具体、类型要准。听着都对,可省下来的到底有多少?Modem 把它做成了一组实验。
他们让 Fable 5 把这篇博客压缩成一份一页纸的技能文件,写代码时加载进上下文。然后拿一份跟两边都无关的需求说明(一个带重试、限流、签名的通知管线小库),交给两个作者模型各写两遍:一遍不给技能文件,一遍给。作者是 Haiku 4.5(Claude Code)和 GPT-5.6 Sol(Codex CLI),于是有了同一个库的四个版本。
Haiku 不带技能写出来的,正是这篇警告的那种代码:
Sol 不带技能写出来的本来就挺讲究,backoff.ts 里放 calculateBackoffDelay、token-bucket.ts 里放 TokenBucket。带上技能之后它走得更远:backoff.ts 变成了 notification-retry-backoff.ts。但两版之间的差距,明显比 Haiku 那边窄。
接下来是读。四个版本各自埋进同样 500 个来自真实仓库的文件里,起干净的会话、只给搜索和读取工具,问的是这类问题:
下一次重试之前要等多久,这个等待时间是在哪儿算出来的?
算好的 HMAC 签名(给发出去的数据盖的防伪章),是在哪一步被附到那份要发出去的数据上的?
给定一个通知 id,我上哪儿能查到它过去所有的投递尝试?
14 种模型与工具的组合,对四个版本各问 10 个问题、各跑 3 遍,一共 1680 次运行,记录花掉的 token 和答得对不对。
读 Sol 写的那份代码时,14 个组合里 12 个变好,中位数省 12%,另外两个没有变好。
规律是一致的:原来写得越糙,改进空间越大。Sol 本来就写得不错,能省的自然少。
模型读自己写的代码,也没有特权
有一行数据值得单拿出来。Sol 去读它自己不带技能写的那份代码,在换成技能版之后,照样省了 13% 到 38%(取决于驱动它的是哪个工具)。
写这份代码的模型,并没有什么「我记得东西放在哪」的记忆。它跑的搜索,和别人跑的一模一样。
还有一类失败,只出现在泛名字那一版
答错的情况基本只出现在 Haiku 那份泛名字代码上,而且是自信满满地答错:问它这个通知库的投递历史在哪儿,它指向了仓库里另一个东西的 Slack 投递账本;问 HMAC 签名是在哪一步附上去的,两次指向了媒体代理服务的 URL 签名器。
技能版的错答是零。长得像但不是那回事的代码,顶不起 hmac-payload-signer.ts 这样一个名字。在 Sol 写的两个版本里,这类失败基本没出现过,840 次运行对了 834 次,出错的几次是零星的、两边都有。
换成真实项目,还成立吗?(一个 4943 行的文件)
合成出来的代码库只能说明一部分问题,所以他们又挑了个真实的硬骨头:Odysseus,一个自托管的 AI 工作台,上线第一周就拿了几万个 GitHub 星。

它的 routes/email_routes.py 是 4943 行,其中约 3900 行是一个函数,81 个路由处理器(每个负责响应一种网页请求)全塞在它里面。一个函数,一整个邮件客户端。
Modem 只重构了这一个文件,行为不变、路由不变、机械验证过,把它拆成按概念命名的模块:
email_routes.py
  4,943 行
  81 个处理器全在一个函数里
email/
  smtp_settings.py
  message_rendering.py
  folder_fallbacks.py
  delivery_history.py
然后拿同样六个问题去问四种模型,结果又是那个规律:原来在巨石里迷路的省得最多(Haiku 4.5 省 34.3%,Grok 4.5 省 31.5%),原来就没迷路的几乎没省(GPT-5.6 Sol 省 5.9%,Sonnet 5 省 3.9%)。Haiku 之前是拿 40 万 token 一页一页翻那堵墙,重构之后不翻了。
更要紧的是最坏情况。那种「烧掉 40 万 token,最后什么也没找到」的灾难性运行,几乎全部发生在没重构的版本里。几乎,是因为重构版里 Haiku 也出了一次,而出事的位置很说明问题:他们只重构了一个文件,Haiku 是在旁边那个没动过的、1800 行的 email_helpers.py 杂物堆里迷的路。重构抬高了地板,而新的地板就是剩下没动的那个最差的文件。
routes/email_routes.py 现在是 6032 行,其中单个函数 setup_email_routes() 占 4580 行。也就是说,这五天里它又长了一千多行,那个巨型函数长了约七百行。这一条是本站拉源码数出来的,博客中没有;你现在去拉可能又是另一个数。省下的 token,能换来什么?
前面两组测的都是花多少钱。还有一个更要紧的问题:花得少,是不是就能干得对。
他们在两个版本的邮件代码里种下四个一模一样的隐蔽 bug(逐字节相同的改动,所以两版含有完全一样的缺陷),然后让四个模型在固定八轮的检查预算内,去核对这几处代码到底有没有按要求写。每个模型每个 bug 查两遍,每个版本 32 次审查,两个版本合计 64 次。
Grok 4.5 和 GPT-5.6 Sol 在两个版本里都全部找到了。八轮,对一个搜索有章法的模型来说,足够在一个 4943 行的文件里 grep 到这些缺陷中的任何一个。
Haiku 和 Sonnet 做不到,在巨石版里分别只查出 4/8 和 3/8。失败的那些审查里,绝大多数并没有给出错误答案。它们把八轮预算全烧在了翻文件上,一个结论都没来得及给出。换成重构后的代码,两个都是满分。
Sonnet 那一行尤其值得看。在前面的检索实验里,它几乎没从这次重构里省到什么 token;可一旦加上预算限制,它的正确率从 3/8 变成了 8/8。在一个巨石文件里付得起查找的钱,和能在里面得出结论,是两码事。
怎么写出对 AI 友好的代码?(干货建议)
机制和数据说到这里,最后是能直接动手的部分。
那份被拿来做实验的技能文件是 MIT 开源的。本站把它抓下来读完,里面有几条博客正文没写、但更好上手的规则。
导出的符号用 2 到 4 个词命名,其中至少一个是业务词。在一个约 70 万行的 monorepo 上实测:一个词的导出名只有 61% 在全局唯一,三个词 96%,四个词以上 98%。用能唯一搜到的最短名字,剩下的话写进注释。
人和 AI 提的问题都是自然语言:「rate limit」「retry delay」。而 RateLimiter 这个标识符,搜「rate limit」是匹配不上的。所以每个导出上方那行注释里,要用带空格的普通词把那个短语写出来:一个 SessionExpiryChecker 应该配上「Checks whether the user session has expired」,这样搜「session expired」才落得到这里。
绝不用模板拼接事件名、功能开关或错误码。github.${entity}.${action}github.pr.merged 成为一个在源码里根本搜不到的字符串。哪怕写全了显得啰嗦,也要写全。
让日志里看到的一条报错,能直接搜回抛出它的那行代码。写 Webhook signature mismatch for ${id},别写 ${prefix}: mismatch。
config.ts、types.ts、utils.ts、helpers.ts 在搜索结果里什么都没说,而且跟仓库里每一个别的模块的 config/types/utils 撞车。前面加上业务词:billing-plan-config.ts。
要求传一个 OrgScopedDb 而不是原始数据库连接。技能文件里的原话是:注释是一个请求,必需的类型是物理定律。
这些建议几乎没有一条是新的。描述性的命名、精确的类型、解释「为什么」的注释,我们互相这么劝了几十年,也一直在原谅自己没做到,因为人总还能问问同事、翻翻 git blame。AI 不能。它有的就是你的文字、你的类型,和一个搜索框。 — Modem 工程博客
最后是这套结论的边界。作者写明的有三条:这份技能同时改了命名、文件划分、类型和结构好几样,省下的 token 没法单独归给命名;Odysseus 那张表里的 token 数只能在同一行内比较,跨工具不能比;Odysseus 那组只重构了一个文件。还有一条作者没有点破,是本站的看法:那份技能文件是让 Fable 5 从这篇博客本身提炼出来的,再拿它去验证这篇博客,属于自我印证。他们也提到 Cursor 发布过不错的数据,显示嵌入式检索叠加在 grep 之上确实有帮助,纯文本搜索未必是终局。不过 grep、仓库地图、嵌入检索,吃的是同一份输入:你源码里的那些词。
email_routes.py 现有行数为本站 2026-07-25 拉取 dev 分支实测,博客数据为其发表时的状态。AI 读你的代码只有一个搜索框,名字起得泛,它就得翻几百个文件才敢动手
Modem 全用 AI 写了一年代码,把这件事做成了一组对照实验,一页带图讲完
↓ 一页读完 · 有一张会动的图
你让 AI 改一个函数,它第一件事是在你的仓库里搜。这个「搜」跟你在编辑器里按 Ctrl+F 是同一回事:把整个仓库的文字过一遍,看哪些行里出现了这串字符。
把整个仓库的文字扫一遍找匹配(命令行工具 grep,AI 用的是加速版 ripgrep)
读命中处前后那一段
不够就换个词,再搜一次
编译器(把代码翻成能跑的程序、顺带检查写错没有的那道工序)画出来的依赖关系图
语言服务器,编辑器里点一下就能「跳转到定义」,靠的就是它
反向查找:从一个函数的定义出发,找出所有调用它的地方
SWE-agent 给模型的也是关键词搜索工具。文件顶部那行 import(写明这个东西从哪儿来)补不上缺口,它只指向前方,而改名要的是反着查。所以你代码里的每一个名字,都是一次搜索查询。差别有多大,Modem 拿三个函数试了一次:功能完全一样,都是创建一个调用 Stripe 的接口客户端,区别只在名字。三次搜索都是四五十毫秒,钱花在命中之后,AI 得挨个打开命中的文件读,判断是不是要找的那个,每读一个都在烧 token(AI 读写文字的计量单位,一次对话能装多少、要花多少钱都按它算)。
省下的还不止这一次。上下文(AI 一次能同时记住的那点内容)是有限的,花在排除那些不相干的 create 上的每一个 token,都是这次改动用不上的;被似是而非的匹配填满之后,模型使用里面信息的可靠程度还会往下掉。
道理听着都对,省下来的到底有多少。Modem 让 Fable 5 把这套写法压成一页规范,交给两个模型各写两遍同一份需求(一个带重试、限流、签名的通知库),一遍不给规范、一遍给;四个版本各自埋进同样 500 个真实文件里,再让 14 种模型和工具的组合各问 10 个问题、各跑 3 遍。
答错的样子值得记一下:问它这个通知库的投递记录在哪儿,它指向了仓库里另一个东西的 Slack 投递账本,语气笃定。改名之后,长得像但不是那回事的代码,顶不起一个写明白了的名字。
最后一组更能说明问题。同样四个埋好的错、同样八轮检查预算,弱一些的模型在那个 4943 行、把 81 个网页请求处理器全塞进一个函数的真实文件里只查出 3 到 4 个。它们大多没给出错误答案,八轮预算全烧在翻文件上,一个结论都没来得及给。把这一个文件拆成按概念命名的模块,两个都是满分。
以上数字均为 Modem 自己设计、自己跑的实验,第三方尚未复现。本站 2026-07-25 拉了同一个分支,那个 4943 行的文件已经长到 6032 行。
那份规范 Modem 按 MIT 协议开源了(可以直接拿走装进自己项目)。里面最好上手的几条,改起来不动任何行为。
validateConfig()
github.${entity}.${action}(userId: string, orgId: string)
文件名只说角色,跟仓库里每个模块的 config 撞车;动词不带宾语;事件名靠模板拼出来,在源码里根本搜不到;参数都是字符串,传拧了编译器一声不吭。
validateSmtpConfig()
"github.pr.merged"
(userId: UserId, orgId: OrgId)
文件名带上业务词;动词配上它的宾语;字符串写全;同类 ID 各贴一个类型标签,传拧了当场编译报错,而报错里点名的那个标签又是一个能搜的词。
还有一条反直觉的:人和 AI 提问用的都是带空格的自然语言(「rate limit」),而 RateLimiter 这种连写的名字匹配不上短语搜索,所以每个导出上方那行注释要用普通词把那个短语写出来。Modem 在一个约 70 万行的仓库上数过,一个词的名字只有 61% 全局唯一,三个词 96%,三个词是拐点。
那个函数改个名
只有一个
搜索框
文字扫一遍,
看哪行有这串字符
- × 编译器画的依赖图
- × 点一下跳到定义
- × 从定义反查谁在调用
不够就换个词,再搜一次。
假数据、插数据库、
注册后台任务……
全跟这个客户端无关
定义、调用点、测试,
讲的都是同一个东西
贵在哪
哪一行是你要的那个,
得打开文件才知道。
活一个字没干
全部少烧 token:
6% 到 66%,中位省三成。
自信满满的答错,归零