Anthropic 放弃代码管理工具 Git,自己开发了一套名为 Scion 的版本控制系统,来适应 AI 开发需要
Anthropic 放弃行业通用的代码管理工具 Git,转而自己开发了一套名为 Scion 的新系统。
当 AI 替人写代码、代码提交量迅速暴增时,Anthropic 原有的 Git 基础设施被撑到了极限。这次从开发 Scion 到迁移代码仓库,团队用了 5 个月。
这套新系统的核心逻辑主要有三点:
- 按需索取:工作的大多是始终联网的 AI 智能体,不需要每次都把全部历史记录下载下来。系统只在需要某些文件时,才去服务器调取对应内容。
- 服务器挑大梁:版本管理中复杂、繁重的计算主要放在云端服务器完成,客户端主要负责把文件放到磁盘、监测改动和维护简单缓存,极大地节省了本地机器的资源消耗。
- 更轻便的记录方式:每次保存修改时,系统只记录改动的文件清单和内容指针,创建变更集时不需要给整个代码库加锁;分支引用另行更新,减少大量任务同时提交时的协调和堵塞。
为什么 Git 顶不住了?(背景与痛点)
在 Anthropic 内部,写代码本身已经不再是瓶颈。因为 Claude 能够自主推进研究循环、微调底层程序,甚至平地起高楼建新服务,代码生产速度极其夸张:
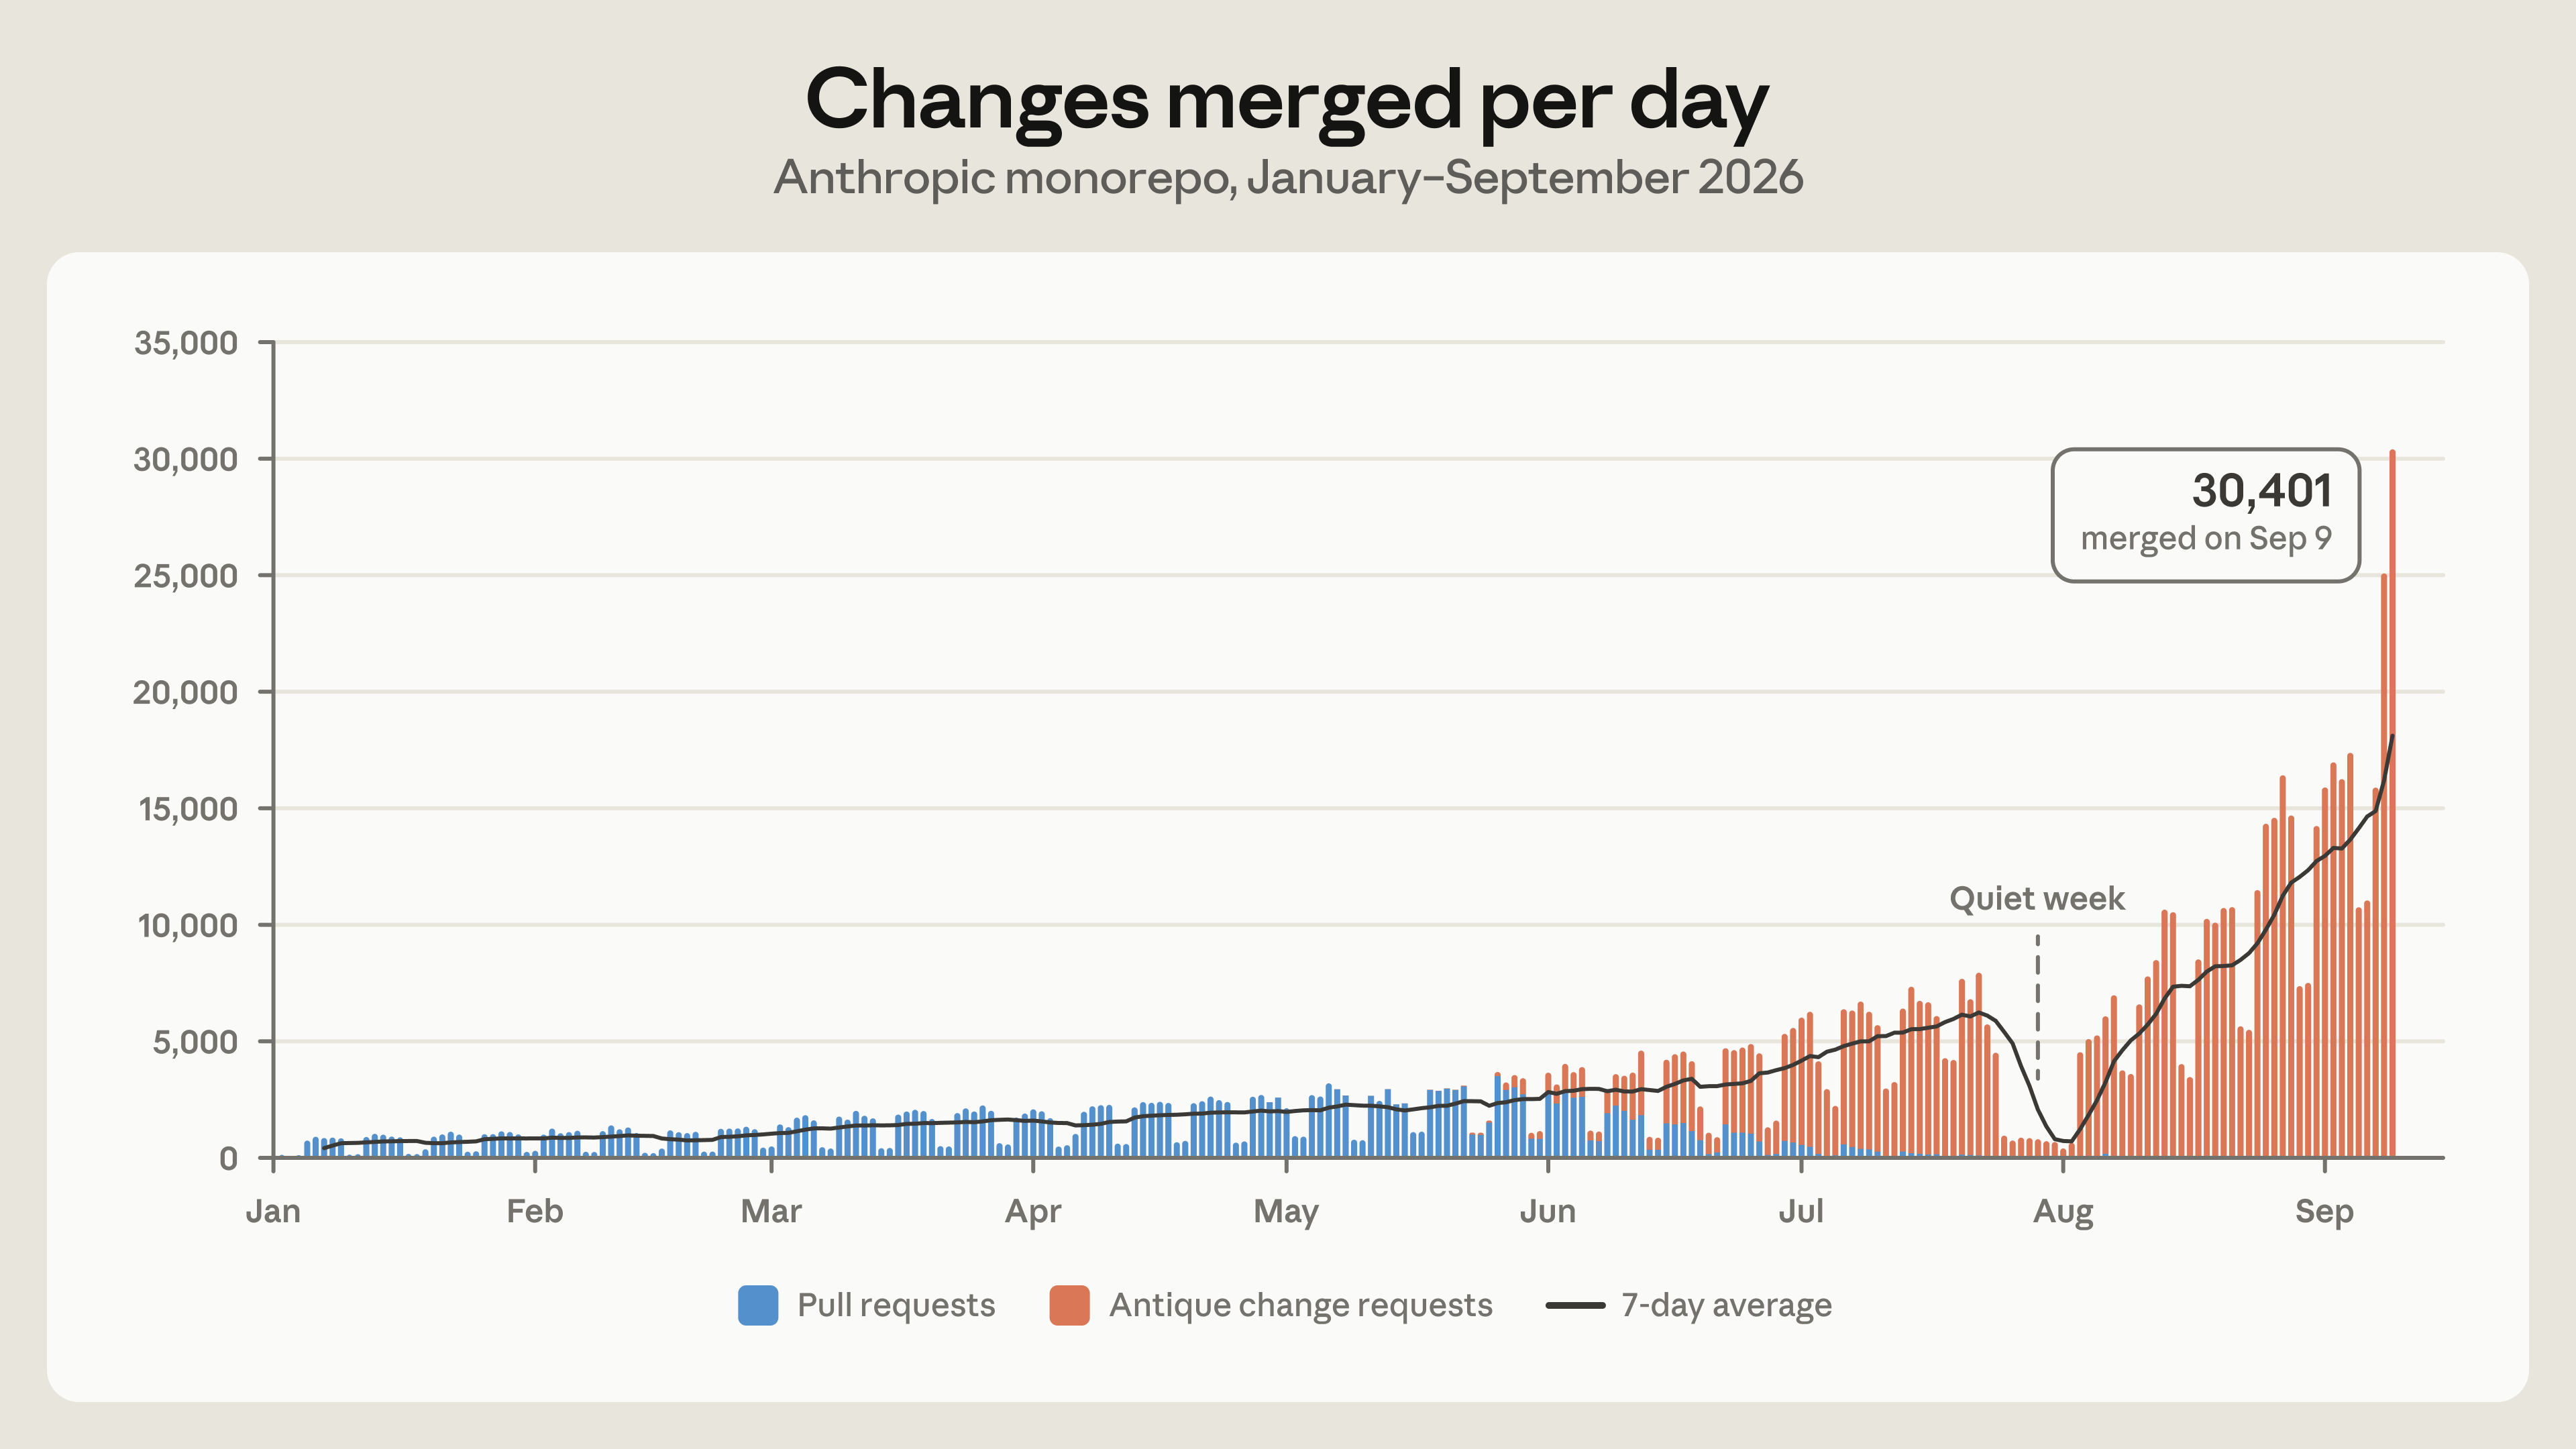
- 合并量涨到 12 倍以上:2026 年 5 月,他们每天大概合并 2,500 次代码;到了 9 月,这个数字冲到了每天 30,000 多次。
- 仓库庞大且流量惊人:主分支历史记录接近 100 GB,压缩后的本地副本超过 25 GB;为了跑 CI(持续集成),每天需要执行约 2,500 万次 checkout。如果每次都把压缩副本完整拉取,每天要产生 600 PB 以上的网络流量。
- Git 的设计假设不再匹配负载:Git 的本质是“去中心化、支持离线工作”,默认的完整克隆保留全量历史。但 Anthropic 绝大多数代码客户端都是始终在线的 AI Agent 和云端 CI 任务。为了让 Git 扛住,他们以前开了几百个镜像节点,但随着合并频率越来越高,主分支更新太快,镜像扩容、更新快照(seeds),以及在部分副本上计算 diff 和 blame 都越来越难维护。

蓝色柱体代表传统拉取请求(PR),橙色柱体代表新代码审查系统 Antique 请求,折线为 7 日移动平均线。图中标注的一天合入 30,401 次,同期 7 日均线接近 1.8 万次。
Git 的离线优势,为什么在这里变成了负担?
Git 的关键优势是本地仓库可以独立工作:网络断开后,开发者仍能提交代码、对比差异和读取已有历史。
这种设计让客户端保留了很强的能力:
- 去中心化(Decentralized):每一个开发者的本地克隆都是一个功能完备的完整仓库。即使在没有网络的高铁或飞机上,你也能离线查看历史提交、对比差异(Diff)以及追溯每一行代码由谁修改(Blame)。
- 对等架构(Peer-to-Peer):客户端和服务端能力完全对等。你的笔记本电脑本质上就是一个随时可以对外提供服务的 Git 服务器。
- 快照完整性(Full Snapshot):每次提交(Commit)在逻辑上都是对整个项目文件树(Tree)的完整记录,通过打包文件(Packfile)和增量压缩来节省磁盘空间。
对于中小型项目或普通开源社区,这种设计极为优雅且坚固。但在一个历史动辄上百 GB 的超大单一仓库(Monorepo)中,当大量在线 Agent 和短生命周期的任务重复获取同一份代码时,维护各自的本地仓库会产生很大的成本。

为支撑数千万次检出,依赖数百个 Git 镜像与对象存储中的全量快照种子,但快照与主干尖端的延迟及历史追溯成本随着提交频率激增而愈发严苛。
Git 本来就提供缩小获取范围的工具,Anthropic 也采用了常见的扩容办法:
-
搭建多级镜像阵列:在集群内部署 Git 镜像(Mirrors),Anthropic 高峰期运行了数百个,用来分流主仓库的拉取压力。
-
冷数据快照(Seeds):把仓库快照作为种子存放在对象存储中,新节点启动时先下载快照,再增量拉取少量新提交。
-
部分检出与浅克隆:利用 Git 的
shallow clone(浅克隆,仅拉取最近几次提交)或sparse-checkout(稀疏检出,只保留部分目录)。
这些办法减轻了负担,但在它的规模下越来越难维护:
-
快照越来越落后:随着合入加速,定期刷新的种子快照距离主干最新版本越来越远,新任务需要补取更多改动。
-
镜像容量与维护成本增长:单一仓库主干历史达到近 100 GB,压缩后的工作副本仍超过 25 GB。仓库继续增长时,镜像的磁盘、内存容量和维护成本也成为扩容约束。
-
部分副本的历史查询更复杂:部分克隆可能缺少查询所需的历史与对象;为了让 Diff 和 Blame 在这些副本上正常工作,工具链需要处理补取数据等额外步骤。
Anthropic 发现,自己的绝大多数客户端都是在线 Agent 和自动化任务,实际协作又围绕一个权威代码库展开。于是它改变了设计起点:客户端只拿需要的数据,历史查询和提交处理交给在线服务。
Scion 把哪些工作交给了服务端?
以「客户端始终在线」作为设计前提后,Anthropic 借鉴了 Google Piper 和 Meta Sapling 等超大单仓系统的演进经验,确立了专为智能体规模设计的自研版本控制系统 Scion 的六大支柱:
- 客户端永远在线(Always Online):放弃离线自主运算的包袱。客户端只在需要时向服务端请求特定数据,不再默认保存完整的历史副本。
- 极端的非对称性(Client-Server Asymmetry):服务端成为唯一的重算中枢,负责处理分支合并、变基(Rebase)、责任归属计算与历史索引;客户端保留轻量职责,仅维护受控的本地缓存、负责把文件投射到磁盘,减少本地所需的数据和计算。
- 版本控制即服务化 API(API-First):CI 工具如果想知道「这两次提交之间有哪些改动」或者「这一行是谁写的」,不再需要在磁盘上克隆仓库,直接调用服务端的元数据 API,获取查询结果。
- 全链路水平扩展,消灭全量物化副本:系统中不存在任何一个地方存有整座仓库的完整展开形态。没有 Git 那种庞大复杂的 Packfile,也就彻底免除了仓库定期的解包与压缩维护。
- 极简增量、无锁提交(Lock-Free Changesets):提交必须便宜且迅速。每次提交只记录变动的增量文件列表,绝不扫描全仓;创建变更集与移动分支引用分开处理,减少创建阶段的协调。
- 工作目录彻底可选,默认稀疏与虚拟化:能不落盘就不落盘。代码检出支持只拉取指定目录(稀疏检出),或者只建立虚拟目录树、待程序实际读取文件时才流式加载数据(虚拟化检出)。
切换任务,比较 Git 与 Scion 的处理路径
选择不同的开发运维场景,对照一直保留;看哪些工作在本地完成,哪些交给在线服务。
Anthropic 原 Git 链路
分布式对等Scion 在线服务
非对称服务化改动怎样保存,文件怎样取回来?
为了让这六项原则落到实处,Scion 在数据结构和网络拓扑上采用了不同的设计。
1. 先记录变更集,再派生目录树(Changeset)
在 Git 的底层结构中,一次提交指向的是一个代表项目根目录的 Root Tree 对象,哪怕你只改动了一个字符,Git 也会从底层叶子节点向上重新构建一连串目录树哈希。
Scion 的核心记录方式不同。它的核心逻辑单元是预写式日志(Write-Ahead Log)中的一条 Changeset(变更集):

元数据记录于分布式数据库,目录树由服务端派生生成,不直接存进变更集;文件内容按哈希去重压缩存入分布式对象存储。
-
存了什么:Changeset 记录元数据(作者、说明、父节点指针)以及一份相对第一父节点的变动文件清单(例如被修改的
guide.md对应的哈希、被删除的legacy.rs)。文件具体内容经过压缩后,按内容哈希直接写入云端对象存储(Cloud Storage)。 -
去除了什么:Changeset 不存储整仓目录树结构。提交时无需协调多台服务器打包,也无需更新任何全局分支引用。
-
分支移动是单行数据库操作:主分支(Main Branch)引用的推进,在底层被抽象为对 Google Cloud Spanner 分布式数据库中单行数据的 CAS(Compare-And-Swap,比较并交换)原子更新。提交过程因此完全解耦,吞吐量极大提升。
2. 派生数据机制(Derived Data)
单纯记录变动清单固然能实现写入飞快,但如何快速回答「这行代码五年前是谁写的」或者「某个文件经历过哪些提交」?
Scion 采用了一种名为派生数据(Derived Data)的通用计算框架:
-
文件的 Blame 链条、路径变迁历史、提交图跳表(Skip Lists)等辅助结构,全都被定义为派生数据。
-
派生数据以递归方式定义:某个变更集的派生值,可以通过其父变更集的派生值加上当前变更集中的改动计算得出。
-
服务端可以自主决定哪些常用索引立即预先计算(Eager),哪些冷僻索引推迟到被查询时再算(Lazy)。由于客户端完全看不到底层索引的细节,服务端可以优化索引,无需客户端做出任何改动。
3. 三级流式缓存架构:scn 客户端的工作原理
为了支撑每天数千万次的高频读取,Scion 搭建了一套分层隔离的物理缓存网络:

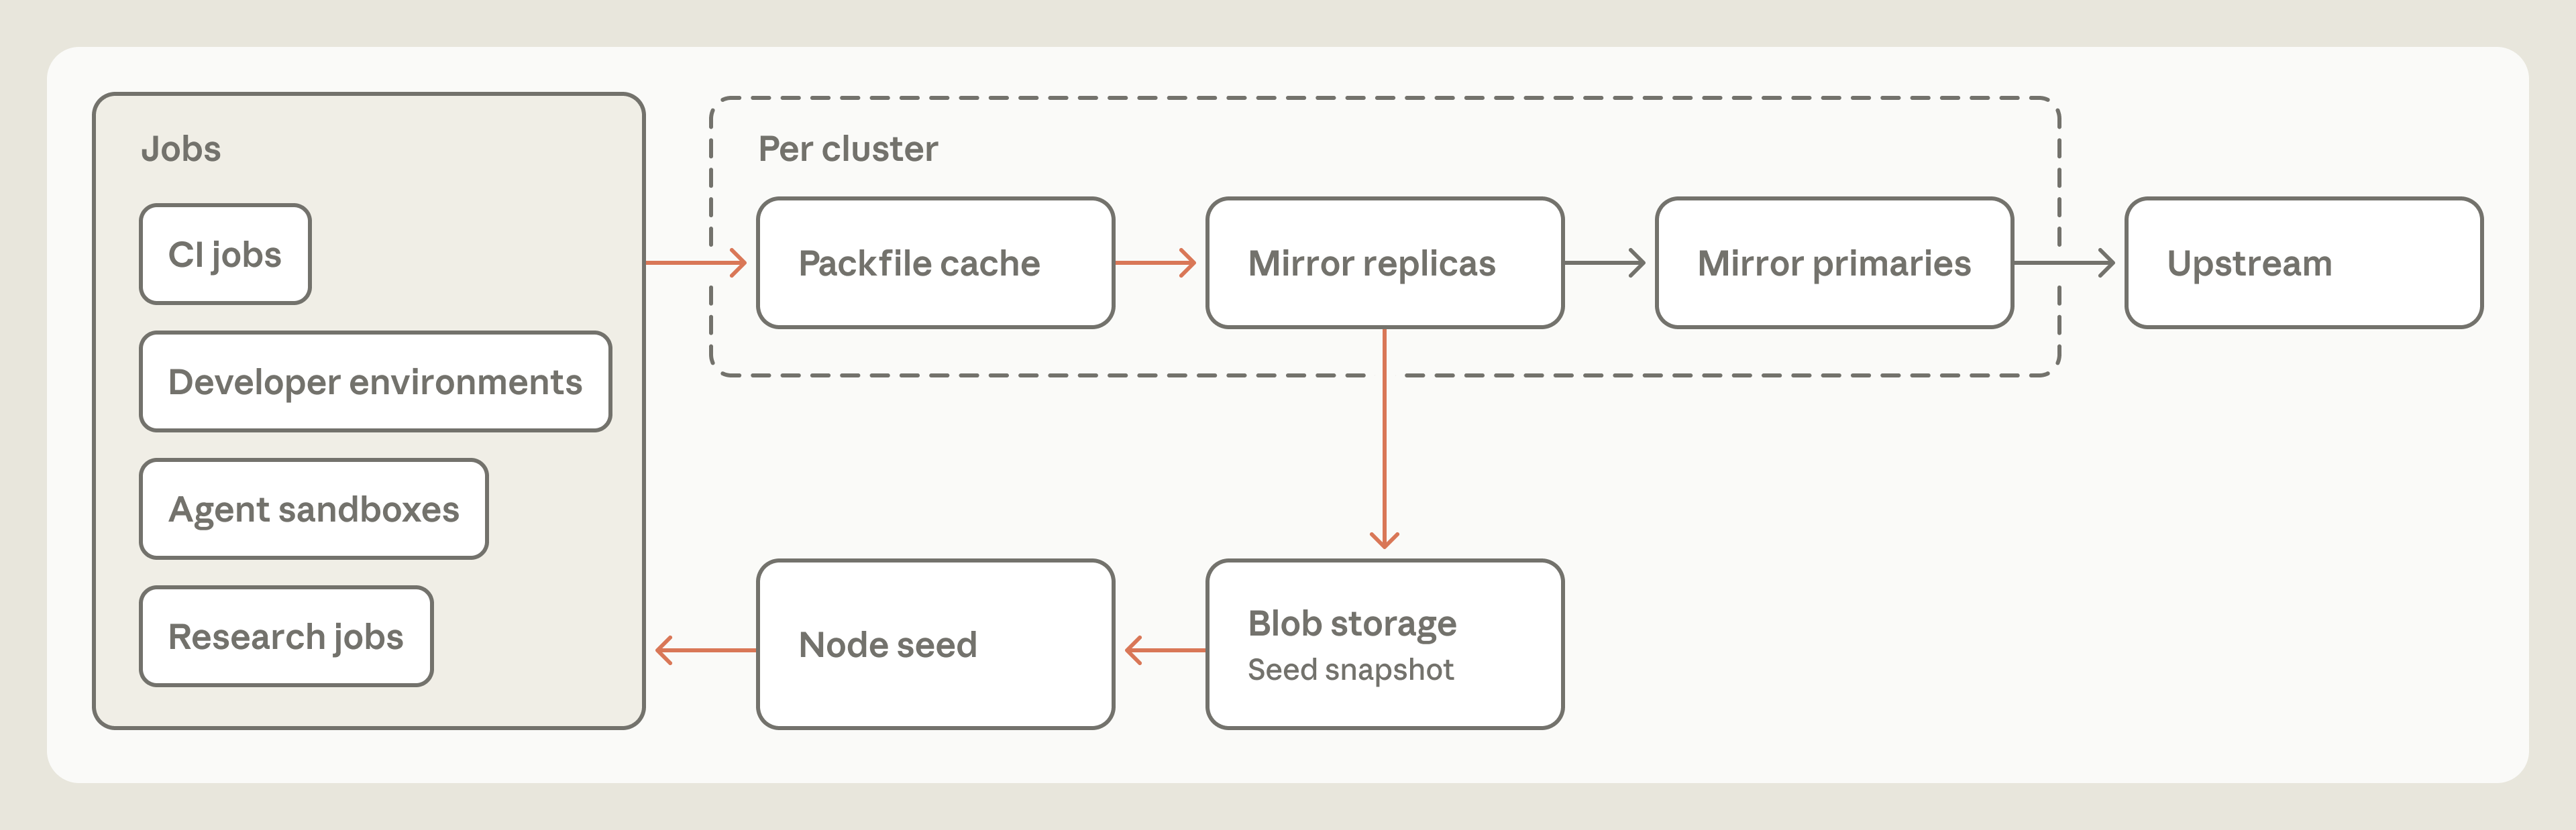
客户端通过本节点守护进程直接复用缓存对象,未命中时向区域级内存缓存流式拉取,严格的分级隔离避免了下游故障反噬中央数据库。
在传统 Git 协商协议中,客户端与服务端会协商哪些对象已经存在、哪些还需要传输,由服务器计算双方差集。在超大仓库中,这种握手极为消耗 CPU。
Scion 改变了协商流程:客户端从不向上游汇报自己拥有什么,它只向服务端索取自己缺失的目标树与对象哈希。
具体的运转层级如下:
- 本地守护进程(scion-daemon):运行在每个物理计算节点的后台。同一节点上的多个任务共享该守护进程。因为同一节点上的任务运行的代码高度重合,绝大部分文件直接在本地守护进程的缓存中命中。
- 区域内存缓存(scion-cache):当节点守护进程未命中时,请求被转发至该数据中心的区域缓存集群。这组服务器直接在内存中以磁盘原生格式流式下发对象,不必为每个请求计算缺失对象集合和重新做增量压缩。
- 权威服务集群(scion-server):只有两级缓存全部穿透时,请求才会抵达最顶层的权威节点,从分布式数据库 Spanner 和对象存储中读取源数据。
Anthropic 报告各缓存层的命中率均超过 99%。这三个层级对外暴露完全一致的 RPC 接口,但通过严格的分级规则隔离故障域,防止区域缓存故障时的大量请求直接冲击权威服务。
快了多少,要按操作分别看
这套体系在实际落地后,带来了怎样的量化改善?
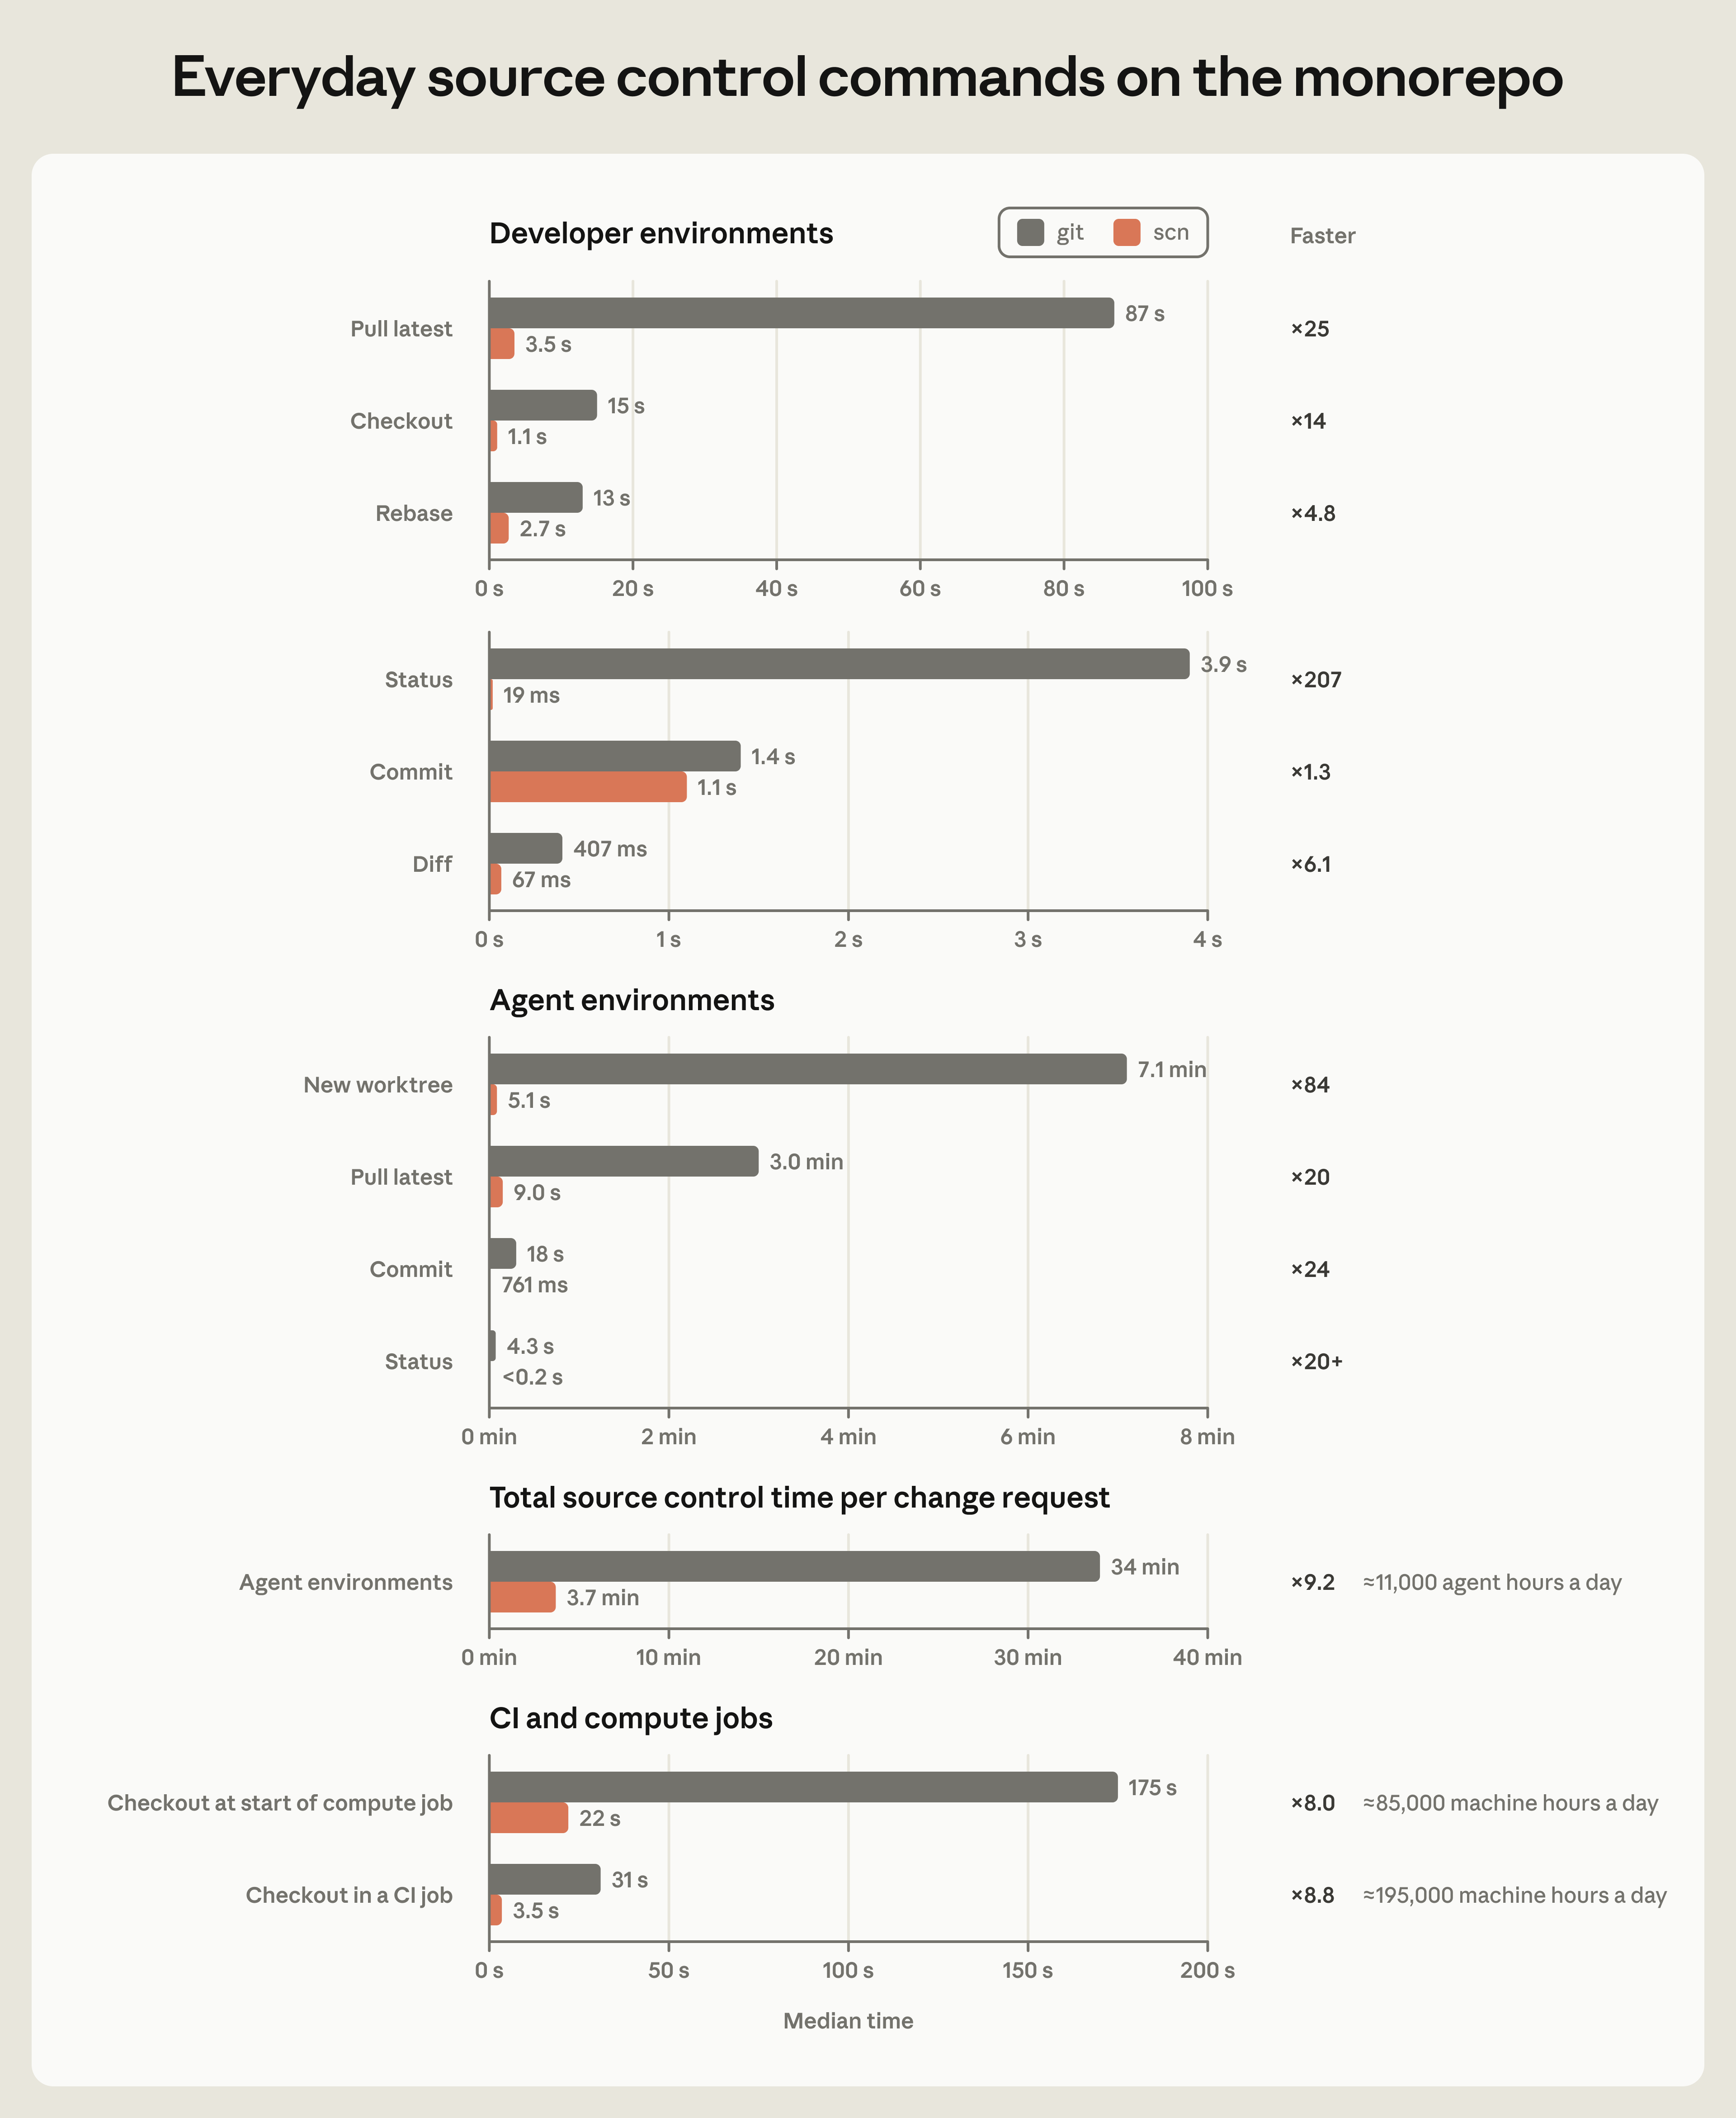
在全量迁移上线后,各环节性能出现了显著的分化加速。收益在不同环境、不同命令之间并不均匀。下面保留 Git 和 Scion 的同类操作对照。
同一操作,Git 和 Scion 各等多久?
基于 Anthropic 内部超大单一代码仓库实测中位耗时(Median Time),直观查看不同环境下的加速比与规模收益。
各行以 Git 耗时为 100%,细条保留实际比例;小于 0.2 秒的 Status 用 0.2 秒上界画条。数字为内部中位数,未披露样本量及缓存条件。

橙色为 Scion(scn),灰色为 Git。在智能体环境与大规模计算任务中,新建工作目录、状态查询与检出各有不同幅度的改善;数据源自内部单一仓库实测中位数。
在 Agent 环境里,每个变更请求的版本控制总耗时从 34 分钟降到 3.7 分钟,约快 9.2 倍。这是多种操作累积的等待,能说明重复准备代码对一个任务的整体影响。
关键维度表现如下:
-
智能体工作树(Worktree)初始化:从过去的 7.1 分钟 锐减至 5.1 秒,提速达 84 倍。智能体无需再为空转等待付出漫长时间。
-
状态查询(Status):开发机上的
scn status耗时从 3.9 秒 缩短至 19 毫秒(207 倍),减少了交互等待。 -
CI 检出耗时:CI 任务内的检出从中位数 31 秒 降至 3.5 秒(8.8 倍);启动计算任务时的检出从 175 秒 降至 22 秒(8 倍)。
-
Agent 等待和机器时间减少:
- 智能体环境每天节省约 11,000 小时 的版本控制等待时间;
- CI 与计算集群每天释放合计约 280,000 机器小时;
- 仅 CI 一项提速,使 CI 自身获得了 25% 的 CPU 容量收益。
-
版本控制基础设施占用减少:相比过去需要维护数百个 Git 镜像,Scion 服务端在 CPU 与内存占用上的基础设施需求约为原来的 1/200。
这些机器时间和 Agent 时间的节省来自 Anthropic 对内部负载的估算,不能换算成人类工程师节省的工时。性能图给的是命令中位耗时,未列出硬件、样本量或缓存条件;每个数字都应按对应环境理解。开发者的 Commit 就只有约 1.3 倍提速:从 1.4 秒到 1.1 秒。
七个人怎样完成这次迁移?
七人团队在五个月里完成了 Scion、Antique 和相关系统,并迁移了整个代码仓库。Anthropic 认为,这类工程过去往往需要更多工程师和多年的渐进迁移;这里的团队规模也离不开它能大量使用内部 Claude 的条件。

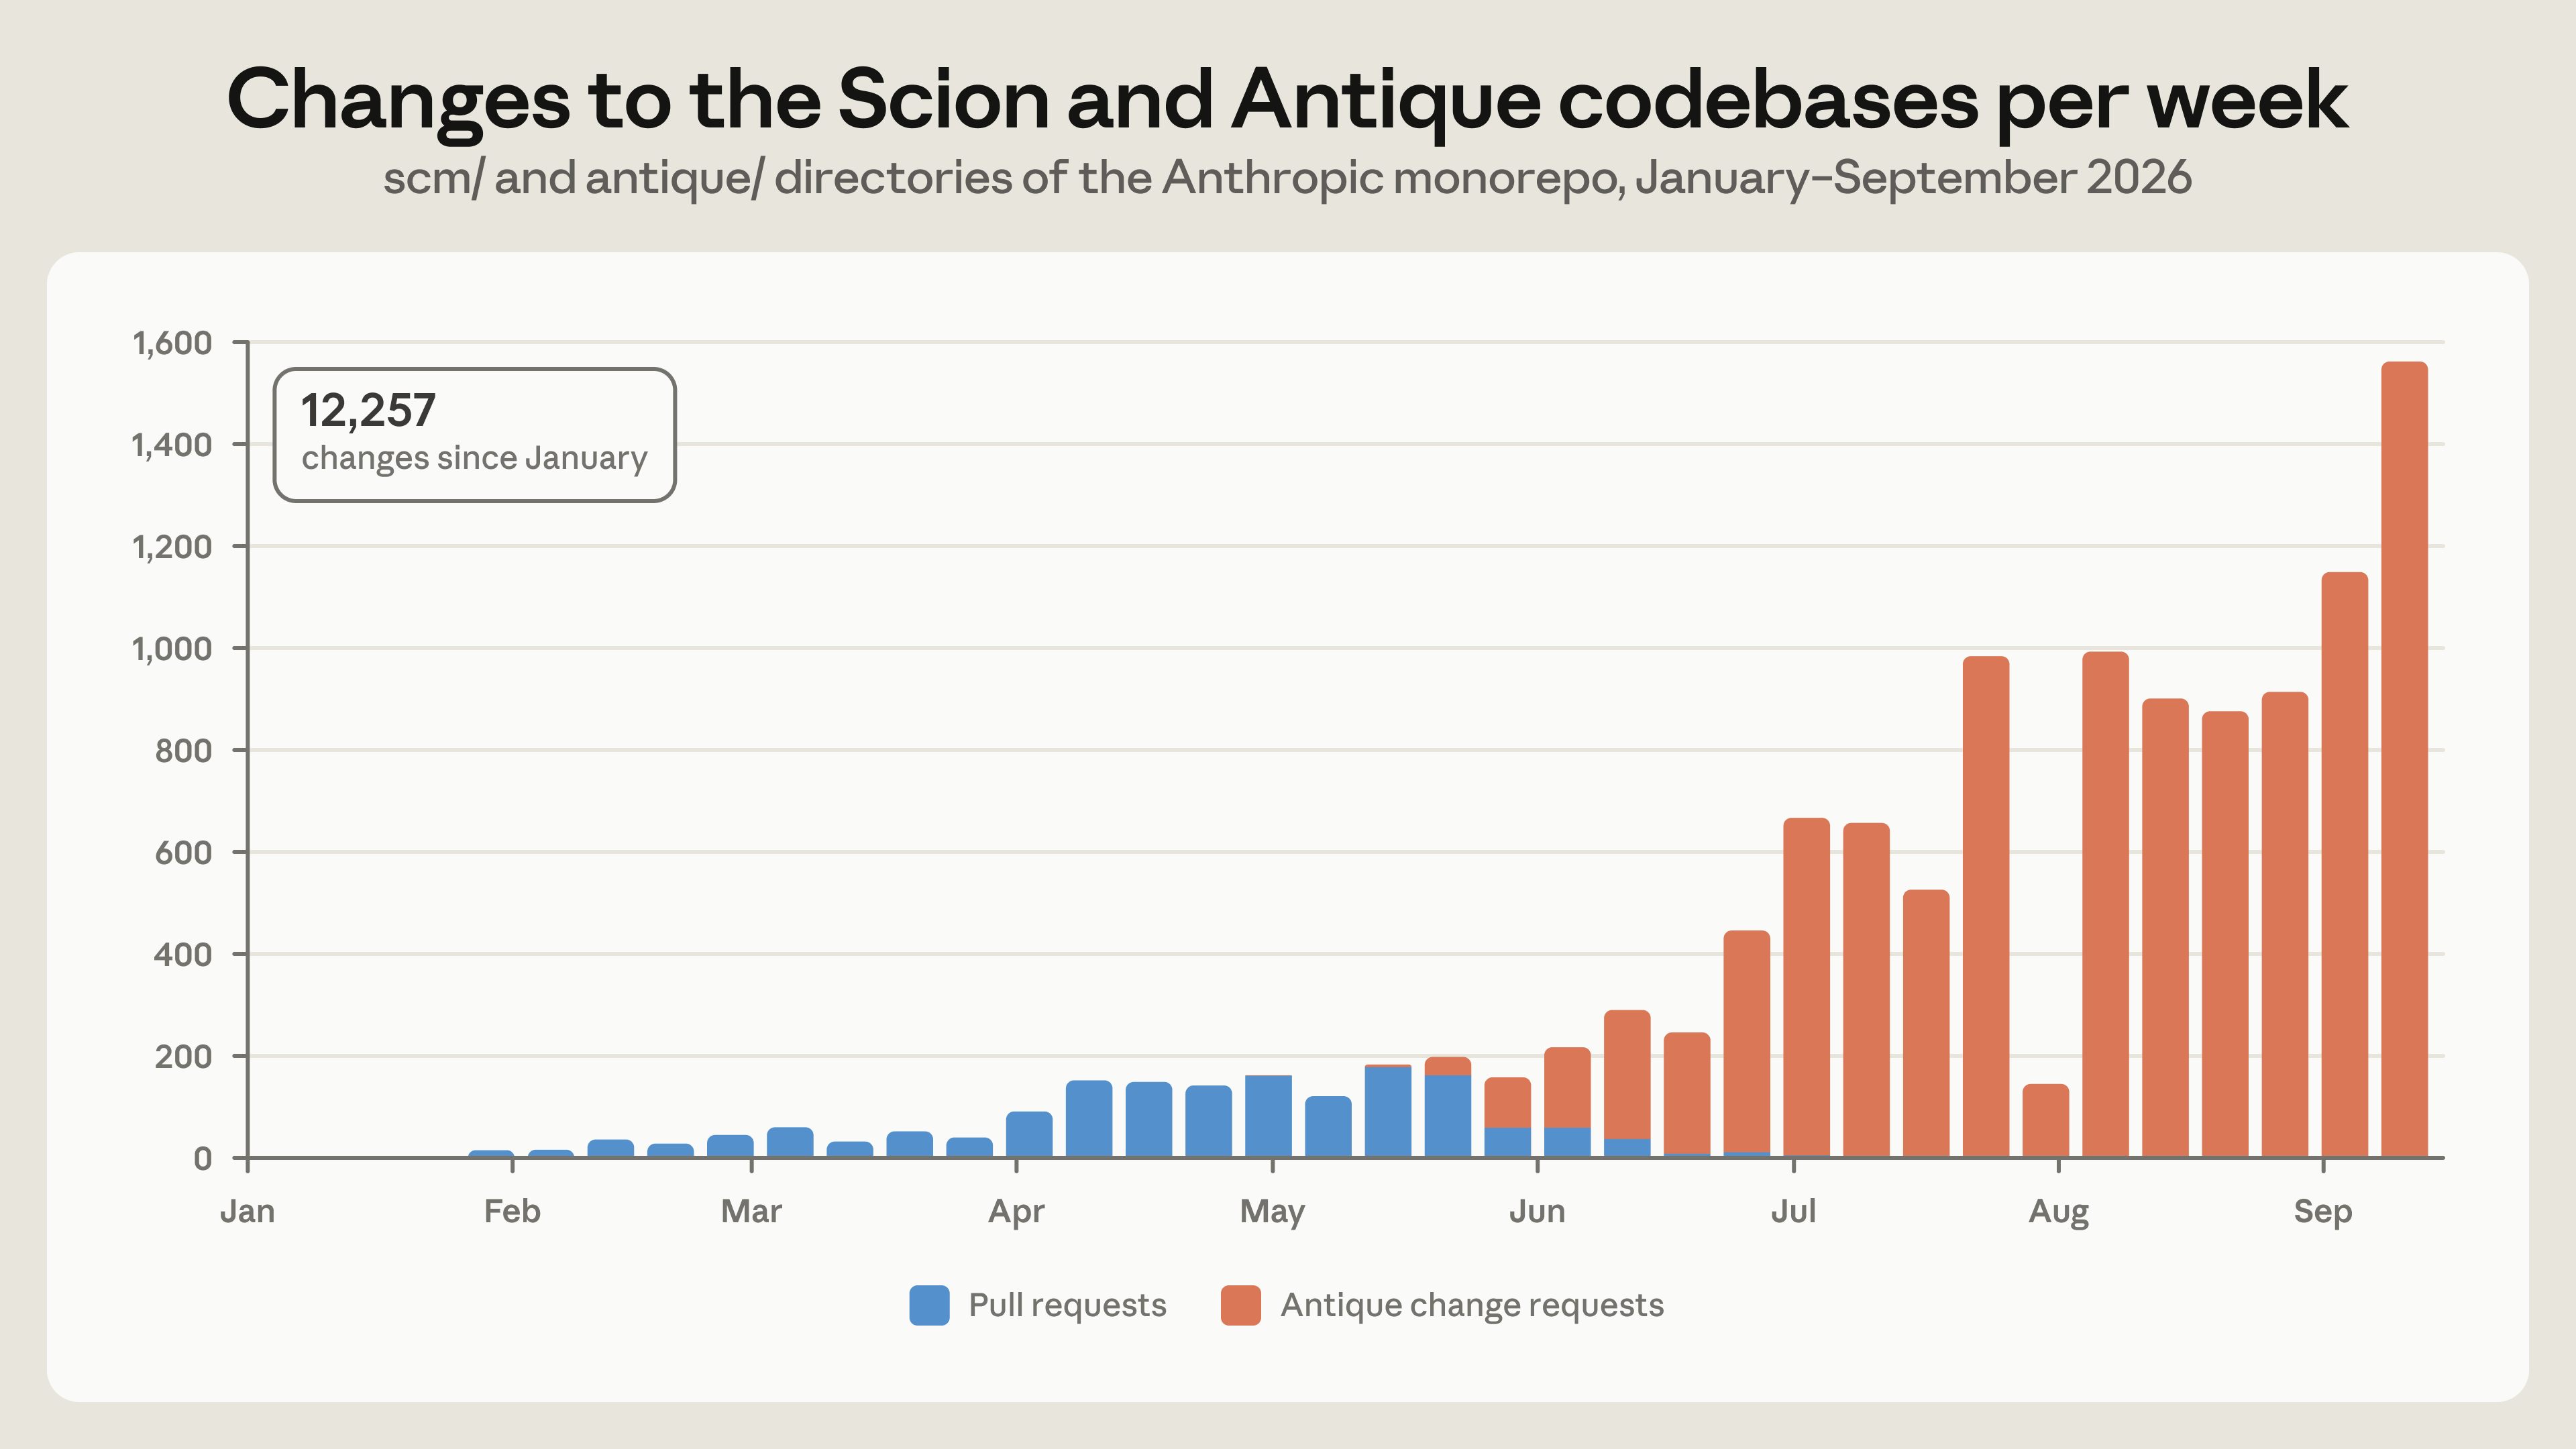
统计覆盖版本控制核心与代码审查两个核心目录,数月内累计合入超过 1.2 万次变更,展示了这两个系统自身的迭代频率。
Claude 既增加了旧工具链的负载,也帮助工程师实现和优化新工具链。
这次迁移也改变了团队的工作方式:
1. 模型负责写代码,工程师负责「对模型说不」
参与项目的工程师认为,Claude 在写代码方面已经比自己更强;系统目标、组件关系和设计取舍仍由他们把握。
早期由人类工程师手写完成的 Git 到 Scion 历史数据摄取原型,是团队原先认为不错的版本。当工程师将这套代码丢给 Claude 后,在没有任何额外调优指令的前提下,模型直接重构产出了一版内存占用降为原来的 1/20、处理速度提升 4 倍的高性能实现,并完整保留了所有隐式的时序不变量约束。
但这也带来了新的挑战:Agent 有时会为了满足局部要求而违反系统约束,也可能因为过度防御而把实现变复杂。
-
多个由模型编写的周边脚本,为了查询某项变更何时合并到主干,竟然试图线性遍历提交日志,而不是去调用成熟的审查工具 API。
-
在内部推行的对抗性审查(Adversarial Review)中,模型由于过度担心另一个微服务不可靠,自行添加了大量臃肿的校验层和防御代码,导致系统复杂度不合理膨胀。
-
审核重心发生变化:团队仍审查每一项变更,但把重心放到根本意图(Intent),确立跨系统契约,并在模型试图破坏架构约束时坚决予以否决。
2. 测试期间主干还在变化,验证要重新安排
在传统研发体系中,为了保证主干永远处于可构建状态,广泛采用带有全局锁的合并队列(Merge Queue):提交 A 必须通过完整测试合入后,提交 B 才能基于最新状态排队。
但当单日合入量达到数万次、每分钟都有多笔代码落盘时,测试运行期间可能又有数百甚至数千项变更合入,团队难以复制全仓合并队列锁的做法。
因此它把更多验证投入到合入后测试(Post-Merge Testing)与部署前验证。并发合入固然会导致代码逻辑冲突,但 Anthropic 称 Claude 通常能很快修复这些冲突。这里的取舍是接受合入阶段可能出现的问题,再通过合入后和部署前的测试处理;这需要配套验证能力,并没有取消代码审查。
3. 运维监控的「死忠粉」(Superfans)
在监控方面,团队借助内部工具,使用 Claude Tag,在 Slack 频道中安排 Claude 持续关注各个核心组件。
-
有专门盯梢
scion-daemon守护进程的 Claude,有专属守护scion-cache内存池的 Claude,也有紧盯代码审查合入队列的 Claude。 -
它们能访问相关遥测和日志,持续寻找异常;团队称这能发现传统告警不易覆盖的细微和新型问题。传统告警也继续保留。
4. 封闭仿真与语义权限:高吞吐下怎样守住质量与敏感代码
随着 Agent 写入吞吐大幅提升,如何保持测试覆盖并管控敏感代码的访问与审批成为关键。团队借助 Claude 与 Scion 机制在两个环节建立防线:
-
以封闭仿真保障测试覆盖:在紧张的迁移工期内,Claude 帮助团队快速建立了针对复杂基础设施与源控交互的封闭仿真(Hermetic simulations),并配合模糊测试(Fuzzing)与精细限流。这套机制的作用是在受控隔离环境中模拟各种极端交互与异常输入,在代码吞吐激增时排查潜在缺陷与并发隐患,并通过限流防止高频请求冲击底层服务,增加测试覆盖。
-
以目录权限与语义审查管控敏感代码:Scion 原生支持仓库与目录级别的细粒度权限控制,在保留单一仓库协作便利的同时保护敏感代码;配套的代码审查工具则能表达复杂的审批语义条件,区分单纯的注释变化与敏感的逻辑改动。这套机制的作用是将人工审查精力聚焦在真正关键的逻辑变更上,避免无关改动阻塞流程,并按照权限和审批要求处理敏感代码。
普通团队能借鉴什么?
看到这次迁移,开发者最容易产生的疑问是:Git 真的要被淘汰了吗?我们是不是也该换掉 Git?
普通团队仍可继续使用 Git;Scion 的优势需要巨大代码库和高频在线任务这样的负载才能体现。
Scion 针对的是非常特殊的负载:
-
自研闭环成本极高:Scion 并不是一个开箱即用的命令行工具。它深度绑定了自研的代码审查平台 Antique、定制的代码搜索和内部 IAM 权限控制。任何团队如果想换掉 Git,就必须配套迁移代码审查、搜索和 CI 等开发流程。
-
不可复制的算力倾斜:Anthropic 内部对大模型 Token 的消耗额度,远远超出了普通商业公司在内部研发工具上所能承担的财务预算。
-
场景不同:对常规团队,Git 的离线能力与成熟工具生态仍有价值;Scion 主要面向巨大单仓和大量 Agent。
Anthropic 希望把其中一些思路带回 Git 生态:
- Git 服务端不应再机械模拟客户端:GitHub、GitLab 等代码托管平台完全可以引入类似 Scion 的非对称架构,让服务端负责重算并提供精细的 RPC 查询接口,而不是逼迫客户端把庞大的 Packfile 下载到本地。
- 重塑协商与检出协议:Git 生态长期以来虽然拥有稀疏检出(Sparse checkout)和按需加载(Promisor remotes)等特性,但仍有进一步协同优化的空间。如果能够标准化「按需流式拉取对象」的精简协商协议,可以减少大规模任务在传输与维护仓库上重复付出的成本。
这次迁移显示,AI 加快代码生产后,瓶颈会继续向存储、分发、审查和验证移动。对普通团队,更有参考价值的是检查哪些任务其实只需要一个查询结果、哪些文件被重复搬运,以及服务端能否承担更多公共计算。Scion 是 Anthropic 内部系统,目前没有可供普通团队安装的通用版本。
Anthropic 放弃代码管理工具 Git,自己开发了一套名为 Scion 的版本控制系统,来适应 AI 开发需要
AI 把代码生产加快后,重复搬运代码、维护历史和协调提交成了新的等待。Scion 从“客户端始终在线”出发,把版本管理改成按需服务。
Anthropic 的单一仓库历史接近 100 GB,压缩副本超过 25 GB;CI 每天约需 2,500 万次检出。多数客户端是在线 Agent 和云端任务,反复准备本地仓库的成本不断累积。
Git 支持离线和对等协作,默认完整克隆保留全量历史。Anthropic 已用数百个镜像和种子快照分流;合入越来越快后,快照追赶主干、镜像扩容和部分副本的历史查询都越来越难维护。
在线任务按需取,公共重算交给服务端
Git 的本地能力
保存仓库副本,在本地提交、查看差异和追溯历史;离线也能工作。
Scion 的职责分工
客户端放置文件、监测改动、维护轻量缓存。合并、变基和历史索引由服务端处理;只查询结果时可直接调用 API。
文件读取:命中就返回,缺什么才向上取
客户端只索取缺失的树与对象哈希,无需先汇报自己已有的全部对象;系统避免维护整仓展开副本及 Git Packfile。
把“记录改动”与“移动分支”拆开
先创建变更集
仅记录相对第一父节点的改动文件清单、元数据和内容指针,不存整仓目录树;创建阶段无需全仓锁。
再更新分支引用
主分支通过 Spanner 单行 CAS(比较并交换)原子更新推进。目录树、Blame 与历史索引由服务端派生计算。
提速要按同一操作、同一环境看
7 人、5 个月:模型写代码,人类把握契约
实现与架构
团队完成 Scion、审查工具 Antique 与全仓迁移。Claude 重构历史摄取原型后,内存降为 1/20、速度提升 4 倍;工程师仍审查每项改动,防止模型违背系统意图或过度增加防御代码。
高吞吐仍需验证
合入后测试、部署前验证承接并发变化;封闭仿真与模糊测试增加覆盖。目录权限和语义审批保护敏感代码,Claude 监控与传统告警共同关注异常。
普通团队借鉴分工,不必照搬迁移
Scion 面向巨大单仓与大量在线任务,是 Anthropic 内部系统,目前没有通用安装版本。迁移还涉及审查、搜索、CI 和权限体系;其大量使用内部模型的条件也难直接复制。
检查哪些任务只需要一个查询结果,哪些文件正在被反复搬运,以及服务端能否承担更多公共计算。Git 的离线能力与成熟生态对普通团队仍有价值;按需读取与服务端非对称分工也可成为 Git 生态的改进方向。
Redesigning source control at Anthropic
As our merges per day grew more than tenfold, source control became our biggest development bottleneck. Here, we share how we migrated to an in-house version control system in five months.
At Anthropic, coding is no longer the bottleneck to building systems or doing research. Claude is able to autonomously iterate on research loops, micro-optimize complex programs, and build new services from the ground up at a speed and scale we haven’t seen before. The bottleneck, now, is all of the developer infrastructure built for human scale: source control, builds, and CI.
In May 2026, Anthropic averaged around 2,500 code changes merged per day; as of September, we merged over 30,000 per day. We don’t expect this rate of growth to slow down anytime soon; the latent demand for merging code is practically infinite, and every bottleneck we remove immediately leads to a further increase in the amount of code we produce.
In order to support this growth, we built Scion, an in-house version control system, and fully migrated our monorepo from git in five months. We also built and shipped a code review surface (called Antique), code search, a rich source control IAM system, novel ways of managing and landing large amounts of reviewed code, and more, all in that same time period. In this post, we’ll focus on how we built Scion specifically. It makes for an interesting case study: Claude’s ability to write code was both what put us in this situation in the first place and how we were able to quickly build a high-quality, scalable system to deal with it.
Growing our monorepo
Before we explore what we built, we should acknowledge how unusual our workload is. Unsurprisingly, Anthropic uses Claude to write software far more than almost any other company, so we’re often the first to see where tools built for human scale start to strain. Source control is just one example of this. While we don’t expect many organizations to have these problems in the very near term, we suspect it won’t be too long before others who use AI coding tools experience these same pressure points, which is why we wanted to share what we built and what we learned.
Git is a decentralized system: every clone is a complete, self-contained repository that can compute diffs, read history and blame, and check out any revision while fully offline. For the vast majority of repositories, this is the right design, and it’s a large part of why git became the standard.
As our monorepo grows, it increasingly doesn’t fit that design space. The history of our main branch alone is almost 100 GB, and a compressed working copy is over 25 GB. We perform on the order of 25 million code checkouts per day for CI, before counting developer environments, agent sandboxes, and research jobs. Fetched naively, that would be over 600 PB of git traffic per day.
Git offers tools for working with a slice of a repository, such as shallow clones, sparse checkouts, and promisor remotes. Beyond these, there are standard workarounds for large monorepos, like internal git mirrors and repository snapshots (seeds) kept in blob storage. We’ve used all of them—at our peak, we operated several hundred internal git mirrors to deal with the load. This bought us time, but they became harder to operate as our merge rate increased. Seeds fell further from the tip of main between refreshes, and it took more and more care to keep operations that depend on history, like diff and blame, working on partial clones.
Taking a step back, we noticed that, like most companies, we were using git as a centralized system with one authoritative copy, but nearly all of our clients were agents and jobs that are online by definition. The properties that make git excellent for distributed, offline work were actively undermining our ability to scale as the repo grew. So we asked ourselves: if we designed source control with the fact that agents are always online in mind from the start, what would it look like?
Principles for agent-scale source control
With agentic coding, many common assumptions about how software is developed are evolving. We embraced these changes when building Scion, which allowed us to take a fundamentally different approach than git on several core principles. Source control for huge monorepos has prior art, notably Google’s Piper and Meta’s Sapling, so we were able to build Scion with their hard-won lessons in mind. Our principles are:
Clients are always online. Git assumes that clients work offline and need a complete copy of the repository. Since nearly all of our clients are agents and jobs, we designed Scion’s client and protocols around a server that is always reachable, and have clients fetch data when they need it.
Client-server asymmetry. In git, every client is capable of being a full-fledged server. In Scion, the server answers questions about file history and blame, creates commits, performs merges and rebases, and so on. The client maintains a bounded local object cache, lays out the working copy files on disk, monitors for filesystem changes, and gives users an ergonomic way to work with the server. It can compute very little on its own but, in exchange, it requires much less data locally.
A comprehensive source control service can power many novel applications. With git, a CI job or tool that needs to ask a question about the repository, such as who last changed a line or how two commits are related, has to maintain a local copy of the repo or hope that vendor-specific APIs provide the answer. With Scion, all of the source control queries the client uses are also exposed via API, so in many cases jobs don’t need a local repository at all. Many internal tools, such as our automated bisect and revert pipelines, wouldn’t be practical at scale without this cheap, programmatic access to source control.
Everything must be horizontally scalable. At our peak, we ran several hundred git mirrors, which significantly strained capacity and no longer scaled once the repo outgrew the mirrors’ disks or memory limits. In Scion, the repository’s data is distributed, and every component is independently scalable; there is no fully materialized copy of the repo anywhere, even on the server. There is no equivalent of packfiles (git’s compressed bundles of objects), so no repository maintenance is needed.
Commits must be cheap, incremental, and lock-free. In git, you commit locally and then push to share your work. In Scion, every commit, rebase, or merge happens on the server, so there’s nothing to push, but each of those operations needs to be fast. The cost of creating a commit and updating its downstream data structures has to scale with the size of the change, not the overall size of the repo, or the server can’t keep up. The development lifecycle in Scion discourages refs (pointers to commits, such as branches and tags), except for the main ref or release branches, because global state that every server has to agree on is a looming scaling problem.
The working copy is optional, and sparse by design. Because our monorepo is so large, and because we check out code tens of millions of times a day for CI, we wanted to avoid checkouts whenever we could. With Scion, a CI job that needs the diff between a commit and its merge base, for example, can ask the server for it. The same goes for writes: many write workloads can also skip the checkout and function entirely via API. Scion’s protocol is centered around sparse checkouts, which only contain the directories the client asks for, and virtualized checkouts, which materialize files on demand, so when a job does need files on disk, the client only pays for what it actually reads.
How Scion works
It’s helpful to understand how these principles came together in practice when building Scion. These insights can apply to other source control systems or, more broadly, to other stages of the software development lifecycle.
Data structures
In Scion, the unit of work is a “changeset,” an entry in a write-ahead log. A changeset stores most of what you’d expect from a commit in git. But where a git commit stores a pointer to the tree, a changeset stores a list of the files that changed relative to its first parent,1 along with content-addressed pointers to the compressed file contents in blob storage. Changesets are created server-side and are available everywhere, instantly.
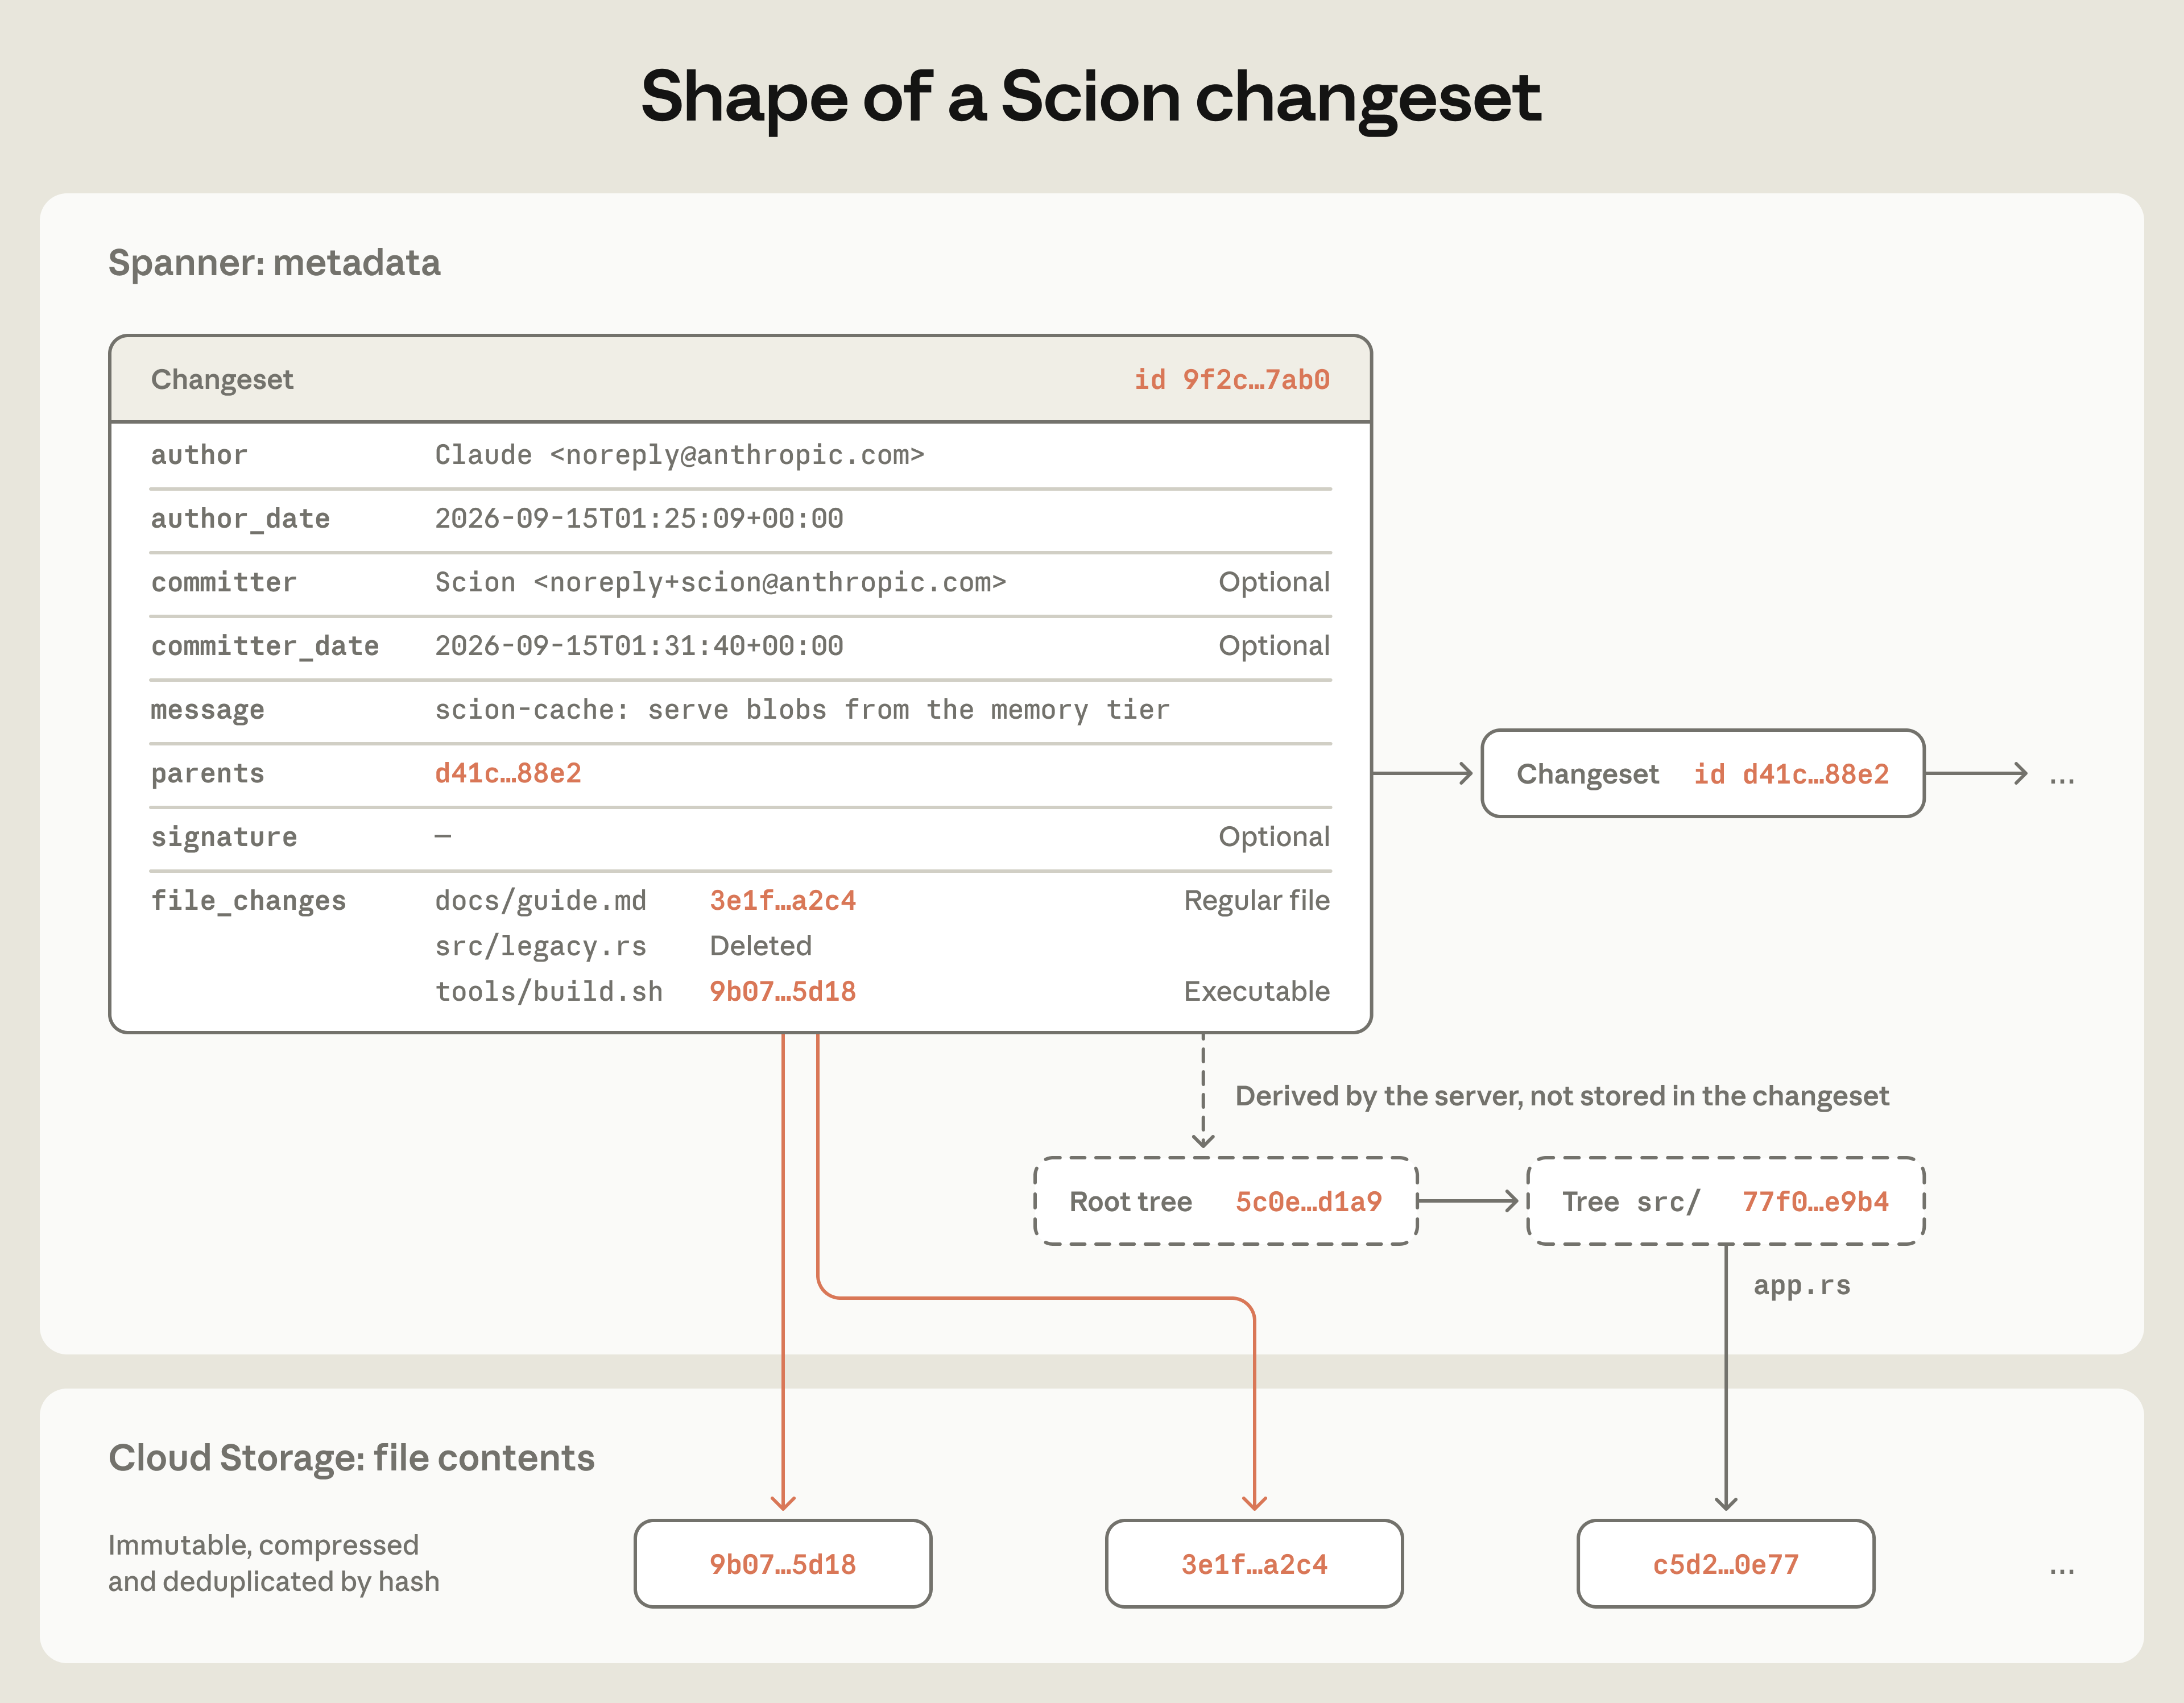
This structure lets us accept changesets with very high throughput because there are no packfiles to accept, no locking or cross-server coordination, and no refs to move around. Scion does technically support refs, but since neither creating nor fetching commits involves them, moving one is a compare-and-swap on a single Spanner row that happens separately from creating changesets.
A changeset records only what’s changed, so on its own, it can’t quickly answer questions like who last edited a line or which commits affected a file. To answer those, Scion builds additional data structures from the changesets, including dedicated structures for file blame and path history and skip lists for the commit graph. We call everything that isn’t directly part of the changeset “derived data,” and we compute it all through one generic mechanism. Each type of derived data is defined recursively, so its value for a changeset is computed from its values for that changeset’s parents.
This mechanism has three benefits. First, we can easily add a new type of derived data when a new data structure would make some operation faster. Second, for each type, we can choose whether to compute it eagerly or defer the work, so we avoid materializing data we don’t need. And third, because the client never sees the internals of these data structures, we can optimize them without changing the client. We’ve added new types of derived data many times as the system has grown, such as new indices for performing copy detection or path-based file search.
Scaling Scion
A small fleet of Scion servers provides source control APIs for any operation a client needs, such as getting changesets, computing diffs, finding merge bases, and fetching blobs. All source control data is content-addressed, so a piece of data never changes once it’s stored, and any server can cache it without checking with the others. As a result, the servers are horizontally scalable and require little coordination. They are essentially large caches that can also compute derived data on the fly and write the results back to Spanner.
Scion’s many consumers no longer need to maintain local repositories of their own. Fetching and maintaining the repository used to be a significant maintenance burden for CI jobs or tools that needed to ask source control questions, particularly about commit ancestry and blame. Early in the migration, before we had our own client, repo format, or protocols, Scion only answered these “metadata” queries. Fetching file contents and materializing working copies are far more data-intensive operations, and they needed a design of their own.
Scion’s scn client deviates from git’s fetch protocols in several important ways and, as a result, lends itself to a highly scalable architecture that requires significantly less CPU than git servers. Scion’s negotiation doesn’t tell the server what the client already has; instead, it operates exclusively on trees and blobs the client wants. Starting from a root tree, the client checks its local store for missing trees and requests them recursively, then repeats the process for blobs. Every request is for a specific object that never changes, so any cache can answer it, and the architecture closely resembles traditional tiered caches. The process is also efficient and resumable, because there is no single multi-gigabyte packfile response. Sparse and even virtualized checkouts don’t need special support, because the client simply doesn’t ask for trees it doesn’t want.
In the fleet, the client talks over a socket to a daemon, scion-daemon, that stores objects for the whole node. Most of our nodes need access to the monorepo, and jobs on the same node reuse most of the same objects. Each daemon starts from a periodically refreshed snapshot, then talks only to the tree and blob cache servers in its region, called scion-cache. These cache servers stream objects directly from memory, in the disk format that the daemon will consume, so they don’t need to spend time computing the client’s missing objects or performing delta compression. When a cache is missing an object, it asks the authoritative scion-servers, which read from Spanner or cloud storage as needed.
The scion-daemon, scion-cache, and scion-server all respond to identical RPCs for this protocol, so the client doesn’t need to know the cache topology. Any tier could theoretically talk to any other, but we strictly enforce the tiering to isolate failure domains. We want to avoid a situation where a failure in a regional scion-cache overwhelms the upstream scion-servers and brings down the entire system.
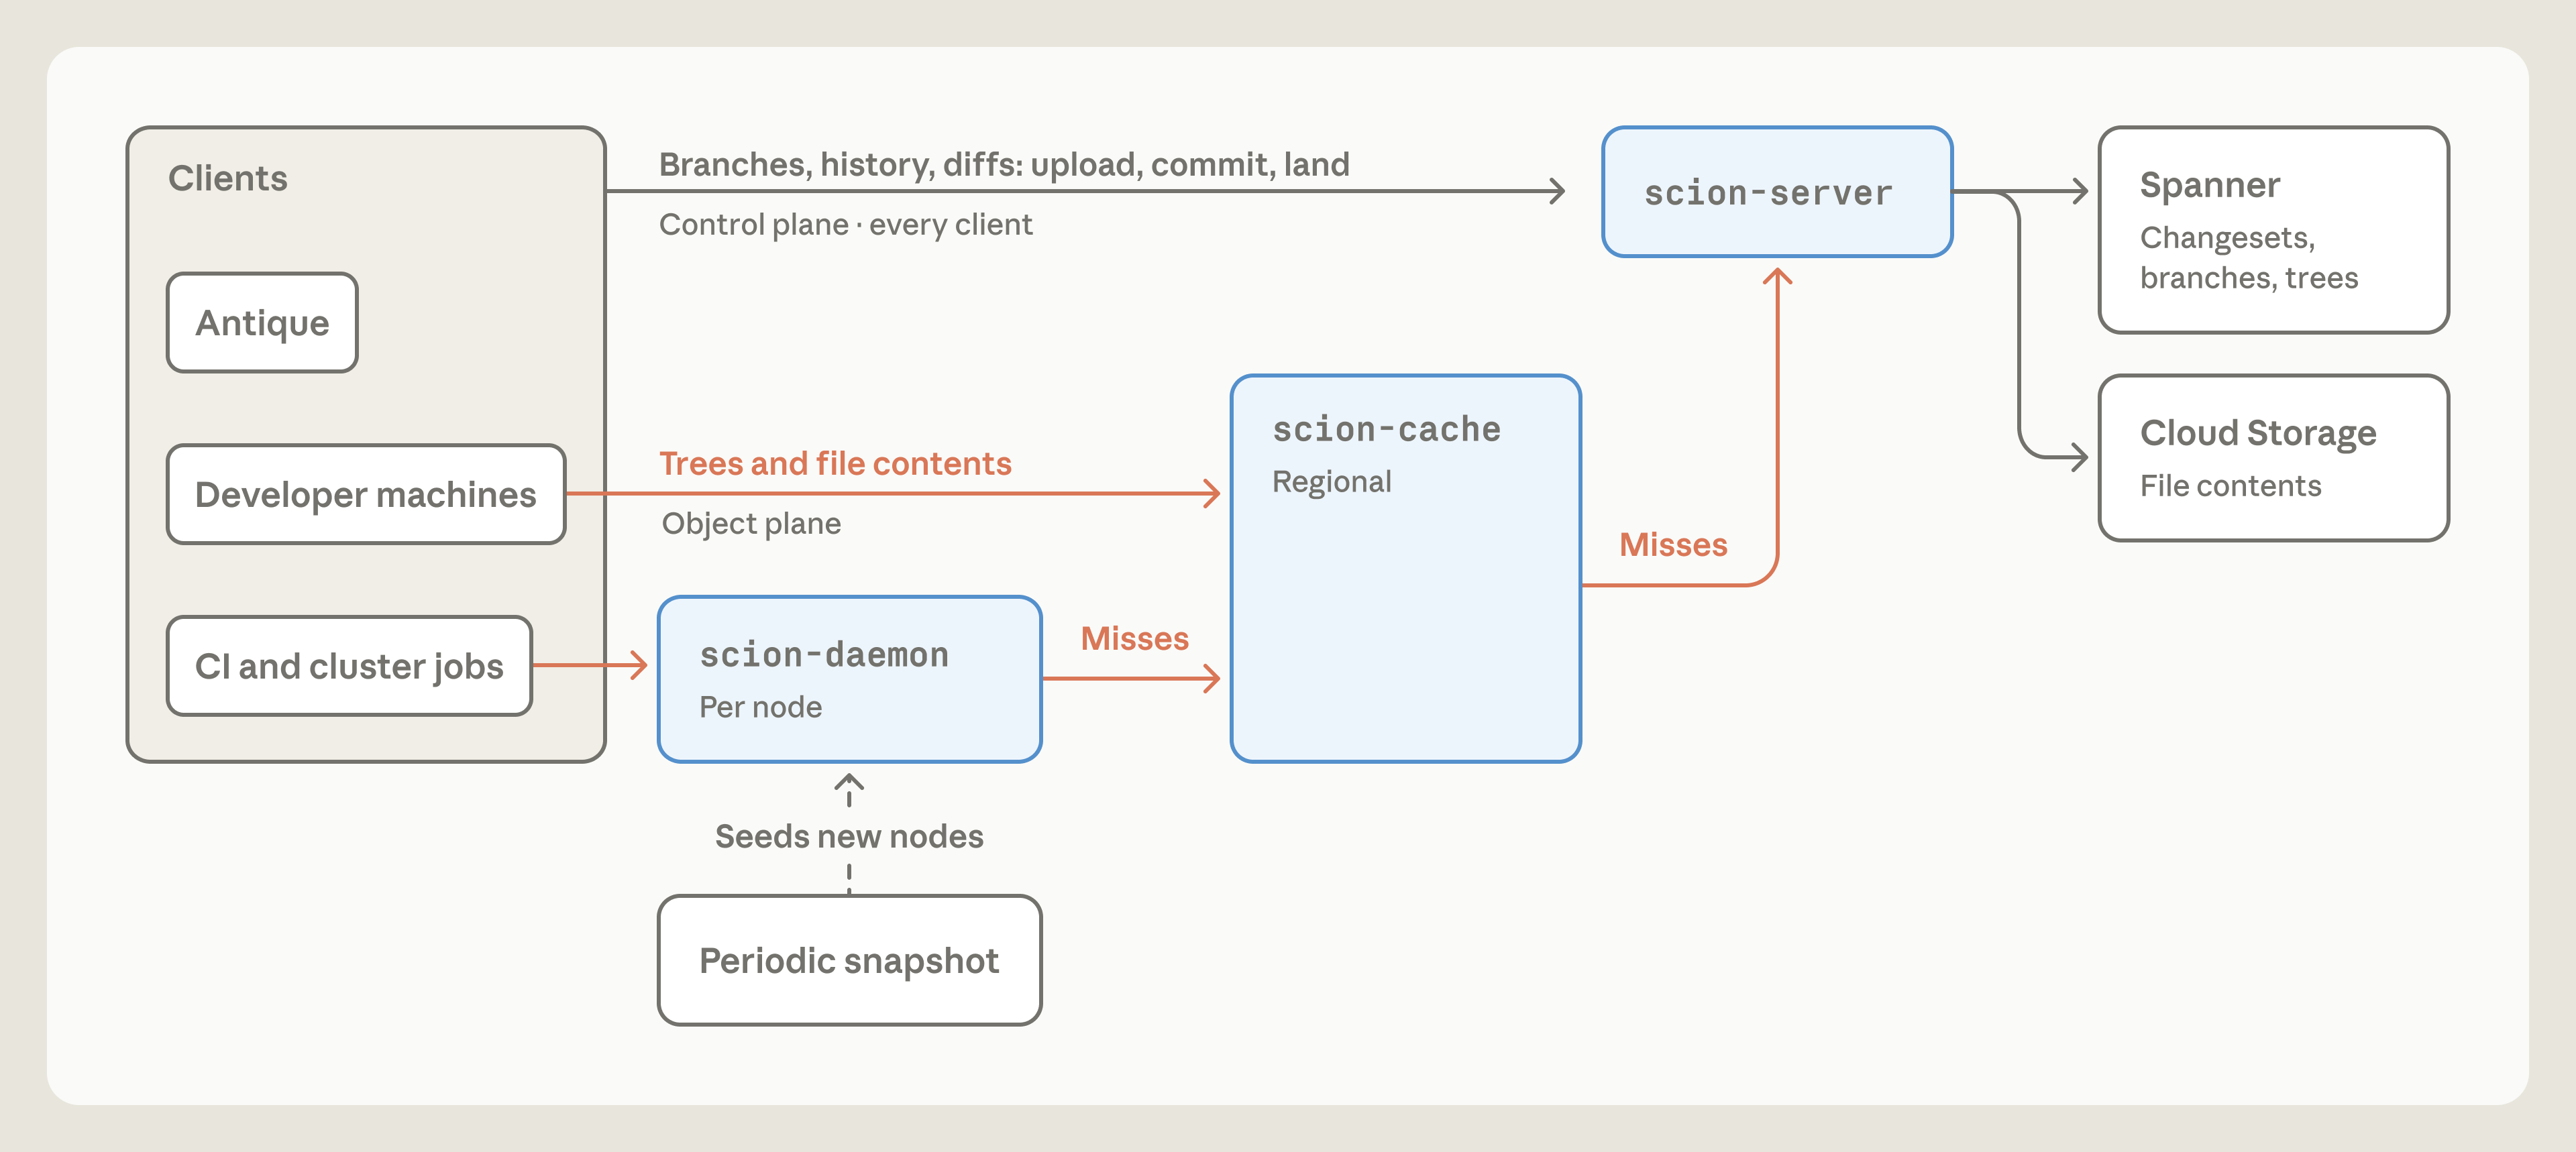
Each tier of this system maintains a cache hit rate of over 99% and does not require long-lived state, so it’s easy to scale up if needed. Our Scion infrastructure footprint is now 200x smaller than our previous git mirroring infrastructure in terms of CPU and memory requirements. CI and research jobs check out code two orders of magnitude faster (in seconds rather than minutes), which frees up a sizable amount of capacity across the fleet; CI alone realized a 25% CPU capacity win. Neither clients nor caches need to perform repository maintenance, which simplifies the lifecycle management of our jobs.
What we learned building Scion
We started building Scion around the same time as Claude Mythos Preview and Claude Tag became available internally. Both of these releases simultaneously amplified the need for Scion and meaningfully accelerated how quickly we could build it.
Here’s a particularly striking example. Earlier in the year, we had largely handwritten the first version of the git-to-Scion ingestion pipeline as a prototype. We thought it was good—until we got our hands on an early internal snapshot of Claude Mythos Preview. We asked it to rewrite the whole thing, and with no further instructions, it produced a version that consumed 20x less memory and was 4x faster, while preserving all of the implicit invariants around ingestion ordering and data structures.
What we learned building and operating Scion offers some interesting lessons for what building agent-scale software could look like.
Rapid development with a small team will become more common. A team of seven people built both Scion and Antique (our code review tool, which we could easily write a whole other blog post about), not to mention half a dozen related systems, and fully migrated to them in five months. We did all this while the volume of code merged per day increased by 10x. In the past, developing and deploying a source control system like this would have taken a company years of iterative migration, with many more engineers. We think this sort of fast, nimble migration will become more common in the future.
Engineers are no less valuable, but their work is changing. All of the engineers who worked on this system would now rate Claude as better at writing code than them. But our engineers still supplied the invaluable understanding of the high-level inter-system components and the design-level tradeoffs, making informed choices around the problems we wanted to solve and the scale we knew we needed to achieve. Very often, we found that the role of the engineers was to tell Claude “no.” Agents will sometimes violate core system constraints to satisfy a pattern that should never have been allowed in the first place. This was particularly common in our migration. For example, there were multiple systems that tried to brute force looking up when a change merged to main by linearly reading the commit log instead of asking our code review tool. Anthropic also makes extensive use of adversarial review, and, while this is incredibly effective in many ways, it can also be myopic, so skilled engineers needed to steer Claude away from over-engineering parts of the system in response to hypothetical concerns. For example, one such review was overly defensive about trusting another internal service, which resulted in Claude adding excessive validation and complexity. Our team members still review every change request for the system, but they now examine the intent of the change as opposed to reading every line of code.
We were able to substantially improve optimization and quality. By virtue of Claude’s ability to write immense amounts of code much faster than we could ourselves, Scion is among the most well-tested and well-defended codebases we have ever worked on. Even on our tight timeline, we were able to build hermetic simulations of every non-trivial infrastructure and source control interaction we’ve ever encountered, as well as fuzzing and sophisticated rate limiting. Claude also casually found significant optimizations—for example, an algorithmic optimization to ancestry queries that missed one of our indexes—that would have taken an expert days or weeks of analysis and tuning… and then did it all again the next day.
We laid the groundwork for new forms of monorepo security. Managing safety, security, and compliance in a massive monorepo is as important as managing the size and scale. We built Scion with these in mind from the start. It supports rich access control on repositories, as well as the ability to apply permissions to individual directories in order to protect the most sensitive code without losing the benefits of a monorepo. Furthermore, the code review tooling we built can express complex semantic constraints on approvals, which lets us differentiate simple things like comment-only changes from sensitive logical changes, so that human reviewers can focus on the most consequential changes.
A new level of operational excellence is possible. Our team uses Claude Tag heavily, which has helped us monitor each component of the system. For example, we created Slack channels where we tasked Claude with being obsessively focused on the health of a single component. We call these Claudes “superfans.” We have a scion-daemon superfan, a scion-cache superfan, an Antique merge queue superfan, and so on. They have access to our telemetry and logs, and act like an experienced engineer who has nothing better to do than to refresh charts and look for anything strange. We also have traditional alerts for all of our systems, but our superfans can detect subtle and novel issues that make these alerts seem one-dimensional by comparison.
We’re completely rethinking our priors. This project prompted us to take a very hard look at other workflows designed for human scale. A proper merge queue, for example, doesn’t make much sense at agent scale. What does CI even mean when hundreds or even thousands of changes can merge while tests are running? We haven’t been able to effectively replicate the industry standard of a global repository lock on the merge queue, so instead, we’ve invested in post-merge and pre-deploy automated testing. This does mean that concurrent changes can conflict, but Claude can typically fix these conflicts faster than humans can even identify them.
Contributing to the wider ecosystem
We see Scion as just one part of the answer to the scaling concerns that increasingly capable AI agents have raised. We’re sharing these details as an example of how teams can tackle similar challenges, though we don’t expect our solution, or our considerations, to suit every case.
Scion is by no means a suitable replacement for git for general use. The concepts we’ve outlined here really only make sense for truly enormous monorepos, with either tens of thousands of engineers or swarms of agents prolifically writing code. Plus, Anthropic is unique in that our ability to spend tokens for internal use far exceeds what any other business would realistically want to spend. We do this both to address our own software development needs, and to test Claude’s capabilities.
Practically speaking, it’s difficult to offer Scion in a form that would be broadly useful to other organizations. It diverges significantly from git, meaning companies would need to migrate every piece of the development lifecycle, and it requires its own code review, code search, and CI. Our internal versions of these components are highly bespoke, so they would be difficult for other organizations to adopt, and we worry that attempting to build a public version that tries to please everyone wouldn’t actually be very useful.
However, we anticipate that this class of problems will become more commonplace over the next six to 12 months, and it would be an inefficient use of engineering resources for every company using git to face similar challenges alone. Given that, we think the most impactful thing we can do is to share our thinking, so that other developers can apply some of the most successful parts of Scion to git without departing from the overall model. A git server doesn’t have to work the same way as a git client does; novel server architectures exist that provide significant scaling improvements. Git platforms can provide comprehensive server-side RPCs like Scion, perhaps even in a standardized way across forges that the git client can learn to talk to. The negotiation protocol doesn’t have to look exactly like it does today, either, and the various sparse and shallow features in git can be made to compose well.
Lastly, we want to acknowledge that the git community has spent nearly two decades scaling the platform for millions of developers. Our contribution is far narrower: sharing our early view into how agentic software development interacts with these systems, so that we can partner with GitHub, GitLab, and the OSS community to support the changing needs of developers. We’re all in it together as the software development lifecycle intersects with the AI exponential.
Acknowledgements
Written by Nick G. and the source control team: S.G., R.K., Dan C., Garrett H., Ben L., Colin M., Joe P. We’re grateful to Vilas J. and Sergiu D. for supporting the source control team on this ambitious journey and Amir O. for early contributions to Antique.
Footnotes
- Storing changed files relative to the first parent of a merge is a stylistic choice; in practice, we’ve found that people only care about history or blame for commits on the main line in trunk-based development in a monorepo.