
技术分析机构 SemiAnalysis 测试发现:Anthropic 才是最大慈善家,Claude 订阅等效 API 价值是 OpenAI 的 5 倍多…
SemiAnalysis 实测:主力模型额度拉开差距,旗舰与高价套餐背后,是两家收回算力补贴的不同方式。
如果把 AI 订阅看成厂商给用户发算力补贴,Anthropic 这次更像“慈善家”,OpenAI 则正在把优惠收回去。
技术分析机构 SemiAnalysis 的订阅测试显示:在主力模型 Opus 5.5 与 GPT-6.1 Sol 的比较中,同样交月费,Claude 给出的 API 等值约为 OpenAI 的 5 倍多;即便不按 API 标价折算,只看 token 总量,Claude 给得也明显更多。(API 是程序调用模型的接口;token 是模型处理文本的计量单位。)
换成旗舰 Fable 5.1 与 GPT-6 Astra,两家的单项额度接近,但 Claude 还有一层余量:如果此前没用其他模型消耗共享额度,把 Fable 用到它的上限后,还剩一半总额度可用其他模型;Astra 用完对应额度,OpenAI 这组套餐的额度池也就见底了。
与此同时,OpenAI 把 200 美元档的 token 额度砍掉约一半,又推出 500 美元档。月费贵了不少,每美元能买到的量却没有更划算。
这篇分析真正揭示的,是 AI 厂商一边靠订阅补贴吸引用户,一边想办法把补贴收回来。Claude 的主力模型仍给得大方;OpenAI 则直接动了套餐总额度。
同样交 200 美元,Claude 到底多给了多少?
先看两家作为日常主力推广的模型。按 SemiAnalysis 的 Agent 工作负载、用满额度来折算:
| 每月 200 美元 | Claude Max 20x · Opus 5.5 | ChatGPT Pro 200 · GPT-6.1 Sol |
|---|---|---|
| 月度 API 等值 | 约 11,726 美元 | 约 2,084 美元 |
| 月度总 token | 约 286 亿 | 约 102 亿 |
同样的月费,API 等值相差约 5.6 倍,token 总量相差约 2.8 倍。20 美元和 100 美元档的这组主力模型比较,API 等值差距也在 5 倍多。


“API 等值”可以理解为:把会员额度支持的调用量,按同一模型的 API 价目表买一遍,大概要付多少钱。它不是能提现的余额,也不是厂商为你花掉的真实成本。不同类型的 token 要乘以各自的单价,再加起来。
所以,5.6 倍里面有两个因素:Claude 给的量更多,Opus 的 API 标价也更高。只看价格,会把这两件事揉在一起;改看 token 总量,差距仍然很大,说明这次优势并不全是“标价高、折出来好看”。
这组工作负载约 96.6% 的 token 是缓存读取。Agent 跑代码、看报错、改文件时,会反复带上此前读过的代码和对话;缓存让模型复用这些已处理的上下文,降低重复读取成本。累计读了十遍旧代码,不等于写了十倍新代码。
因此,这张表回答的是重度 Agent 使用能拿到多少调用空间。能多完成多少工作,还得看同一个任务谁做得更好、谁让你少返工。SemiAnalysis 也指出,行业缺少能可靠反映真实工作中 token 效率的数据。
同一个套餐,聊天和跑 Agent 为什么能差这么多?
这不是套餐自带的一张固定美元券。同样是200美元的Max 20x,换模型、换用法,API等值能从约2,500美元变到约12,500美元。
以Sonnet为例,Agent负载等值约12,529美元,聊天负载约7,009美元;Opus则约11,726美元和9,200美元。Fable两种用法都在约2,480美元附近,差距很小。模型与工作负载会一起改变结果,不能把“Agent更值钱”套到每款模型。
原因在两套费率:订阅按不同模型、不同token类型扣额度,API也按类型收费,但两者的收费比例不完全相同。Agent反复读旧上下文,在这组估值中缓存读取占96.6%;聊天负载约75%,生成输出则从Agent的约0.3%提高到10%。配比变了,同一额度能支撑的调用组合及其API价格也就变了。

旗舰模型接近,但“用完”的含义不一样
200 美元档里,Fable 5.1 的 API 等值约为 2,485 美元,Astra 约为 2,897 美元。只看这一行,OpenAI 还略高一些。
100美元档也接近:Astra约1,322美元,Fable约1,273美元。20美元档则不对称:ChatGPT Plus包含Astra的额度,Claude Pro不包含Fable,不能把高档旗舰的比较直接套到入门档。

关键是,Fable 的上限只能消耗 Claude 总周额度的 50%。你专门用 Fable,把这份旗舰额度用满,触到的是它自己的子上限;另一半共享额度仍能交给 Opus 或 Sonnet。
可以把它想成一个总额度池,里面规定“旗舰最多取一半”。旗舰那一份用完,不等于池子空了。Astra 在对应的 OpenAI 套餐里用到上限,则会把这组共享额度耗尽。
剩下的“50%”是额度份额,不是又送你 2,485 美元,更不是还能继续用同样多的 Fable。其他模型的扣额度费率不同;如果之前已经用 Opus 消耗了共享池,剩余份额也会变少。
对会在多个模型之间切换的用户,这个差别很实际:难题交给旗舰,日常修改和测试继续交给主力模型,旗舰触顶后还有工作空间。上一张表中 Opus 给得多的优势,也就有了用武之地。
OpenAI 这一刀,砍掉的是旧 200 美元档的优惠
SemiAnalysis 跟踪到的调整,直接体现在新旧套餐读数里:
| 200 美元档的变化 | 调整前 | 调整后 |
|---|---|---|
| Astra 月度 token | 约 38 亿 | 约 19 亿 |
| Astra API 等值 | 约 5,734 美元 | 约 2,897 美元 |
| Sol 月度 token | 约 196 亿 | 约 102 亿 |
| Sol API 等值 | 约 5,904 美元 | 约 2,084 美元 |
Astra 的量和等值都少了约 49%。Sol 的 token 少了约 48%,API 等值却少了约 65%。后者还叠加了 GPT-6 Sol 换到 GPT-6.1 Sol 时的缓存 API 降价,不能把 65% 全算成砍额度。旧用户暂时保留原有额度,新开通用户直接执行新额度。

再看 500 美元档:月费比旧 200 美元档贵 150%,Astra 的量却只多约 21%。这里比较的是调整前的旧 200 美元档。拿它与已经砍过的新 200 美元档比,当然会显得增量大得多。
Sol还有另一组反差:新500美元档的token约263亿,比旧200美元档的196亿多约34%,API等值却从约5,904美元降到5,386美元,少约9%。量增加但标尺降得更多,再次说明等值不能直接当调用量。

500 美元档的另一项卖点是 300 TPS 的 Ultrafast 输出速度。(TPS 指每秒生成的 token 数。)更快地拿到结果可能有用,但速度要单独算价值;SemiAnalysis 当时仍在测试这项功能的限额。
以前的 Pro 200 是一个“买贵档、每美元还能拿更多量”的优惠档。调整后,Pro 100、200、500 对同一模型的每美元 token 数已经相近:多付钱主要是买更多总量,或买速度,而不是换到更低的用量单价。Claude 各订阅档位的每美元价值本来也接近,主力模型的补贴力度则仍明显更大。
看每美元价值图时,横轴是每美元token数,越往右量越多;纵轴是API等值除以月费,越往上按量购买时的账面优惠越大。横轴用了对数刻度,相同距离表示倍数变化,不能把视觉距离当成等量差。

Plus也要分模型看:Sol的每美元价值与Pro接近,Astra则较低。以前Astra的Pro 100每美元价值约是Plus的两倍,旧Pro 200又在Pro 100之上多约一倍;这一层高档优惠如今被收回。

在两家比较图里,Sonnet和Opus的API等值约为月费的57–63倍,OpenAI Sol约10–11倍;Fable则只有约12–13倍,与Astra的约13–15倍接近。同一厂商的不同模型也不在同一个补贴档,不能把主力模型优势改写成每款模型都碾压。
OpenAI 也有一个不能漏掉的优势:它的 Pro 套餐没有 5 小时上限。Claude 即使周额度还有剩余,也可能先撞上短时限制。对需要连续集中跑任务的人,“总量多”与“这几个小时能不能用到”是两回事。这也是为什么单看总额度,不能替每个人直接选套餐。
占了四成算力,只带来一成收入,厂商为什么还愿意?
用户觉得会员划算,另一面就是厂商让出了大量按量收费的收入空间。
SemiAnalysis 对 Anthropic 的粗略估算很直观:订阅占用约 41.7% 的推理算力,只贡献约 10% 的收入;API 占用约 58.3% 的算力,却贡献约 90% 的收入。

在这组估算里,订阅每兆瓦算力带来约 1,600 万美元收入,API 则约为 1.029 亿美元。相同的算力资源,用在 API 业务上,能收回更多钱。
把两类业务混在一起,每兆瓦收入约6,670万美元,比纯API那一栏少约3,620万美元。这是算力被分配到不同收入效率业务后的结果,不是已经亏掉3,620万美元。
这解释了为什么订阅会拉低收入效率,也解释了厂商为何盯着会员额度。但它不等于“所有订阅都大赔本”:这张图估算订阅毛利仍约为 50%,只是远低于 API 的约 92.2%。补贴重、少赚很多,与整体已经亏损,是不同的结论。
厂商愿意这样做,是因为月费低、可反复尝试的入口,能让开发者和小企业更容易开始使用,把模型放进日常工作。订阅不仅是一笔调用收入,也是获客和推广。先让用户建立使用习惯,再想办法改善每个用户的收入与成本,这就是这些限额变化背后的生意。
SemiAnalysis还把此前Codex采用增长,部分归因于OpenAI慷慨的额度重置;它认为,这种竞争压力也促使Anthropic撤回过一些削减订阅权益的计划。这是机构对竞争效果的判断,也能解释为什么补贴不能只按一笔调用的盈亏来算:少给一点可能省了算力,却失去用户和口碑。
两家都想少补贴,动刀的位置却不同
Anthropic 的做法,是让更强、更贵的旗舰模型拿到更紧的配额。Sonnet 和 Opus 按 API 标价折算,补贴倍数都很高;到了 Fable,这个倍数明显下降。
旗舰单次调用更贵,但用户能用的量也更少。把配额收得足够紧,旗舰套餐反而可以比主力模型的宽松额度更赚钱。
SemiAnalysis 用“API 毛利 92%”的假设,推算了 Max 20x 下两种使用情景:
| 使用情景 | Opus 5.5 推算毛利 | Fable 5.1 推算毛利 |
|---|---|---|
| 各自可用额度用满 | 约 −369% | 约 1% |
| 只使用各自额度的 20% | 约 6% | 约 80% |
这些是情景推算,20% 也是假设利用率,不是已经测到的用户平均值。以 Opus 为例,11,726 美元的 API 等值,在 92% API 毛利假设下对应约 938 美元的服务成本;把它用满,200 美元月费盖不住成本。只用两成,成本变成约 188 美元,毛利才回到约 6%。
Fable 的可用额度更紧,同样的算法算下来,两成利用率时成本约 40 美元,对应约 80% 毛利。Fable 更强、更贵,订阅毛利却可能更高:关键是配额更紧、补贴更少,不能只盯模型单次成本。
这组推算还有一个很关键的分界点:Max 20x的Opus大约用到21%的额度就会触及盈亏平衡,Sonnet约20%;Fable的子额度用满时则仍接近盈亏平衡。这也说明,厂商利润很依赖用户实际用掉多少额度。
Fable这一列只计算Fable子额度的使用。如果再用Opus把另一半共享池消耗掉,服务成本还会增加,不能把80%直接当成这名用户整份套餐的实际毛利。

同一组假设下,调整后的 OpenAI Pro 200 用满 Sol,推算毛利约为 17%;用满 Astra 则约为 −16%。压低可用总量,能让厂商收窄重度用户带来的成本风险。
Astra在新Pro 200里要用到约86%额度才触及盈亏平衡,相比Opus约21%的分界点,OpenAI对重度使用的成本缓冲大得多。这里对照的是同一成本假设下的情景,不是两家公司披露的实际订阅毛利。

Anthropic 是通过旗舰与主力模型的额度分配逐步收回补贴。OpenAI 则直接把旧 200 美元档的总额度砍掉约一半。对用户来说,前者表现为“强模型给得紧、日常模型还能多用”,后者表现为“同样的月费,可用总量突然少了”。
这也不意味着Claude会永远保持今天的补贴。SemiAnalysis预期,Anthropic继续降低Opus的服务成本后,主力模型的宽松额度会更容易维持;更高层级的新旗舰则可能给更紧的限额,甚至不进入订阅。这是它对未来产品分层的推测,尚不是已宣布的政策。
对于OpenAI这次降额没有引发很强反弹,机构猜测,发布活动的正面消息和老用户暂时保留旧额度共同缓冲了反应。这能解释反弹为何可能延后,不能据此断言公司刻意用发布会掩盖降额。
API 降价了,会员为什么没有自动拿到更多量?
厂商还有一把更容易被忽略的尺子:API 价目表。
API 降价,意味着程序按量调用更便宜。订阅能多用多少,却由另一套扣额度规则决定。两套规则没有必须同步调整的承诺。
Opus 5.5 就是一个例子:图表中,它的 Agent 混合 API 单价下降约 46%,Claude Max 20x 的 token 额度增加约 25%,但 API 等值仍下降约 32%。用户实际拿到的量增加了;只是用 API 买相同调用量也便宜了,所以会员折算出来的“值多少钱”反而下降。
同一模型在不同套餐里的补量也不一样:Claude Pro的Opus额度增加约51%,API等值仍下降约18%;Max 5x额度增约20%,等值降约35%。Fable的Max档额度仅增约1–4%,等值降约46–47%;Sol在Pro 200里额度增约5%,等值降约28%。

Fable 和 Sol 在相应新版本里的 token 额度只有小幅增加,也没有抵消 API 降价。因而,“API 等值缩水”可能是少给了量,也可能是标价降了,还可能两件事一起发生。OpenAI 的新旧 200 美元档比较,正好把这两种变化叠在了一起。
额度增加,账面等值也可能下降
假设旧额度与旧 API 等值都为 100%,改变两个条件,看它们怎样一起影响结果。数字为算术示意。
等值比例 = 额度比例 × API 单价比例
默认算例:1.2 × 0.5 = 0.6;不代表任何实际套餐。改变单价时保持 token 类型比例不变。
订阅后台的规则甚至可以在套餐名称、月费都没变时调整。SemiAnalysis 测过某个未具名供应商的三个同款订阅账号,其中一个额度低约 20%;联系厂商后确认,它参加了小范围的限额 A/B 测试。
这也解释了它为什么要持续测量:会员的“100% 额度”不对应永久固定的 token 数量。厂商改变某种模型、某类 token 的扣费率,你能用到的量就会变化。
国产套餐也在补贴,但平均数藏着很大的差别
公开图表还比较了 MiniMax、Z.ai 和 Moonshot。按各自模型的 API 标价折算,MiniMax M3 约为月费的 19–24 倍,GLM 5.3 约 8–12 倍,Kimi K3 约 2.5–6.7 倍。

所以,“国产套餐平均补贴多少”不如先问“具体是哪款模型、哪个档位”。这些套餐整体上有高档每美元价值更高的趋势,但并不是每个档位都严格递增。API 价格本来就低的模型,折出的倍数也可能低,即使它给的 token 很多。
MiniMax的Max档月费55美元,等值约1,305美元,即23.7倍;Ultra档月费132美元,等值约3,088美元,即23.4倍。更贵档给的总量更多,每美元优惠却没有继续提高。GLM 5.3则从Lite的约7.7倍提高到Max的约11.6倍,Kimi从Plus的约2.5倍提高到Ultra的约6.7倍,各家的阶梯形状不同。

GLM Flash尤其能说明“token多”和“补贴倍数高”不是一回事:同样168美元的Max档,GLM 5.3约63亿token、1,942美元等值,Flash约191亿token、336美元等值。Flash给了更多token,但它的API本来就便宜,所以等值倍数只有约2倍。在归一化图上,它因此落在右下方,而不是左下方。(这张跨厂商图的横纵轴都是对数刻度。)
这些数值比较的是各自套餐相对于各自 API 定价的优惠程度。换到不同模型之后,任务能不能完成、需要多少轮调用,还得另做比较。
看不到后台价目表,这些额度是怎么测出来的?
SemiAnalysis测的不是“发了多少条消息”,而是每类token会让订阅用量表走多少。它持续跟踪模型、套餐、促销和工作负载:套餐名一样,后台扣额度费率仍可能变化。
第一步,把新输入、缓存写入、缓存读取、生成输出分开测。新输入每次换随机前缀,避免命中缓存;写入实验在这个基础上标记缓存;读取实验固定前缀,第一轮写入,后续反复读。输入类实验使用《战争与和平》的片段,并尽量压低回答长度;输出实验则用短提示要求生成长技术文章。实际请求总会夹带少量其他类型token,测试再扣除它们的消耗。
第二步,处理用量表的取整误差。请求结束时才读表,真实消耗可能刚好跨过1%的门槛,也可能早已跨过一截。因此,不能拿某一次跳表的读数当精确费率。原图用“每次8K token、实际约21K token消耗1%”作示意:单个观测步可能是16K或24K,多步平均才接近真实比例。测试丢掉开头和结尾的不完整步,增加完整步骤,直到测量区间收窄至约±5%。如果读了5亿缓存token仍不跳表,它把缓存读取按免费处理——这是测量假设,不是厂商承诺永远免费。
第三步,同时看短时、总周额度与旗舰子额度。Fable新输入的原图示例中,每100万token消耗5小时额度约3.3%、全模型周额度约0.88%、Fable周额度约1.76%;反推可装下的量,分别约为3,000万、1.13亿和5,700万token。
这三个数不能相加。短时表重置了,周表仍累计;旗舰表满了,旗舰也要停。所以,不能把每5小时的量无限乘下去推算月额度。图中按一个月约4.345周,用Fable每周5,700万输入token折算,得到约2.47亿月输入token;这是隔离输入类型的测量例子,与前面混合了大量缓存读取的总token量不是同一个数。
最后,按指定工作负载混合四种扣额度费率,再乘API价。Opus的例子中,200美元月费除以混合套餐费分摊约0.00699美元/百万token,得到约286亿token;按同一配比的混合API价约0.4099美元/百万token估值,得到约11,726美元。订阅扣额度规则与API价目表的比值,才决定这笔优惠。
上下文长度也要保持可比。一些模型在超过特定上下文长度后API更贵,测试把请求控制在高价门槛以下;不能把长上下文的更高标价拿来给短上下文调用估值。原API截图展示了短、长上下文两套价格,这正是比较时需要固定的条件。
查看额度测量与折算的7张原图


回到你的月费:如果常用 Opus 跑重度 Agent 工作,而且能用掉相当一部分额度,这组测试给出了很明确的判断——Claude 的主力模型订阅仍是一笔更大的算力补贴。如果只用旗舰,或最在意连续工作的短时限制与输出速度,就要把 Fable 的子限额、OpenAI Pro 的使用节奏和速度一起算进去。
记录自己常做任务的完成情况与返工时间,核对缓存有没有真正命中,比把理论等值当成已经省下的钱更有用。看懂厂商怎样给补贴、怎样收回补贴,也就能分清:你正在为模型能力、可用总量,还是等待时间付费。
Claude 主力订阅的 API 等值为何是 OpenAI 的 5 倍多?
如果把 AI 订阅看成厂商给用户发算力补贴,Anthropic 这次更像“慈善家”,OpenAI 则正在把优惠收回去。技术分析机构 SemiAnalysis 的实测揭示了一条鲜明的分水岭:同样按每月 200 美元计算,主力模型的 API 折算等值与 token 供给相差数倍;而旗舰模型看似接近的账面数据背后,更隐藏着决定实际工作连续性的“额度池”设计分歧。
API 等值是把会员可用量按该模型 API 标价重新购买的金额;它不是现金余额,也不是厂商的实际成本。
按典型的 Agent 编程负载测算,在主力模型 Opus 5.5 与 GPT-6.1 Sol 的比较中,同样交月费,Claude 给出的 API 等值约为 OpenAI 的 5 倍多;即便不按 API 标价折算,只看 token 总量,Claude 给得也明显更多。20 美元与 100 美元档位也呈现出相似的 5 倍量级悬殊。
(约 $11,726 对 $2,084)
(OpenAI 约为 102 亿)
(复用上下文降低边际成本)
这 5.6 倍的账面优势由两部分组成:一是 Claude 给予的总 token 上限本就高出近两倍;二是 Opus 的 API 官方标价更高。测试还有一个前提:Agent 跑代码和修报错时,约 96.6% 的 token 是在反复读取既有代码与历史会话,缓存让模型不必重复处理旧上下文。这组对比按该 Agent 配比估算并假设用满额度;聊天等用法的折算结果会不同。
假设此前未用其他模型消耗共享额度。200 美元档里,Fable 5.1 的 API 等值约为 2,485 美元,Astra 约为 2,897 美元,账面十分接近。但两者“用满”对实际工作流的影响完全不同:
独立子上限:Fable 的上限只能消耗 Claude 总周额度的 50%。你专门用 Fable,把这份旗舰额度用满,触到的是它自己的子上限;另一半共享额度仍能交给 Opus 或 Sonnet。
单池抽干:Astra 在对应的 OpenAI 套餐里用到上限,则会把这组共享额度耗尽。整组套餐池见底,无法降级继续调用 Sol 跑日常任务。
余下 50% 是额度份额,不是额外 2,485 美元,也不能继续调用同量 Fable。若之前用了 Opus 或 Sonnet,共享池的余额会更少;短时上限也可能先触发。
按 SemiAnalysis 对 Anthropic 的粗估,订阅占用约 41.7% 的推理算力,只贡献约 10% 的收入;API 占用约 58.3% 的算力,却贡献约 90% 的收入。相同的算力资源,API 业务每兆瓦能带来约 1.029 亿美元收入,而订阅仅带来约 1,600 万美元。
让渡巨额 API 收入空间并不等于订阅直接大赔本:测算显示订阅业务粗估毛利仍有约 50%(低于 API 的 92.2%)。作者认为,固定月费降低了开发者与小企业的使用门槛,有助于争取用户和工作流。较低的单位算力收入体现了补贴与获客的取舍。
下表毛利按 API 毛利 92% 假设计算,不是企业披露的实际毛利。两家收回补贴的位置不同:
| 对比维度 | Anthropic(精细分流) | OpenAI(总量收缩) |
|---|---|---|
| 动刀方式 | 放宽主力模型,极度收紧旗舰配额 | 直接将 200 美元档额度减半,推 500 档 |
| 旗舰逻辑 | Fable 更强、更贵,订阅毛利却可能更高:关键是配额更紧、补贴更少,不能只盯模型单次成本 | 月费比旧 200 美元档贵 150%,Astra 的量却只多约 21%,高档单价优势不再 |
| 毛利防线 | Opus 用满推算毛利约 −369%(需 21% 用量平衡),只算 Fable 子额度,用满毛利约 1%;再用剩余池会增加成本 | 新 200 档 Astra 盈亏平衡点推至 86%,大幅收窄重度亏损敞口 |
重度开发者如何选择?
- 选择 Claude Max:如果你的任务适合 Opus/Sonnet,且主要受总量限制,这组实测中 Claude 的主力调用空间更大。仍需检查 5 小时上限和任务完成效果。
- 选择 ChatGPT Pro:OpenAI 也有一个不能漏掉的优势:它的 Pro 套餐没有 5 小时上限。若任务极度依赖数小时内的高密度爆发输出、不容忍短时频控打断,可考虑 Pro。500 美元档标示约 300 TPS 的 Ultrafast;速度不等于额度,其限制仍在测试。
注:评测中的“API 等值”是基于标价体系折算的理论空间,并非现金结余。日常开发应以任务返工率、实际缓存命中率及完成效率为准,避免落入单纯盯住账面虚拟等值的数字陷阱。
Anthropic Subscriptions Offer 5x+ More Value Than OpenAI
Limit testing every AI subscription plan from Anthropic, OpenAI, Meta, SpaceXSI, MiniMax, Moonshot, Z.ai, Cursor, and Cognition
Subscription plans are still the primary way consumers and small businesses pay for AI. These plans are highly subsidized—as we previously explained in June—but can still make economic sense as powerful customer acquisition and marketing tools. For example, the goodwill engendered by OpenAI’s generous resets is partially responsible for the recent surge in Codex adoption and has forced Anthropic to repeatedly walk back planned subscription nerfs to avoid getting clobbered in the court of public opinion.
Furthermore, because subscription plans are so heavily subsidized, they can also have a large impact on margins and revenue per MW despite only being a small portion of total revenue. Consider the following rough numbers for Anthropic.
Despite being just 10% of overall revenue, subscriptions can take up over 40% of inference compute and lower blended revenue per MW by ~$36M. Subscriptions are even more important for OpenAI, as they make up a larger portion of their total revenue. For specific numbers, see our Tokenomics Model.
In other words, if you want to accurately model AI lab financials, you need to understand their subscription limits.
So how do limits actually work? The way to think about subscriptions is that your monthly payment grants you some numbers of “credits”. Each (model, token type) combo consumes a different amount of credits. Because credit cost ratios can differ dramatically from API price ratios, the “value” of the same plan changes depending on what model and workload you’re running. Put differently, it doesn’t make sense to say a plan is worth $X in isolation—you need to consider the full (plan, model, workload) tuple.
Here’s how the API-equivalent value of the same $200/month Claude plan changes depending on the model and workload.
A single static snapshot isn’t enough either. Labs publicly change their limits all the time with promos and new model releases. They can also silently change limits whenever they want by tweaking credit costs. Ideally, you’d re-check the cost of each (plan, model, token type) daily so you can surface any changes in real-time.
This is exactly what SemiAnalysis has done with our new Subscriptions Dashboard available exclusively to Tokenomics Model subscribers. Besides every OpenAI and Anthropic subscription, we also track Meta, SpaceXAI, Cursor, Cognition, Z.ai, MiniMax, and Moonshot.
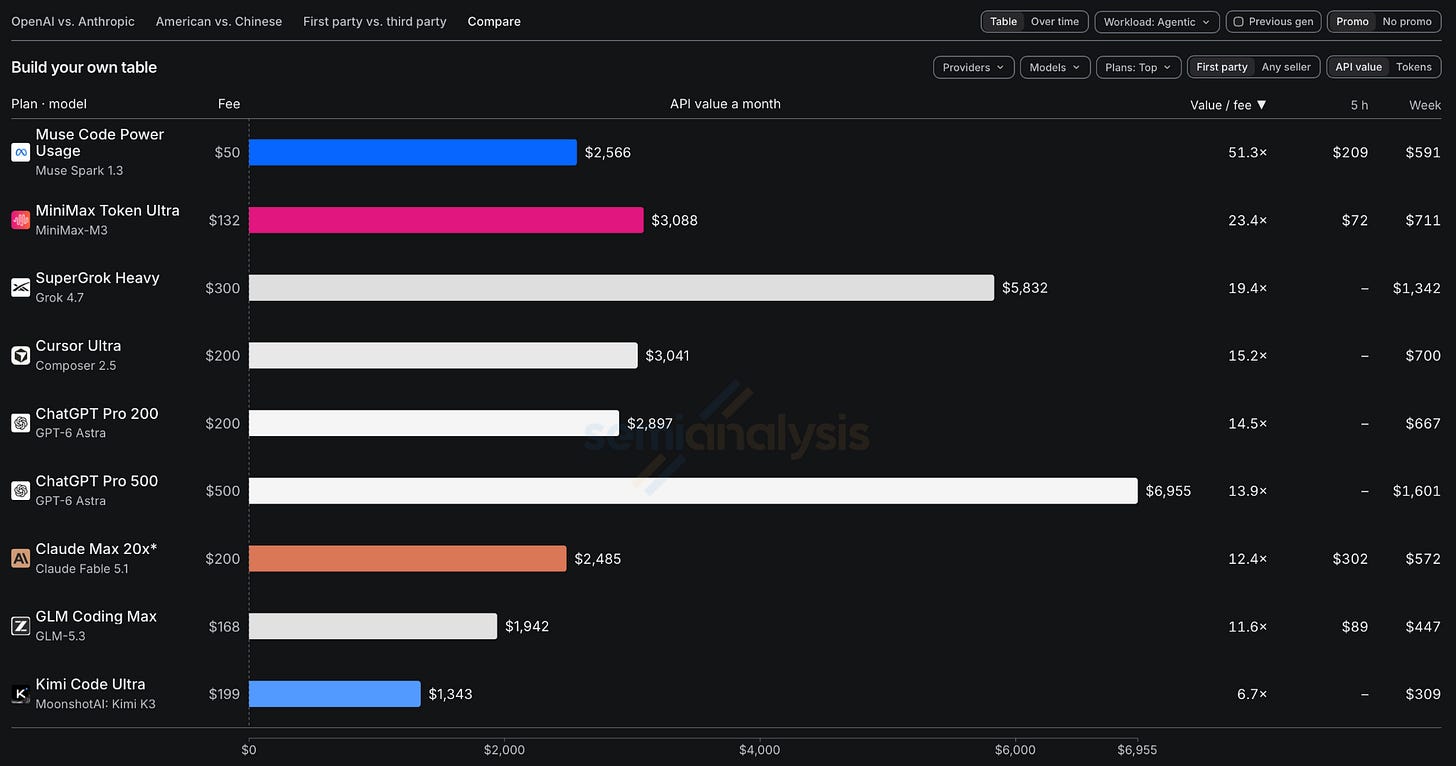
New providers, plans, and models will be added as soon as they’re released. The rest of the article will give an overview of everyone’s current limits. All token and dollar amounts below assume agentic usage unless otherwise specified.
Tokens are generally priced per MTok (million tokens) across the following types:
- Input: Fresh tokens added to the LLM’s context window that aren’t cached
- Cache write: Input tokens that are cached for multi-turn conversations. Generally slightly more expensive than regular input tokens.
- Cache read: Tokens from previous turns that are already cached in the conversation. Generally extremely cheap compared to uncached tokens.
- Output: Tokens generated by the model. The most expensive token type.
Additionally, some models charge more for tokens above a certain context window. Those models typically compact before that expensive context window is reached, so we also keep our measurements below it.
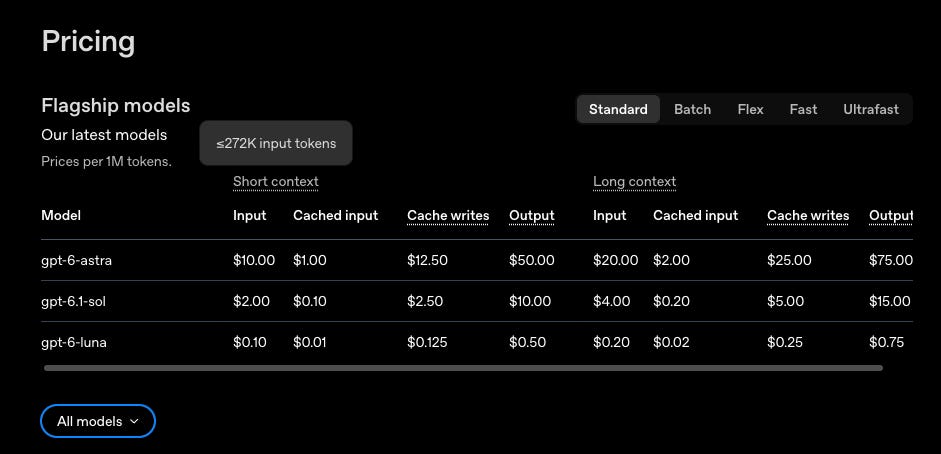
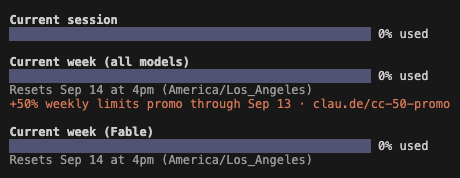
Subscription plans don’t expose this fine grained pricing. Instead, they provide a simple 0 to 100% usage meter across 5-hour and 7-day windows, and sometimes a separate meter for a model like Fable. Subscription tiers are then differentiated by usage multipliers relative only to the provider’s other plans. OpenAI for example used to advertise “Expanded Codex usage” in their $20 Plus plan, “5x more usage than Plus” in the $100 Pro plan, and “20x more usage” in the $200 Pro plan until they cut their $200 plan usage in half and removed all relative usage from their pricing page.
We compute the subscription-rate of each (plan, model, token type) triple by running experiments that isolate one token type at a time and watching how far the model provider’s meter moves. An experiment is some number of repeated calls using a specific prompt that maximizes one token type while minimizing all the others.
Input, cache writes, and cache reads share the same prompt template. We use a portion of War and Peace since some models will refuse to respond if given large blocks of gibberish. For the input token experiments, we use a random tag on every call to ensure nothing gets cached. The cache write experiments run the same way but with the prompt marked for caching, so each new tag forces a new cache entry. The cache read experiments use a fixed tag, so the first call writes the cache and every repeat reads it.
For the output token experiments, we used a technical essay to force long outputs because models will refuse mechanical prompts like “repeat SemiAnalysis 100,000 times”.
For every call we record two things: how many tokens of each type the provider billed, and what the usage meter read. Turning those into a price takes three steps.
Providers generally report usage on a meter that moves in fixed amounts. This could be a whole percentage point, a credit, a cent etc... A single request often does not move the meter at all, so the cost of one request cannot be measured directly.
Instead, we measure in steps. As requests run, we keep a running total of the tokens used. Each time the meter rises, we store that total. The tokens used between two meter moves make up one step, which is the cost of moving the meter by one unit.
We drop two partial steps. When a run starts, the meter is already part of the way to its next move, so the tokens before the first move are less than a full step and would make the rate look higher than it is. The tokens after the last move never finish a step, so we drop those as well.
To get a rate, we add up how far the meter moved over the complete steps and divide by the tokens used in them. Providers charge differently for input, output, and cached tokens, so we calculate a separate rate for each.
Caveats:
- Because we see the meter only once per request, a single step can be off by up to one request. These errors don’t add up with more consecutive steps, so we track a range instead of a single number, and the range gets narrower the more steps we count. We keep adding steps until the range is within ±5%, then report the rate across all of them.
- No request contains only one type of token. Some plans, for example, require a set of instructions on every request. We subtract that extra amount using the prices we measured for the other types.
- Reading from the cache costs almost nothing on some plans and may not move the meter at all. If the meter does not move after 500M cache read tokens, we assume that cache reads are free.
We read every meter a plan shows after every request. This could be a 5-hour limit, a weekly limit, and for models like Fable, its own weekly limit. So each token type gets a price on each meter. This is how much of that limit a million tokens uses. From each price we work out how many tokens fit e.g. if a million tokens use 5% of a limit, the whole limit holds 20 million.
The 5-hour limit resets many times within a week, so a month is capped by the weekly limits.
Lastly, we compute the API-equivalent value by converting the limit % consumed by a million tokens of each type into a dollar amount. For example, if you consume 1% of a $200 plan’s monthly limit, that’s $2.
Then, we assume a workload shape, and compute how many total tokens you can get from each plan given this ratio. For the agentic workload, we use our own usage ratios in September as reported in our Tokenomics Model.
Finally, we multiply by the blended price per MTok at API prices to get the API-equivalent value.
While refining our methodology, we ran into a very confusing situation where just 1 of 3 of the same subscription we tested for a particular provider had ~20% lower limits than the other 2. This unlucky account happened to be significantly older as well, and we were worried that the provider had some cursed setup where they changed subscription limits depending on the age of the account.
Fortunately, after reaching out to the provider, we were able to confirm this was not the case and that our unlucky account was part of an “extremely tiny” A/B test they were running on limits. Additionally, they wanted to emphasize that they “didn’t just decrease limits wholesale” and were instead testing “how to better balance when people hit limits”.
This conclusion is interesting for two reasons:
- It proves providers can silently change subscription limits at any time
- Our method is sensitive enough to detect these subtle changes!
The biggest question in AI subscription land is how Anthropic’s limits compare to OpenAI’s. Note that OpenAI just made some massive changes to their subscriptions last week, halving the API-equivalent value for the $200 plan and introducing a new $500 tier. The following numbers describe the current state of OAI vs ANT. Afterwards, we will examine OpenAI’s recent changes in depth.
Limits are quite similar across the board for GPT-6 Astra vs Fable 5.1, though remember that Fable can only be used for 50% of your limit. In other words, your $200 ANT plan would still have 50% left after consuming $2,485 worth of Fable 5.1, whereas the equivalent OAI plan would be fully exhausted after $2,897 of Astra.
This extra 50% starts becoming very relevant when we compare Opus 5.5 vs GPT 6.1 Sol.
At this mid-tier of models—which both companies market as the intended daily driver for most users—Anthropic is an overwhelmingly better deal, offering ~5x the API-equivalent value across the board. You could argue that this is unfair for OAI because 6.1 Sol is much cheaper per token than Opus 5.5, but the gap is still massive even if you switch to comparing the number of tokens.
Overall, we believe API-equivalent value is the single best number for capturing the “value” of a subscription plan, but there are times where raw token volumes can be more appropriate. For example, if a model is a particularly bad (or good) deal at API prices, then the API-equivalent value will of course be misleading.
Token efficiency is also an extremely relevant factor, but the industry unfortunately lacks reliable data here. Many people like to cite this chart from Artificial Analysis, but we do not believe the benchmark tasks in the AA Intelligence Index are at all representative of real work people do with LLMs.
Our tracking confirmed the 50% value reduction for OpenAI’s $200 plan announced by Tibo. $200 plans purchased before the cut will keep the old higher limits until October 29th, but newly purchased plans immediately start with the lower limits.
As you can see, OpenAI specifically halved the number of tokens you get for each model tier. This caused the API-equivalent value for Sol class models to drop by over 50% because OAI also cut cached input token pricing for 6.1 Sol.
The new $500 plan only offers 21% more Astra than the old $200 plan. Interestingly, the API-equivalent value for Sol class models actually decreased due to the aforementioned 6.1 Sol price cut.
Of course, 300 TPS Ultrafast was the real headline feature for the $500 plan and we are currently testing its limits. Results will be published to Tokenomics Model subscribers as soon as they’re available. We are also actively testing the limits when using your ChatGPT subscription on third party apps like Devin.
The $200/month plan also used to be significantly more subsidized than OpenAI’s other subscriptions. If we normalize each (plan, model) combo to the API-equivalent value and tokens per dollar, we can see that Pro 100 offered ~2x more per-dollar value than Plus on Astra and Pro 200 was another ~2x on top of Pro 100 across all models.
With last week’s cut, Pro 100, 200, and 500 all offer the same tokens per dollar for every model. Plus is also comparable for Sol but offers a relatively worse deal on Astra.
Anthropic, on the other hand, already offered the same per-dollar value for all of their subscription tiers and currently crushes OpenAI.
OpenAI used to be lauded by indie developers for their generous subscription limits compared to Anthropic, but this is simply no longer true today. Opus 5.5 on any Claude subscription offers far better value than anything from OpenAI.
The only counter argument for OpenAI is that none of their Pro plans have a 5 hour limit, which makes it easier to consume a higher % of your total monthly limit. However, we don’t think this offsets the ~4x higher API-equivalent value offered by Opus 5.5 on Claude plans.
We’ve seen a number of significant price cuts recently to Anthropic and OpenAI models.
One important question is whether the labs adjust token limits after these price cuts, such that the API-equivalent value of your subscription stays constant.
We already showed earlier that OpenAI didn’t change Sol token limits on the $200/month plan when they released 6.1 Sol. This caused the API-equivalent value to drop ~30%.
Anthropic also didn’t increase Fable token limits at all with the release of 5.1, but they did up Opus token limits with the 5.5 price cut.
However, the ~20% token increase for Max plans and ~50% increase for the Pro plan weren’t enough to fully offset the API price cut.
As we explained at the start of this article, subscription gross margins are way lower than API and meaningfully reduce revenue per MW for both OpenAI and Anthropic. Both companies are well aware of this fact but have chosen two different strategies for reducing subscriber subsidies.
For a given plan, Anthropic decreases the API-equivalent value for more premium models. The drop off is small between Sonnet 5.5 and Opus 5.5, but becomes very meaningful with Fable 5.1.
Reducing the API-equivalent value as you release more powerful models at higher list prices is the more subtle way to stop subsidizing subscriptions. Assuming 100% utilization and 92% API gross margins, maxing out Opus 5.5 vs Fable 5.1 usage corresponds to -369% and 1% gross margins respectively. If we were to use a more realistic average utilization of 20%, then gross margins rise to 6% and 80% respectively.
In other words, Anthropic would likely already have software like margins on their subscription plans if everyone only used Fable. Opus class models will continue to become cheaper to serve over time as Anthropic figures out how to make the model smaller, and new model tiers above Fable will have even lower subscription limits (assuming they’re included at all).
OpenAI, on the other hand, picked the nuclear option of just immediately cutting to Fable-level limits across the board.
The downside of this approach is supposed to be public backlash, but OpenAI has somehow managed to more or less avoid this entirely. It’s likely some combination of all the good DevDay PR drowning out the negative news from the day prior and grandfathering existing plans for an additional month.
Despite being compute poor, the Chinese labs still offer subsidized subscription plans, but the level of subsidization varies dramatically between models.
Here’s how they compare to OpenAI and Anthropic after normalizing per dollar.
Value per dollar increases as you buy higher tier subscriptions from the Chinese labs. On average, the API-equivalent value per dollar is a little less than the ~12x you get from OpenAI.
The final comparison we’ll consider is OpenAI and Anthropic models on their own first party plans vs third party wrappers like Cursor and Cognition (Devin).