
Claude 正在自己训练自己 Anthropic称:超过八成生产合并代码由Claude编写
Claude 已经接手代码、排障和实验。Anthropic 用内部数据追问:AI 何时能自己决定研究方向,完成递归自我改进?
Anthropic 生产代码库里,新合并的代码行已有超过八成由 Claude 编写。它还曾在两小时内排查出让数万项训练作业崩溃的故障,并在给定研究问题后自己设计、运行实验。造下一代 AI 的工程和研究工作,正在交到 AI 手里。接下来的问题更大:下一代 Claude,能不能主要由 Claude 自己造出来?
Anthropic 在《When AI builds itself》中把这条路称为“递归自我改进”。文章从 AI 开发方式的五代演进讲起,拿公开评测和此前未披露的内部数据,说明 Claude 如何加快写代码、排故障、做实验;也追问它何时能接过选题、判断结果和设计后继模型的工作。由此,未来分成三种走向:能力增长放缓但广泛普及,人掌舵而 AI 持续加速研发,或者 AI 真正完成一代改进下一代的闭环。如果研发跑得太快,各家实验室能否以可核验的方式一起放缓,也是文章最后追问的问题。
AI 开发方式经历了哪几代
Anthropic 用自己的工作方式画出一条五阶段的路线。变化的重点是:人交给 AI 的任务,从一小段代码,变成一个可以自行拆解和执行的目标。
- 2021—2023:人手开发。 工程师在电脑上写代码、写文档,推动模型研发的每一步。
- 2023—2025:聊天机器人辅助。 人让模型生成代码片段,再复制进编辑器;模型不能接手整个任务。
- 2025—2026:编程 Agent。 Agent 开始自己读写和修改文件,有时能完成整份文件的改动。
- 现在:自主 Agent。 它能运行代码、测试结果,把数小时的工作分给其他 Agent;人更多给目标、审查产出。
- 未来:递归自我改进。 如果一代 AI 能设计、开发并训练后继模型,后继模型又继续改进下一代,研发才形成完整闭环。Anthropic 没有给出实现时间。
造模型有两类工作:工程要写代码、建训练系统、排查故障;研究要设计实验、解释结果、选择下一条路线。任务也有不同层次:照明确要求执行,拿到一个目标后自己找方法,或者自己决定什么问题值得做。Claude 已从执行步骤走到自行找方法;能否再接过方向判断,才关系到它能不能造出自己的后继者。
研发闭环 · 两种状态对照
AI 已接过哪一棒,闭环还缺哪一棒?
切换“目前证据”和“完整闭环所需”,再点每一步,可对照任务分工。后者描述成立条件,不代表已经实现。
目前证据 · 第 1 步
Anthropic 说人仍负责判断哪些问题值得做。129 个特意挑出人类走偏的节点,只给出 Claude 局部决策改善的早期信号。
关键证据:AI 怎样加快造 AI
外部评测:从几分钟任务走向十几小时
评测机构 METR 用“任务时间跨度”观察模型能独立完成多长的工作:在一组任务中,模型达到约 50% 成功率时,这些任务通常需要人做多久。Anthropic 引用的趋势从约每七个月翻倍,变成近期约每四个月翻倍。2024 年 3 月的 Opus 3 对应约四分钟的软件任务;一年后 Sonnet 3.7 约一个半小时;再一年后 Opus 4.6 约 12 小时。METR 对 Mythos Preview 测得“至少”16 小时,已接近当时测试工具的上限。按 Anthropic 的外推,如果趋势保持,年内可能碰到人类要做数天的任务,下一年则可能涉及数周。
其他测试也在迅速变难:SWE-bench 要模型根据真实仓库和 bug 报告修复软件,成绩约两年间从低个位数走到接近饱和;CORE-Bench 要模型用论文代码和数据复现已发表结果,成功率约十五个月间从 20% 走到接近饱和。它们说明 AI 能完成更长、更复杂的既定任务;要看它是否加快了 AI 研发本身,还得看实验室里的工作。
内部工程:代码写得更多,也能独立排故障
截至 2026 年 5 月,Anthropic 生产代码库中已合并的代码行,有超过 80% 可归因于 Claude;Claude Code 在 2025 年初进入研究预览前,这一比例还是低个位数。工程师人均每天合并的代码行数也在 2025 年开始上升:2026 年第一季度达到早期平均值的 5.8 倍,第二季度截至绘图时达到 8.0 倍。工程师的工作从亲手写下每一行,转向交代目标、审查和合并结果。

这解释了代码产出为何暴涨,也说明人仍在研发链条中。代码行数并不等于净生产力;作为另一种观察,2026 年 3 月受访的 130 名研究团队员工,对自己使用 Mythos Preview 的产出提升给出中位数约四倍的估计。自动化还让原本排不上日程的活得以完成:2026 年 4 月,Claude 交付 800 多项修复,让一类 API 错误减少约一千倍;负责工程师估计,人手处理可能要四年。
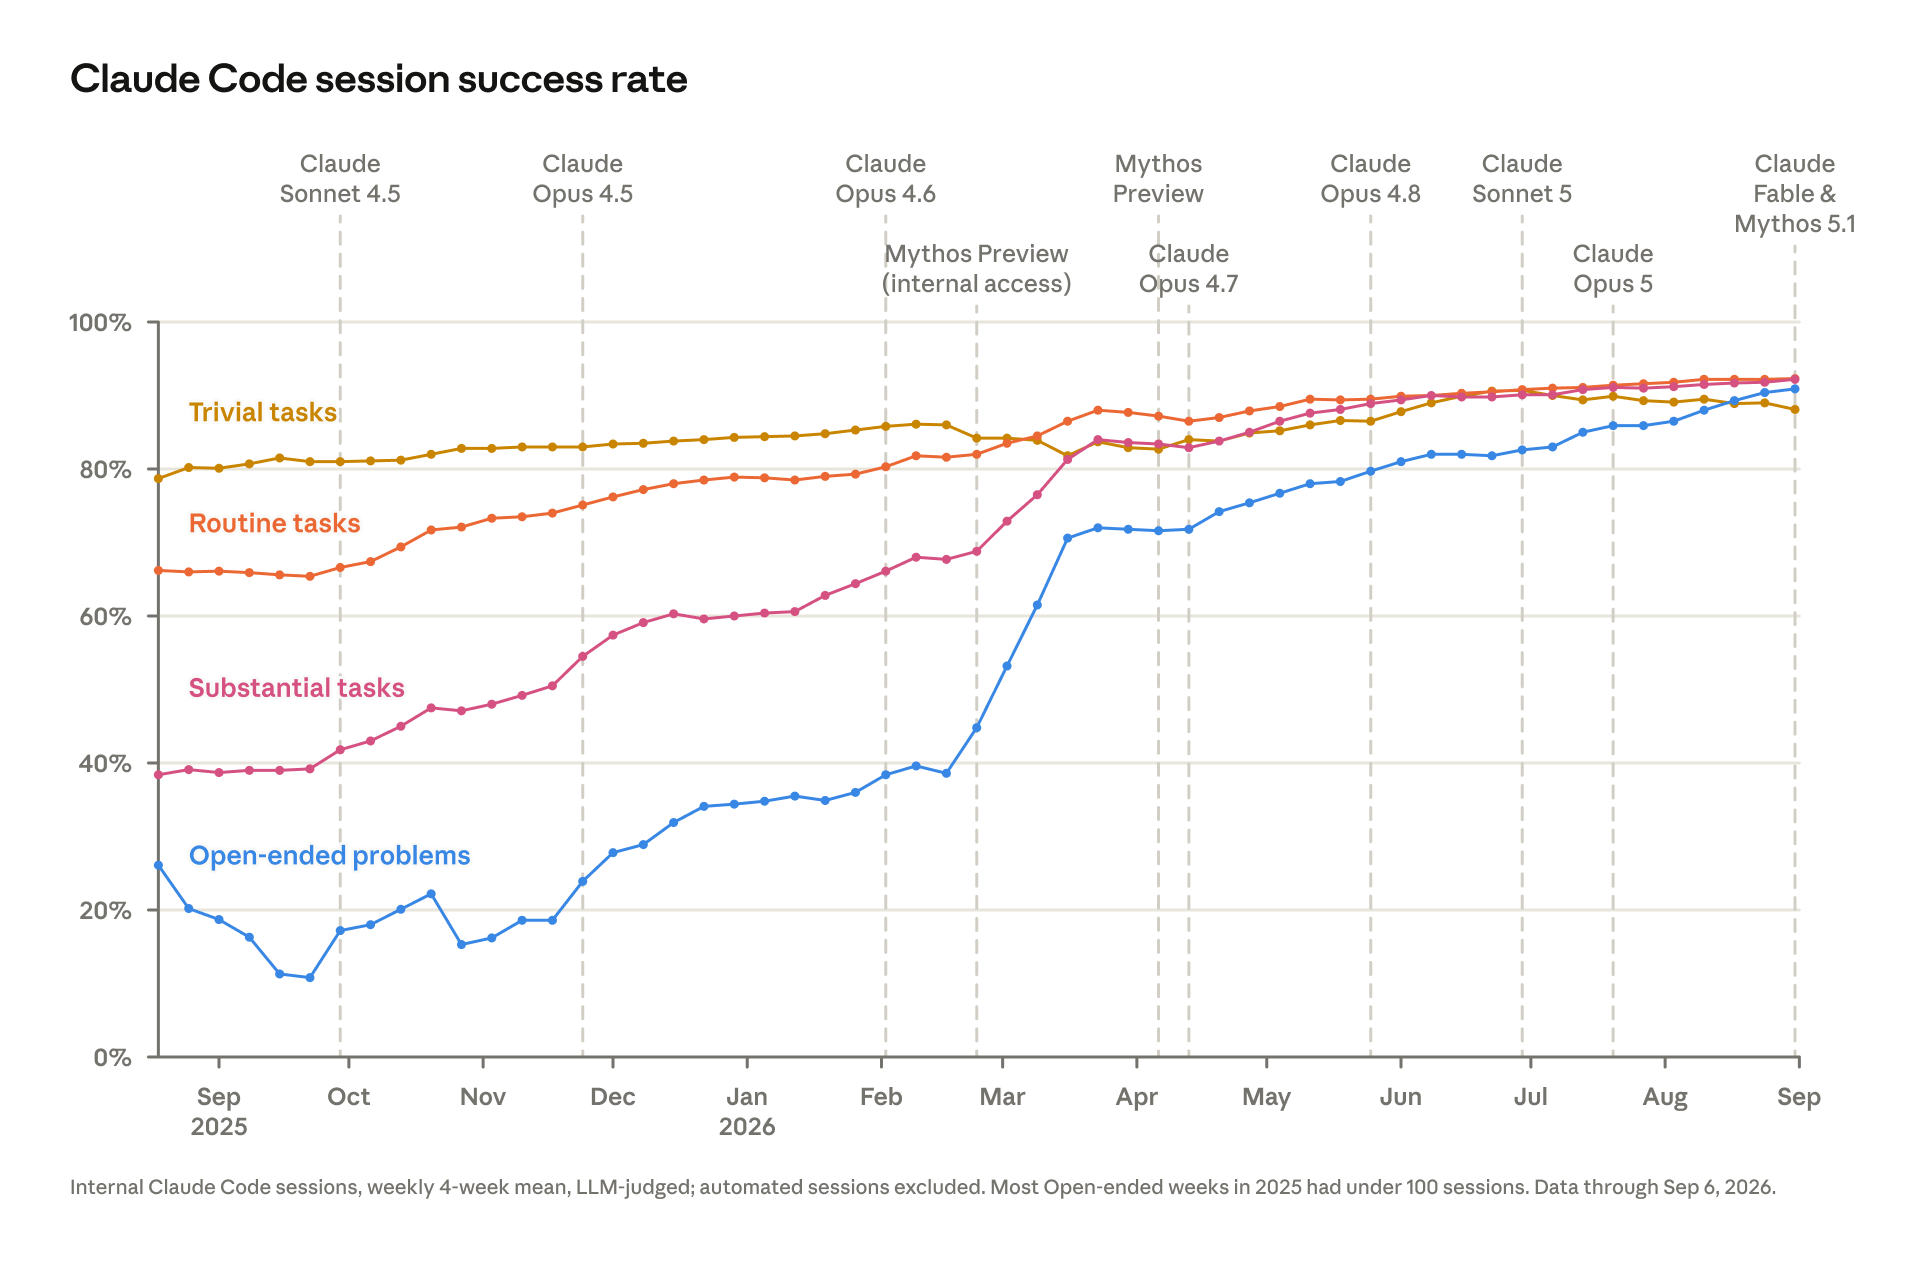
代码量增加之外,更关键的是 Claude 能否接过没有明确步骤的问题。Anthropic 按难度追踪内部 Claude Code 会话:到 2026 年 5 月,最开放的一类任务,被 Claude 裁判判为无需人工纠正即可完成的比例达到约 76%,比半年之前高约 50 个百分点。员工中途纠正、改向或接管的频率也在下降。原文 9 月更新的图把开放任务末端值推到约 91%;这是同类内部会话指标的后续观察。
一个具体例子是训练集群故障。一次升级让数万项训练作业突然崩溃,工程师只给了问题描述和集群访问权。Claude 逐项检查运行中的作业和环境设置,定位到一个隐蔽的调试标志,复现故障并确认修复。它用了约两小时;Anthropic 估计工程师通常需要两三天。人给的是“让训练恢复”的目标,排查路径是 Claude 自己找出来的。


代码能跑起来之后,还要让同事读懂、维护。许多 Anthropic 员工认为 Claude 写的代码如今已大致追平人写的水平,但团队并无一致看法。公司现在也让 Claude 审查待合并的代码。它回看历史事故后估计,如果这些变更当时都经自动审查,约三分之一后来导致 claude.ai 事故的 bug 可能提前被发现。
内部研究:给定问题后,Claude 能自己试出答案
排障说明 Claude 能在目标明确时自己找路径。研究更进一步:要不断提出方案、运行实验,再根据结果调整。Anthropic 每次发布模型都会做同一项实验:给 Claude 一段训练小模型的代码,要求在正确性检查通过的前提下尽量提速。Claude 改代码、运行、计时,再继续改。2025 年 5 月的 Opus 4 平均把起始代码提速约三倍;2026 年 4 月的 Mythos Preview 达到约 52 倍。熟练研究员在同一任务上用四至八小时,约能做到四倍。这个对照展示了 Claude 在目标和验收方式明确时反复试错的能力;52 倍不是现实大模型训练的提速幅度。
更开放的实验也开始交给 Agent。在“较弱模型能否监督较强模型”的研究中,两名研究者用约一周,把成绩从弱模型基线向理想上限推进了约 23%;Claude Agent 累计工作约 800 小时、花费约 1.8 万美元算力成本,把这一差距推进了约 97%。它们自行提出假设、分工、试验、交流和迭代。不过,研究题目与评分标准由人设定,结果也没顺利迁移到生产规模模型。这个例子最值得看的是:人定了要解决什么问题,AI 已能自己探索怎么解决。
真正难交出去的,是研究判断
前面两项实验都有一个共同前提:人先定下要解决的问题。更难交出去的,是发现哪个问题值得研究、判断一个好看的结果是否可靠,以及识别何时该放弃一条路线。Anthropic 把这种能力称为研究品味与判断力;目前它仍是人的主要优势。
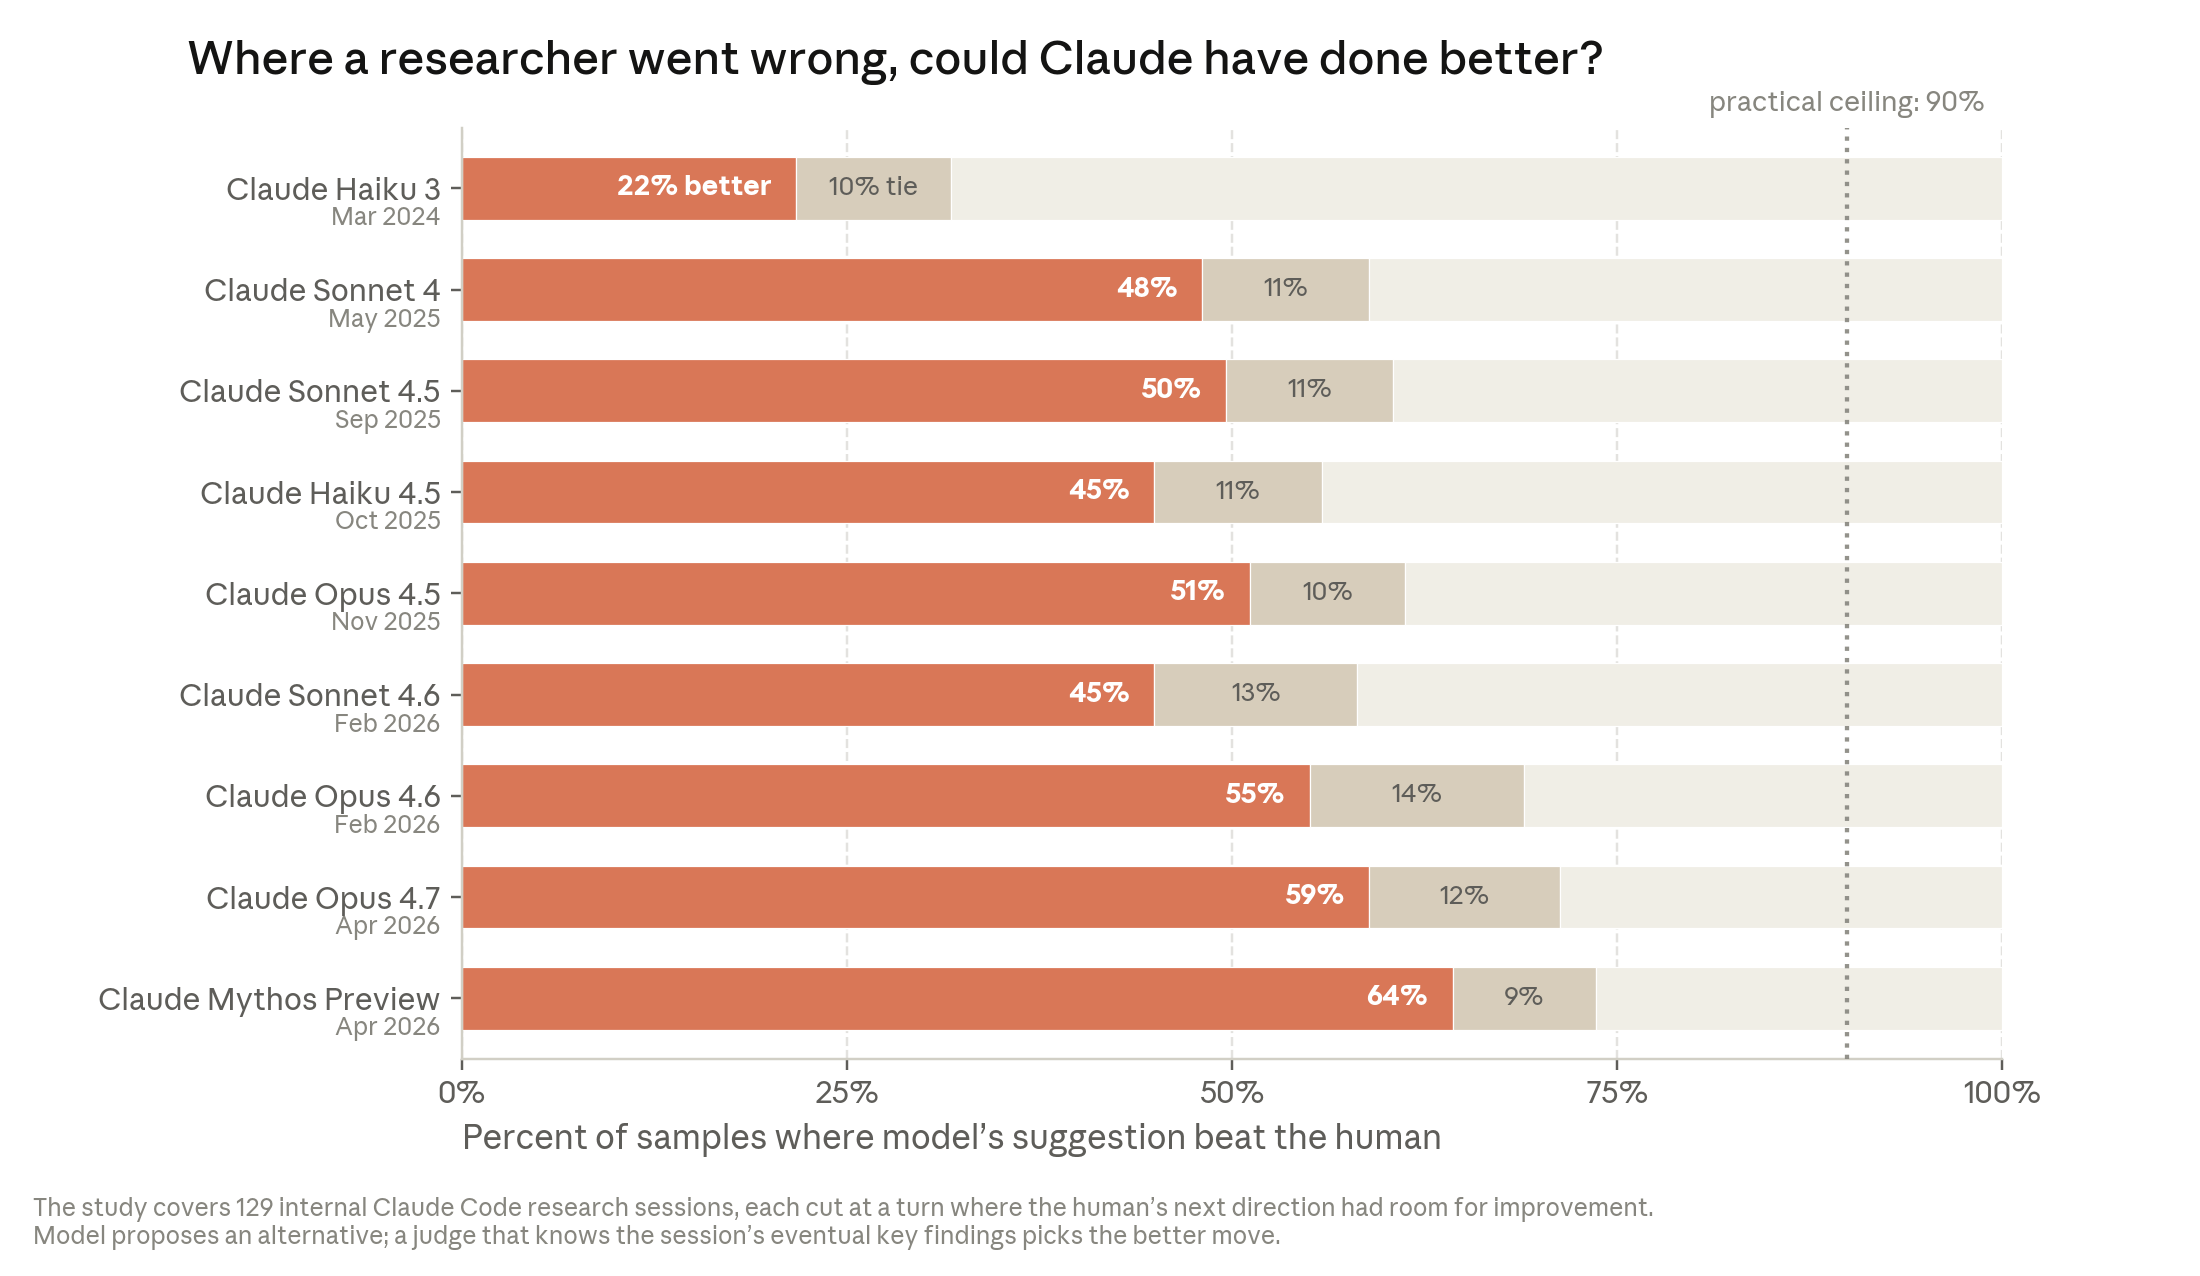
Claude 在局部判断上已有进展。Anthropic 从内部研究会话中挑出 129 个人类一度走偏的节点,让模型只看走偏前的材料,提出下一步。能看到后续结果的 Claude 裁判认为,Opus 4.5 在其中 51% 的节点建议更好,Mythos Preview 为 64%。这组题专挑人走偏的时刻;作为对照,在另 127 个人本来选得不错的节点,模型建议只有约 20% 被判更好。研究不是选完题就自动推进:每次实验出现新结果,都要决定下一步先查什么、改什么。Claude 已开始在这样的局部岔路口帮人少走弯路;如果这种能力继续提升,研究品味也可能逐渐变成 AI 能学会的能力。

一个关键反问是:如果选题才决定突破,AI 把其余工作做得再快又有什么用?Anthropic 的回答是,突破性想法罕见,日常进步更多来自扩大实验、发现问题、修复后再试。即使人一直决定方向,只要 AI 把这些重复迭代压缩,每位研究者也能同时推动更多工作。这是文章判断研发仍可能持续加速的理由。
加速又会制造新瓶颈。代码和实验越来越少占用人的执行时间,却仍要花算力,也要有人判断结果。代码生成太快,人审查不过来;实验方案太多,团队来不及挑选和推进。阿姆达尔定律在这里很直白:整体速度会卡在没有一起变快的环节。Anthropic 说,这两种拥堵已在内部出现。员工的体验也有另一面:有人说自己已约五个月没亲手写代码;原来请同事帮忙跑脚本会带来交流与互助,如今 Claude 很快做完;也有人在系统出错时意识到,自己已不太了解每天运行的东西。产出变多后,人的判断和理解反而更需要被保住。接下来的走向,也取决于这些瓶颈能否被解决,以及研究方向最终由谁决定。
接下来有三条路
第一条:能力增长放缓,现有 AI 广泛扩散。曲线可能因为现有训练方法难再产生更好的研究判断而转平,这需要新的技术思路;也可能是芯片、电力、电网和互连的供给跟不上。即使能力停在今天的水平,普及仍会改变工作。Anthropic 举 Project Glasswing 为例,称 Mythos Preview 在最初数周发现一万多个高危和严重漏洞,网络防御的瓶颈开始转向修补。它还设想:一个百人公司借助 Agent,可能承担过去千人公司的工作。Anthropic 认为这条路相对不太可能,但它会给社会更多适应时间。
第二条:人定方向,AI 持续加速研发。人负责选题和验证,Agent 执行越来越多的代码、实验与分析。Anthropic 认为当前证据更指向这条路,并设想百人组织将来可能完成过去万人乃至十万人组织的工作。公共服务和知识工作会受益,同样的能力也可能被用来做大规模监控或针对个人的操纵。代码审查、资源分配和组织决策,则会不断成为新的速度上限。
第三条:AI 自己造下一代 AI。如果 AI 连研究方向和后继系统设计也能接手,模型研发速度会更受算力和算法效率影响,人主要转向监督、验证。自动研究可能延伸到药物、机器人等领域。更强的模型也许能找到新的安全对齐办法,甚至在无法保证安全时自行停下;另一种可能是偏离在人类看不懂的代际更新中累积,最终失去控制。若人类劳动失去竞争力,经济怎样组织也难预测。即使研发在实验室里飞速循环,新药验证、电网建设、制度运行和人与人的信任,仍有各自的时间尺度。
这三条是条件不同的未来,不是依次发生的三个阶段。切换下面的条件,可以看见原文的分叉点:能力趋势是否继续,以及研究方向由谁决定。
原文的三种条件情景
换一个条件,未来会落在哪条路?
用两个条件查看原文的分叉逻辑。这里只整理 Anthropic 的假设,不计算发生概率。
趋势继续,人类仍选题 → 情景二:人机协作持续提效。
- 01能力转平,现有能力扩散能源、芯片、算力或研究判断成为硬约束;现有 AI 的普及仍改变工作。
- 02人定方向,AI 加速执行Anthropic 认为目前证据最指向此路;审查和资源分配成为新瓶颈。
- 03AI 自行设计后继系统需要 AI 也掌握研究判断与后继设计;文章说尚未实现。
趋势转平时,谁选题不改变此图的第一分支;现实结果还受能源、实体建设和制度速度约束。
三条路带来的准备时间并不一样。如果研发继续加速,社会如何为安全研究和制度调整争取时间,就从远期讨论变成眼前的问题。
为什么 Anthropic 提议讨论“可核验的暂停”
如果 AI 研发跑得比社会适应和安全研究更快,Anthropic 希望保留协调放缓或暂停前沿研发的选项。难处是让多个国家的前沿实验室在相同条件下行动:先要发现谁在暗中继续训练,还要核验各方确实遵守。训练任务比传统军备设施容易隐藏,悄悄继续的一方又可能抢得领先。过去的军控核验用了数十年建立设施和信任,AI 发展未必留出同样长的时间。
单家实验室可以立即停下,但如果其他开发者继续推进,它主要改变谁处于领先位置,还可能让不够谨慎的一方追上,未必给社会留下更多讨论时间。Anthropic 因此主张协调行动:如果其他前沿开发者也在可核验的安排下放缓或暂停,它预计自己也会这样做。文章提出的是要建立这种能力,并没有现成的国际核验机制。它希望政策制定者、研究者、企业和公众一起讨论:何时触发、如何检查、何时恢复。
Claude 接手造 AI 的哪一步?
它已写下 Anthropic 超八成新合并生产代码行,也能自己排查训练故障、迭代实验。真正的分水岭是:谁决定研究什么,以及结果能不能信?
从助手到后继模型:五代演进
变化已经发生在哪
这些是不同任务的证据,各有自己的测量口径。
关键缺口:从会做,到知道该做什么
工程和研究并不只有“执行”。越往下,越需要决定目标是否值得追、实验结果是否可信。
弱监督强模型实验中,Agent 累计工作约 800 小时、花费约 1.8 万美元,将预设性能差距推进约 97%;题目与评分标准仍由人设定,结果也未顺利迁移到生产规模模型。
加速之后,瓶颈转向人
代码行数暴涨仍要由人读、判断和合并;速度上限转到没有同步加快的审核环节。
AI 可并行探索,但研究者仍要辨别哪些发现有意义、哪些结果值得相信。
接下来分成三条路
它们是条件不同的情景,不是依次发生的三个阶段。
算力、电力或方法遇到上限;AI 仍改变企业和社会的工作方式。
研究者掌舵,Agent 承担更多代码、实验和分析;Anthropic 认为当前证据更指向这一路。
若 AI 接过研究判断与后继系统设计,研发形成真正闭环,速度与安全风险都可能改变。
资料:Anthropic《When AI builds itself》;数字和情景均按该文口径整理。
When AI builds itself
Our progress toward recursive self-improvement, and its implications.
For most of AI’s history, humans drove every step in its development cycle. But at Anthropic, we are delegating a growing share of AI development to AI systems themselves, which is speeding up our work.
Taken far enough, and given enough compute, that trend points to an AI system capable of fully autonomously designing and developing its own successor. This is called recursive self-improvement. We are not there yet, and recursive self-improvement is not inevitable. But it could come sooner than most institutions are prepared for.
Using public benchmarks and previously unreported data from within Anthropic, The Anthropic Institute is showing that AI is already accelerating the development of AI systems. To take just one example: today, Anthropic engineers on average ship 8x as much code per quarter as they did from 2021-2025.
The technical trends discussed in this piece suggest that AI systems are going to become much more capable in coming years. These trends have huge implications. AI that can build itself would be a major development in the history of technology—one that could bring enormous good for the world in science, healthcare, and beyond. But full recursive self-improvement also might increase the risks of humans losing control over AI systems. If systems are capable of fully building their own successors, the ways we secure them, monitor them, and shape their behavior all grow much more important.
2021–2023
Building the first Claude
In the early days, work at Anthropic looked like work at any other tech company: people writing code and docs on laptops.
2023–2025
Chatbots
People used early chatbots to help with parts of the process, like generating short code snippets and copying the output into text editors.
2025–2026
Coding agents
As the agents became more capable, they were able to write and edit code on their own, sometimes entire files.
Today
Autonomous agents
Agents can now run code themselves and delegate hours of work to other agents.
20XX?
Closing the loop
In the future, agents could become capable enough to build and train models themselves. If this happens, future versions of Claude could be continuously improved by Claude itself.
Evidence from the outside world
The rate at which AI models improve is accelerating. The length of tasks that they can reliably complete on their own has been doubling roughly every four months, up from an earlier trend of doubling every seven months. In March 2024, Claude Opus 3 could complete software tasks that take humans about four minutes to complete. A year later, Claude Sonnet 3.7 managed tasks that took about an hour and a half. A year after that, Claude Opus 4.6 managed 12-hour tasks.1 If this trend holds, tasks that take a skilled person days could come into range this year. In 2027, AI systems could be capable of tasks that take a person weeks.
The same pattern appears on coding and research benchmarks. Benchmarks measure the performance of models in a given domain, and they’re “saturated” when models achieve close to 100% performance.2 SWE-bench is a standard test of real-world software engineering: it hands a model an actual open-source codebase and a real bug report, and asks it to write a code change that fixes the issue and passes the project’s own tests. Models have gone from scoring in the low single digits to saturating the benchmark in two years.
CORE-Bench tests whether a model can reproduce existing research, a prerequisite for them to conduct original research. It gives an AI model the code and data behind a published paper, and asks it to rerun everything and confirm it can replicate the paper’s results. AI systems went from succeeding at reproducing the results roughly 20% of the time in 2024 to saturating the benchmark fifteen months later. METR, which runs the benchmark measuring how well models can complete long-duration tasks, found that Claude Mythos Preview could work for “at least” 16 hours and was “at the upper end of what [METR] can measure without new tasks.”
Public benchmarks say a lot about the capabilities of these systems. But they can’t reveal the impact AI systems are having on speeding up AI development itself. For that, we need direct evidence from within AI companies like Anthropic.
Evidence from within Anthropic
Building a frontier model takes two broad categories of work. There is engineering: writing the code, standing up the infrastructure, and overseeing the model training. And there is research: deciding what experiments to run, interpreting what comes back, and figuring out which ideas to try next.
Across both engineering and research, the picture is consistent. In engineering, Claude can be handed an underspecified problem and figure out how to solve it; humans supply the goal, but they no longer need to supply the method. In research, Claude can already match or outperform skilled humans at executing a well-specified experiment. However, large performance gaps persist when it comes to Claude exercising judgement in choosing goals in both engineering and research. That’s the gap between AI today and a future system that could autonomously design its own successor.
It’s common for employees at Anthropic to receive more open-ended and important tasks as they gain more experience. Early on, they execute a task someone else specified, like, “The export button isn’t working, please fix it.” With experience, they’re handed a goal and design the approach themselves, such as, “Investigate why the network slows down under heavy load.” At the most senior levels, they are deciding which problems are worth working on at all: “What should the team build next quarter?” We can use internal Anthropic data to see how far Claude has come in being able to handle these different kinds of tasks.
Claude writes a significant proportion of Anthropic’s code. As of May 2026, more than 80% of the code we merge into Anthropic’s codebase was authored by Claude.3 Before Claude Code launched in research preview in February 2025, this number was in the low single digits. That shift also shows up in the amount of output per engineer. Lines of code merged per engineer per day stayed constant through Anthropic’s first four years (2021-2024), then began to climb upward in 2025 when Claude began to run code rather than just suggesting it for an engineer to copy and paste. The slope steepened again in 2026 when models began to work autonomously over longer time horizons. These two inflection points are shown in the chart below. In the second quarter of 2026, the typical engineer was merging 8× as much code per day as they were in 2024.4 This is because much of the code is written by Claude, with the engineer directing and reviewing, rather than typing it themselves.
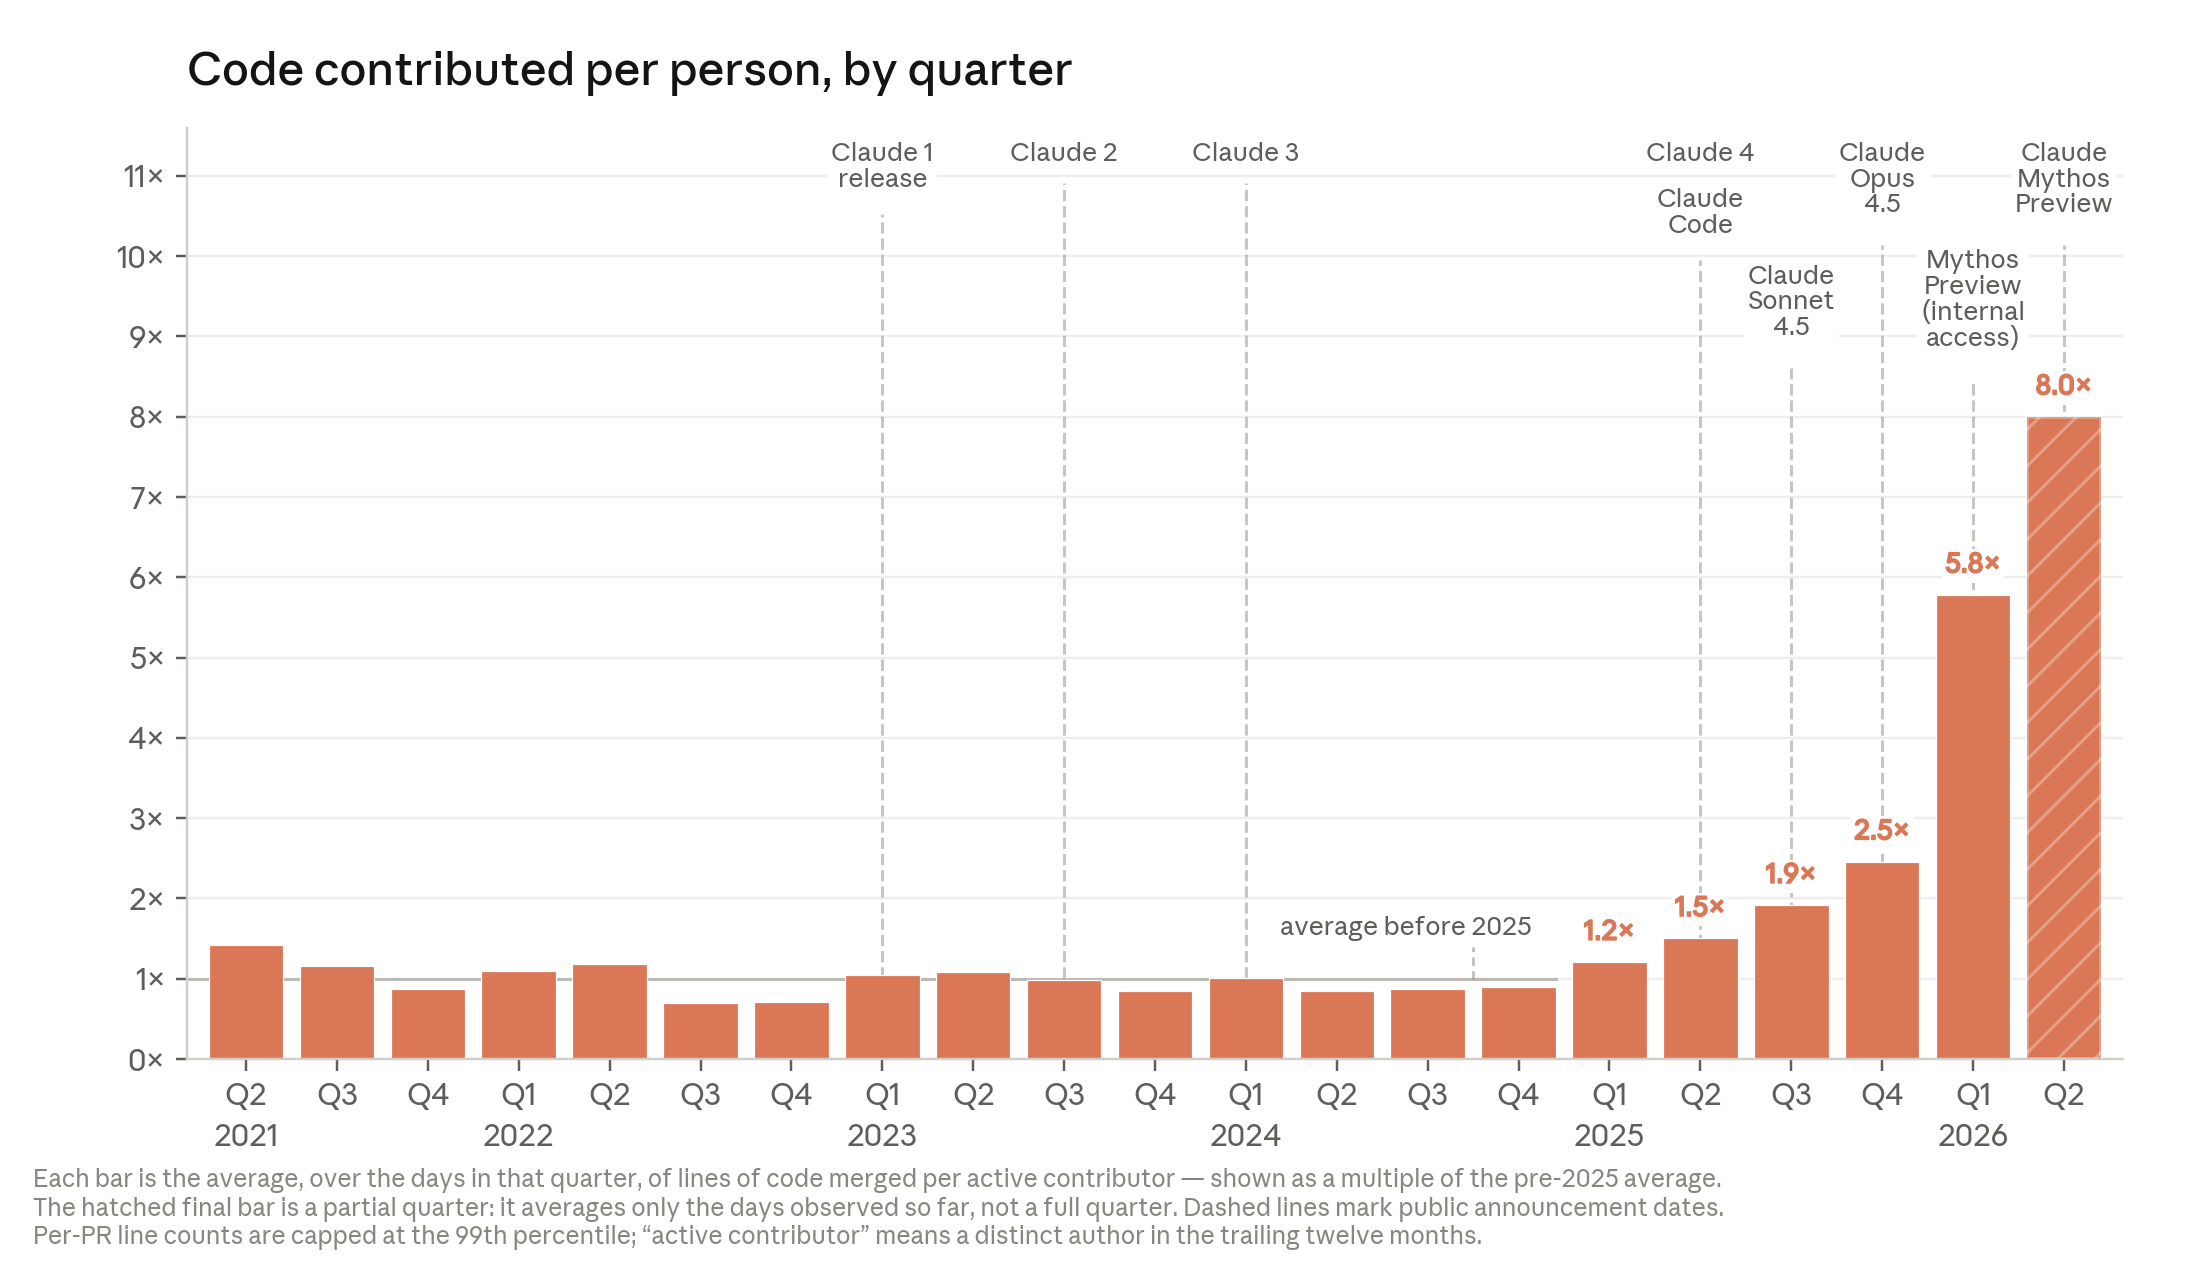
A caveat: Lines of code is an imperfect measure, as it measures quantity over quality. So 8× lines of code/engineer/day in the second quarter of 2026 is almost certainly an overstatement of the true productivity gain. Nonetheless, it indicates an acceleration. At Anthropic, we don’t reward people for how many lines of code they write; rather, team members are producing more code simply because they’re using AI systems to write more code.
The increase in lines of code written lines up with subjective impressions of large productivity increases. In a March 2026 poll of 130 employees from across Anthropic research teams, the median respondent estimated that they produced around 4x as much output with Mythos Preview as they would have without access to any AI models, on the kinds of projects they would have been working on regardless.5 We expect that the true degree of uplift in March was somewhat lower.6 Nevertheless, we find the overall claim plausible, and in line with our other observations: a significant fraction of Anthropic technical staff is accomplishing their core work multiple times faster than they could without AI assistance.
We also see evidence that people at Anthropic are using Claude to do work that simply wouldn’t have happened otherwise, like building exploratory tooling and addressing long-deferred cleanup. For example, in April 2026, Claude shipped over 800 fixes that reduced a class of API errors by a factor of one thousand. The engineer overseeing Claude estimated that a human would have taken four years to complete this work; solving other people’s bugs is slow and painstaking, and humans struggle to hold that much unfamiliar context in their head at once.
Anthropic employee*
The code that Claude writes is “good” and improving. “Good code” means two things: it works, and it is written in a manner that allows another engineer to understand it and build upon it. On the first criterion, the evidence is clear. The rate at which Anthropic staff correct, redirect, or take over mid-task from Claude has been falling steadily for a year, including on the most complex and open-ended tasks. This means problems with no clear specification, where the engineer isn’t sure what the answer looks like. This is evident in Claude’s success rate over time on tasks of different difficulties, as shown in the graph below. Claude writes code that works.
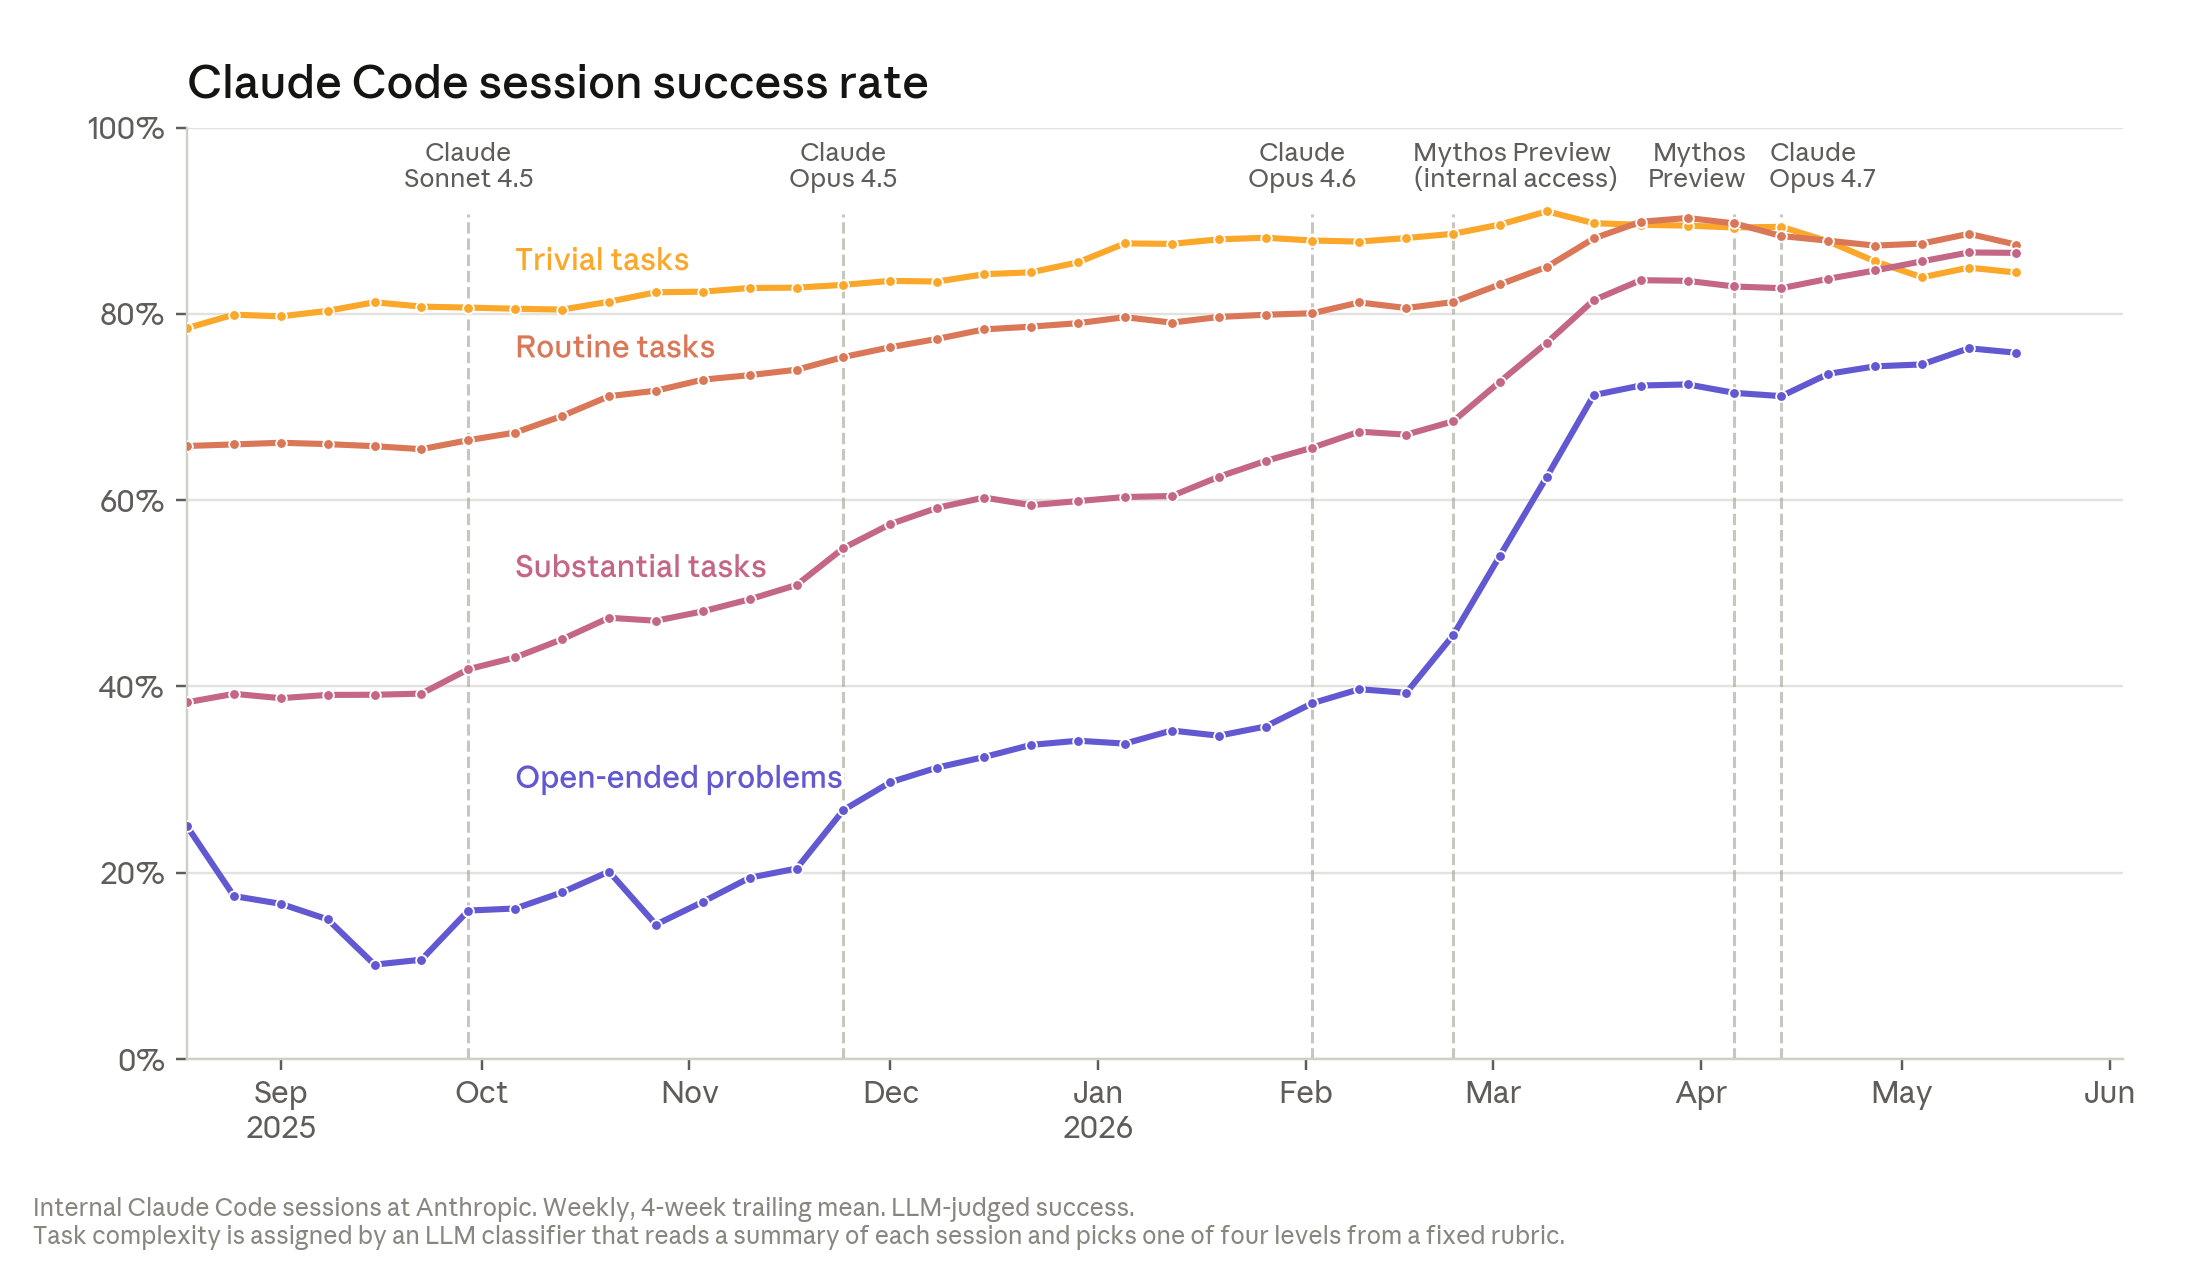
On the most open-ended tasks, Claude’s success rate reached 76% in May 2026, up 50 percentage points in six months. To give an example of tasks in this difficulty tier, a routine upgrade began crashing tens of thousands of training jobs. An engineer pointed Claude at the live incident with little more than some text content and cluster access. Working through the running jobs and testing one environment setting at a time, Claude isolated the single obscure debugging flag that was triggering the crash, reproduced it reliably, and confirmed a fix. In about two hours, Claude delivered what would normally be two to three days of work.
The second criterion is writing code that another engineer can understand and build on. Here the gap between humans and AI persists, but is closing fast. There isn’t full consensus among staff at Anthropic, but many believe that the Claude-written code was still worse in quality than human-written code at Anthropic in late 2025, and is roughly at parity today. We expect it to be better within the year.
This has changed the way that Anthropic now reviews its own code. Proposed changes to our codebase are now read by an automated Claude reviewer that looks for bugs, security flaws, and other defects before it can merge. Using this tool, we ran a retrospective analysis, and found that an automated Claude review of every change to our codebase would have caught roughly a third of the bugs behind past incidents on claude.ai before they ever reached production. The engineers who wrote that code are among the best in the world at building these systems. Claude is now catching the mistakes that they missed.
Claude is good at running experiments to hit a goal that someone else has set. Every time Anthropic releases a model, we run the same test: we give Claude some code that trains a small AI model, and ask it to make that code run as fast as possible while still passing the same correctness checks. The goal and the success metrics are fixed in advance, so Claude’s job is to find speedups by rewriting the code, running it, timing it, and repeating. It’s a miniature version of an experimental research loop. In May 2025, Claude Opus 4 averaged a ~3x speedup over the starting code. By April 2026, Claude Mythos Preview was achieving ~52x. For calibration, a skilled human researcher would need four to eight hours to reach 4x.7 In this part of the research workflow—optimizing steps within a clearly defined experiment—Claude has gone from super helpful to superhuman in under a year.
Claude is getting better at proposing its own experiments. In April 2026, Anthropic published the first demonstration of Claude running an open-ended research project end to end. Claude-powered agents were given an open problem in AI safety—roughly, can a weaker model reliably supervise a stronger one?—and were left to solve it. This involved proposing hypotheses, testing them, sharing findings with parallel agents, and iterating. The task has a clear performance “floor” and “ceiling”: the floor is how well the weak supervisor would do on its own; the ceiling is how the strong model does when trained on correct answers. Two human researchers, over about a week, recovered roughly 23% of that gap; the agents recovered 97% over 800 cumulative hours and used roughly $18,000 in compute. There are some caveats to this work; the result didn’t transfer cleanly to production-scale models, and humans still chose the problem and created the scoring rubric. But within those bounds, the agents designed every experiment themselves. Direction-setting was the only meaningful role a human played.
Claude is getting better at steering research sessions towards research findings. We examined real Claude Code sessions (between January and March 2026) where Anthropic researchers were working with Claude on an open-ended investigative problem, like figuring out why a training run kept crashing, or why a model scored poorly on a benchmark. In each case, we found a moment where the researcher took a detour: they pursued a direction that sent the session sideways before it eventually got back on track. We then showed various Claude models only the work from before the session went off-course and asked what it would do next. A separate Claude that was able to see how the session eventually turned out then judged whether the AI or the human suggested the better next step.8
Because we deliberately picked moments (n=129) where we know the human’s choice had room for improvement, this isn’t a like-for-like comparison between model and human judgement. What these moments give us is a set of realistic, challenging situations where the right next step is not obvious, and where the human’s choice serves as a useful yardstick to compare model performance over time. On this measure, our best model in November 2025 (Opus 4.5) beat the human choice 51% of the time; in April 2026 (Mythos Preview), this grew to 64%. The day-to-day work of research is largely a chain of these next-step decisions, making this a relevant measure of the model’s ability to eventually run an investigation of its own. We view this result as an early signal that AI systems are getting better at making the kinds of judgement calls that AI research depends on.
What might the future of work at Anthropic look like?
The evidence suggests that the human role is narrowing at each step in the AI development process. Once human- and AI-authored code quality reach parity, humans will stop writing code entirely, and shift to only reviewing it. But if they can’t review code as quickly as Claude can generate it, human review will become the bottleneck to AI development. Similarly, once Claude can run experiments, the question shifts towards “Which of these experiments is worth running?” Put simply: the doing (i.e., writing the code, running the experiment, producing the result) now costs almost nothing in human time, even if it still has costs in compute.
An area of human comparative advantage, for now, is research taste and judgment, including choosing which problems matter, which results to trust, and when an approach is a dead end.
What if we’re wrong?
A natural objection to the evidence presented above is that the work that is still in human hands—choosing which problems to work on—is what matters most. Without that judgment, Claude is a capable assistant, but not a system that could drive AI progress on its own.
It is genuinely unclear whether today’s training methods and architectures could unlock that capacity. But AI is rarely advanced by “eureka!” moments. There have been a few of these in AI’s recent history, like the Transformer architecture, or mixture-of-experts models, but paradigm-shifting ideas arrive years apart. In between, most progress is incremental: we scale something up, see what breaks, fix it, and try again. That is exactly the kind of workflow Claude now excels at. Edison said that genius is 1% inspiration and 99% perspiration. But we see perspiration becoming increasingly automated. It’s becoming clear that much of what advances the frontier is automatable; large-scale research progress is mostly a function of tools and resources, which dictate how fast you can run experiments, how many you can run at once, and how quickly you can get results.
Even if we suppose that Claude never achieves good research taste, a conservative reading of our evidence still implies compounding acceleration. If humans spend most of their time on the single-digit fraction of work that is direction-setting, while Claude handles the rest, that means each engineer or researcher is steering far more work than before. The evidence we see suggests that people at Anthropic are both moving faster and covering a broader surface. In practice, this means that AI already makes Anthropic move much faster than it did before the advent of effective AI tools.
The less conservative reading is that the early evidence on Claude’s improving research judgment—narrow as it is today—is an indicator that this capability is improving as well. “Research taste” might be just another AI capability that AI systems fail at for a time, then get good at. We’ve seen a similar pattern with other qualitative skills, like AI systems being able to explain why a joke is funny, demonstrate theory of mind, and solve linguistic riddles.
Possible futures
What happens next depends on two things: whether the trend continues, and what we choose to do if it does. We can imagine at least three future scenarios:
- The trend stalls, but today’s AI capabilities are widely diffused. This article features many exponential trajectories. But these trajectories may actually turn out to be S-curves. We may be approaching the bend in the curve, where returns to scale diminish and the line straightens, then flattens. The judgment that separates a competent researcher from a great one might be a capability that cannot come from scaling up training inputs like compute and data. If so, getting past this bottleneck would require a new idea, like an architectural approach that supplants the Transformer architecture that all current frontier models use.Alternately, the binding constraint to AI progress could be in the supply chain, not the model: advancing and diffusing the frontier may require more energy and compute than presently exists. The pace of chip fabrication, grid expansion, or interconnect bandwidth may be the constraint, rather than intelligence itself. We also cannot rule out an exogenous shock to the AI ecosystem that dramatically slows things, like a sudden diminishment in the supply of compute or electricity, either of which would slow progress and make forward investment by labs more expensive. Or we may not be anticipating some other barrier to progress.Even if model capabilities were frozen at today’s level, we would expect major changes to occur in the world. Project Glasswing is one early sign: in its first weeks, Mythos Preview found more than ten thousand high- and critical-severity software vulnerabilities across the world’s most important systems—enough that the bottleneck in cyber defense has already shifted from finding vulnerabilities to patching them fast enough. And we are still early in the diffusion of today’s models into the wider economy, where a 100-person company can increasingly do the work of a 1,000-person one, because each employee will sit atop a pyramid of agents.We include this scenario for completeness, but we don’t believe it’s likely. Every capability we can measure, including those that feel “squishier,” like quality of code and success on open-ended tasks, has so far followed the same curve. We have not yet seen that curve bend. Of the three futures we consider, this one would give governments and societies the most time to adapt. We are more worried about the next two, which would move faster and leave far less room for preparation.
- AI labs continue to see compounding efficiency gains. In this scenario, AI development becomes substantially automated, but humans continue to set research directions and judge results. Organizations that use AI systems would become much more efficient as time goes on, so we could expect to see significant productivity multipliers on each person in this organization. 100-person companies could do the work of 10,000- or 100,000-person organizations. This would revolutionize knowledge work and government services, but could also be turned to harmful ends, from authoritarian surveillance of whole populations to influence operations that tailor manipulation to each individual and run at a scale no human team could match. The role of humans at companies like Anthropic would shift. People would partner with AI systems to scale up research and generate new insights, and together they would build the systems needed to verify that AI outputs can be trusted.The evidence we’ve laid out here suggests that we’re likely heading into this scenario. But speeding up one part of a process often just shifts the bottleneck elsewhere: overall pace is capped by the parts that haven’t sped up. In computing, this is known as Amdahl’s law, and the same logic can apply to organizations. Anthropic has already encountered one signature of Amdahl’s law: as we’ve begun to push more code around the organization, human code review has become a new bottleneck.We’ve also encountered this friction outside engineering. There has been an explosion of new ideas, initiatives, tools, and simulations, as a result of Anthropic employees working with highly capable models—far more than we have the capacity to pursue. The rate at which organizations can spot and fix these bottlenecks may be a skill that improves over time, and it may become the most important skill for any organization.
- AI systems themselves become capable of full recursive self-improvement, and begin building their successors. If technical trends in advancing capabilities continue, and AI systems are able to develop the capabilities inherent to transformative human ingenuity, then it is plausible that AI systems could design and refine themselves.In this world, the pace of progress in AI development becomes determined entirely by the availability of compute (or the speed of discovering various efficiencies in algorithmic training or inference) for AI systems. Humans play a substantially diminished role in their development, likely moving most of our effort towards oversight, validation, and verification of an expanding “virtual lab” run by AI systems. We expect that systems capable of automated AI research and development would have skills that would transfer to the rest of science, allowing them to begin to revolutionize other fields.How the alignment problem gets solved—or not—in this future is something we are least certain about. Models could prove to be sufficiently aligned and capable enough of research taste that they discover and implement novel solutions that we have not yet reached. They could also be sufficiently wise to halt development if not. Alternatively, the rare occurrences of misalignment present in today’s models could compound as the models build their successors, growing more frequent but less understood until we lose control of them. It’s possible that we can’t build, integrate, and verify the tools that we’d need to understand which trendline we are actually on.We do not have good intuitions for what this world would look like, because our economy is currently driven by humans and human-built tools. By its nature, a world driven by fast recursive self-improvement could become dominated by the self-improving model as its capabilities fully eclipse those of humans and the model proliferates across the broader economy. It is difficult to predict what the economy looks like if human labor stops being competitive.Even if model development became fully automated and recursive, we can’t predict what that would mean for most humans’ daily lives. Amdahl’s law applies here as well. Recursive intelligence could lead to achieving many of the benefits outlined in Machines of Loving Grace, quickly in some domains. We expect that embodied intelligence (i.e., robotics) might quickly follow recursive intelligence, and follow a similar path of increasing returns at decreasing cost. More powerful intelligence might help us build things in the physical world more quickly, run more productive clinical trials of lifesaving drugs, and develop novel forms of coordination.But achieving recursive improvement alone does not suggest an immediate change in how industrial production occurs, societies organize, or markets function. More intelligence can’t learn what a drug does over decades of use, can’t hold elections sooner than a constitution dictates, and can’t turn a stranger into an old friend in a weekend. For most people, the felt pace of this future will still be set by the bottlenecks, even if the laboratory upstream runs at the speed of compute. That collision, where recursive intelligence building itself ever faster meets the world of humans, relationships, and governance, is another part of this future we can’t predict.
What should we do?
If it were possible to effectively slow the development of this technology to give ourselves more time to deal with its immense implications, we think that would likely be a good thing. But if a slowdown simply lets the least cautious actors catch up technologically, it could leave everyone less safe. Without a global coordination mechanism, companies and governments will have to make difficult decisions about safety while under competitive and geopolitical pressures.
We believe it would be good for the world to have the option to slow or temporarily pause frontier AI development to enable societal structures and alignment research to keep up with the advance of the technology. The Anthropic Institute will conduct research—in collaboration with many others—and take actions to help build the systems that a credible slowdown or pause would require. These systems would enable frontier AI developers to verify that others globally have actually stopped or slowed, and that a bad actor could not use the auspices of a coordinated slowdown to jump ahead in secret. If such systems existed, we expect that we would slow down or temporarily pause, if other developers at or near the frontier also did so in a verifiable manner.
A meaningful slowdown or pause would require multiple well-resourced labs at or near the frontier, in multiple countries, agreeing to stop under the same conditions. It would also require that each can verify that the others have actually stopped. Due to the unique characteristics of AI systems, the detectability (a lower standard than verifiability) element of this arms control problem is much more challenging than with other technologies. Training runs are far easier to conceal than missile silos, their inputs are general-purpose, and the incentive to defect quietly is enormous, because whoever continues while others pause could inherit the lead. A credible pause also has to specify what triggers it, what lifts it, and who adjudicates.
None of this is necessarily impossible in principle—the world has built verification regimes for other complex technologies (e.g., the Intermediate-Range Nuclear Forces Treaty)—but those regimes took decades to build both the infrastructure and the trust. We don’t have that long. A unilateral pause by one lab, by contrast, is achievable immediately, but accomplishes much less: it would change who the front-runner is, but it would not create the wider deliberative process that is currently missing.
In the coming months, we will organize conversations where policymakers, researchers, civil society, and other AI companies can help answer some of the questions this piece raises, especially around full recursive self-improvement and how to create better options for coordination and deliberation. We’ll publish what comes out of it. The window to investigate the questions together is here, and people outside AI companies should be involved in this deliberation.
Marina Favaro and Jack Clark co-authored this piece, with editorial support from Santi Ruiz. Shan Carter, Romello Goodman, and Nikki Makagiansar created the visuals from data collected by Brian Calvert and Jun Shern Chan. Daniel Freeman, Jim Baker, Max Young, Sarah Pollack, Francesco Mosconi, Holden Karnofsky, Andy Jones, Kevin Troy, Chloe Lubinski, Anton Korinek, Meg Tong, Andrew Ho, Dan Altman, Drake Thomas, Jack Shen, Sasha de Marigny, and Avital Balwit provided feedback.
Update 9/18/2026
- METR’s key measure tells you the time horizon over which AI systems can be 50% reliable at a basket of tasks, though the trendline looks the same at 80% reliability.
- Especially as they shift toward more open-ended formats and more difficult tasks (e.g., Olympiad-level mathematics), benchmarks often saturate below 100% due to errors in the question and answer sets like ambiguous problem statements and unsolvable questions.
- Anthropic leadership have publicly estimated that 90% or more of our code is written by Claude, including scripts and experimental code. Our >80% figure measures the share of lines merged to production that can be attributed to Claude. This is a more conservative measurement in two ways: our attribution pipeline has gaps, and the lines not attributed to Claude include auto-generated code and other artifacts that were not hand-written by humans either.
- This surge in code production is straining the infrastructure everyone shares. GitHub—the platform most of the world’s software is built on—saw roughly one billion code commits in all of 2025; by mid-2026 it saw 275 million a week, on pace for roughly 14 billion over the year. The company’s COO has said that it is “pushing incredibly hard” on capacity just to keep up.
- Additional details on the methodology of this survey are discussed in section 2.3.5 of the Claude Opus 4.7 System Card.
- Many respondents may not have thought carefully about how to account for various biases or subtleties in the question definition, and recent research by METR shows that developer estimates of AI productivity uplift can be overestimated.
- How large the speedup gets depends heavily on how much room for improvement the starting code leaves, and it should not be read as a real-world training speedup. So the absolute multiple is not the figure to anchor on here. What is more informative is the like-for-like comparison that this experimental setup makes possible, both across models (~3x to ~52x over the past year) and against a skilled human (~4x in four to eight hours on the same task).
- As a check on judge bias, we ran the same test on a separate set of 127 moments where the human’s next move was already strong (as opposed to the original set, where the human’s direction had room for improvement). There, the models’ suggestions were judged better only about 20% of the time.
* Quotes from Anthropic employees throughout this article are drawn from internal discussions and used with permission. They reflect individual views as of May 2026, not official company positions.