World Labs 发布 Atlas:一个面向“空间智能”的全能世界模型 模型可以精准模拟三维空间里的位置、朝向和运动轨迹
World Labs 把文字、图像、相机位姿与深度放进同一个三维上下文:既能沿指定镜头生成视频,也能补出点云、Gaussian Splatting 和机器人传感器视图。
- Atlas 的核心变化是把相机位姿作为原生输入,让用户用三维轨迹控制每个观察位置,而不只靠文字描述运镜。
- 同一个模型完成新视角生成、稀疏图像重建、点云与 Gaussian Splatting 输出、子弹时间和机器人 RGB/深度模拟。
- 输入少时,结果包含更多生成补全;输入增加会强化现实约束,但未观测区域仍不能当作测量事实。
- 官方基准显示相机跟随和三维点图误差领先多项对比模型;样本规模、成本、延迟、训练细节和独立复现尚未公开。
World Labs 发布其全新的世界模型 Atlas,并把它称作一个面向“空间智能”的全能世界模型。它接收文字、图像、相机位姿和深度图,把这些输入组织进同一个三维空间上下文,再生成新视角、视频帧、深度与显式 3D 表示。目前 Atlas 仍处在面向少量合作伙伴的早期访问阶段。
这次发布最大的亮点是相机本身成了模型的原生输入。用户不必只写“镜头向左平移”或“从低角度推进”这类文字提示,而是可以给出相机在三维空间里的位置、朝向和运动轨迹。模型据此决定每一帧应该从哪里看、看到什么,并尽量让不同视角属于同一个空间。
这也解释了 Atlas 为什么同时出现在视频生成、三维重建、视觉特效和机器人模拟四个语境里:四种应用共用的底层问题,都是“一个世界在不同位置、不同时间、不同传感器下应该呈现什么”。
图像到世界:输入图约束已有内容,镜头移动时模型继续补出画面外空间。


World Labs 官方演示;主秀场为 720p 本地预览转码,内容未剪辑。图像与视频均不作为第三方实测。
点击播放按钮查看原始视频;拖动进度条可检查长镜头中的空间连续性。
一条主线串起四种能力
Atlas 的输入并不只是几张散落的参考图。每张图和深度图都与一个明确的相机位姿绑定,文字、图像、相机和深度共同形成“空间上下文”。模型随后沿序列逐项生成结果:下一张图、下一段相机轨迹下的帧、对应深度,或可以导出的三维数据。


关键:相机不是一句模糊的运镜提示,而是空间上下文里的几何条件。
下方帧、视频与深度图来自 World Labs 官方模型架构示意。
点击架构示意中的视频,观察模型怎样把序列中的下一项继续生成为画面。
这套组织方式带来四类能力:
- 相机可控生成:从一张或多张参考图出发,沿指定相机轨迹生成新视角和视频。官方页面给出的上限演示是 1440p、1 分钟。
- 稀疏视图重建:用一张到数十张照片补出新视角,并输出点云或 3D Gaussian Splatting 场景。
- 时空重构:把少数普通相机拍摄的动态片段重新定格、换角度,做出类似“子弹时间”的效果。
- Real-to-Sim:从现实环境的少量影像构建模拟场景,再从机器人机身相机的轨迹生成 RGB 与深度观测。
Atlas 还会做文生图、文字渲染和 360 度全景图,但这些更像统一模型顺带覆盖的任务,并不是这次发布的主线。
相机控制为什么比文字提示更硬
普通视频模型通常把镜头运动当成语言意图。用户写“crane up”,模型理解到大致的上升运镜,却未必严格执行位移、角度和速度,更难保证复杂轨迹中的空间一致性。
Atlas 把相机几何直接写进输入序列。World Labs 的描述是:每张图像和深度图都由显式相机位姿约束。因此,用户可以手工设计镜头路径,而模型的任务是在每个指定位置生成符合已有空间上下文的画面。
这里的“像素级相机控制”容易被误读。它指的是相机轨迹能够以精确几何参数输入,并不等于模型会逐像素忠实复刻现实。相机指向素材从未拍到的区域时,Atlas 仍然要依靠训练中学到的世界知识进行补全。官方单图示例里,模型生成了机器人背面,也猜测泳池旁边应该有草坪;这些内容看起来合理,却不是从原图恢复出来的事实。
官方推文把一段 1440p、1 分钟的演示描述为由 7 张参考图生成;博客对一般视频能力的说明则写“1 到 6 张输入图像”。页面没有解释这两个口径如何对应,因此更稳妥的结论是:Atlas 展示了用少量参考图和手工相机轨迹生成长视频的能力,具体输入上限与计数方式仍待产品文档明确。


空间锚点:两个输入固定局部外观,中间不存在于输入里的连接空间由模型生成。


长镜头:官方原片为 1440p、60 秒;这里使用完整 60 秒的 720p 本地预览转码。
World Labs 官方输入与输出。锚点以外的区域、参考图没有覆盖的背面和连接关系都可能是生成补全。
先看输入图,再播放输出;重点观察镜头经过未拍摄区域时,哪些内容是模型补出来的。
“重建”与“想象”共用同一条滑杆
传统三维重建希望恢复相机真正看见的几何;生成模型则擅长补出没有观察到的内容。Atlas 把两者放进同一个模型:输入少时,它需要更多想象;输入增加时,空间上下文对结果的约束变强。
大范围依靠补全
较忠实重建
生成空中路径
更多现实细节
显式 3D 只说明结果可被三维工具使用,不代表所有区域都来自真实测量。
World Labs 的例子很直观:一张地面照片只足以约束花园,模型从空中看到的其余建筑主要靠猜;加入旁边小屋的照片后,小屋被固定下来,但左侧房屋仍是生成内容;再加入主楼照片,整个场景才获得更多现实约束。Stanford Main Quad 的演示使用 2 到 25 张地面照片,却能生成高空飞行视角。官方还称模型的空间上下文可以容纳 100 张以上图像。


World Labs 官方演示。多条轨迹共享同一组输入,但逐条生成并不自动证明所有路径之间达到测量级一致。
分别播放四条路径,比较同一场景在不同观察轨迹下的布局与外观是否保持一致。
因此,Atlas 的“重建”并不是一份天然等同于测量结果的数字孪生。它输出的是被观测区域与生成补全区域的混合体。做影视预演、游戏场景或交互式浏览时,合理补全很有价值;做工程测量、事故取证或需要精确尺寸的任务时,未观测区域必须被视为推断,不能当作现场事实。
从新视角画面,到可以交给下游工具的 3D
新视角图像仍是二维结果。游戏、VFX、设计和机器人工作流往往还需要显式三维数据。Atlas 同时处理图像帧与深度图,可以输出点云,也可以把场景转换为 3D Gaussian Splatting。
点云用离散三维点描述几何轮廓;Gaussian Splatting 则用大量带位置、形状、颜色和透明度的三维高斯“斑点”表示场景。视角改变时,这些斑点被快速投影到屏幕上,适合高分辨率实时渲染。World Labs 现有的 Marble 产品也使用这一表示,所以 Atlas 生成的场景可以进入同一产品栈。
Atlas 从单张图生成三维世界时,会先生成新视角并估计几何;从现实视频重建时,会预测每一帧的深度,再把它们融合为点云和 splat。两条路径都可能填补相机从未看到的区域。显式 3D 输出让结果变得可渲染、可遍历,却不会自动消除生成误差。
World Labs 官方演示。可实时渲染不等于几何已通过测量验证,画面外区域仍可能来自模型补全。
点击播放,留意视频从二维输入、新视角生成切换到显式三维飞行视图的阶段。
时间维度让它进入 VFX 与机器人模拟
空间一致性解决“从哪里看”,时间建模还要解决“世界怎样变化”。Atlas 的子弹时间演示使用 3 到 5 台装在三脚架或夹具上的普通手机、运动相机,从少数同步视角重构动态瞬间,再生成拍摄设备没有占据过的观察角度。它降低的是多视角采集的设备与布置门槛,不代表只凭单目视频就能无损恢复任意动态场景。
机器人场景里,Atlas 承担两步工作。第一步是把现实空间变成显式三维场景;第二步是在机器人沿某条轨迹移动时,生成机身相机本应看到的 RGB 图像和深度图。官方导航演示从两处大型环境的手机视频中各取 24 帧做重建,再模拟不同机器人沿不同路径移动。操作任务演示还加入物体、位置、机器人动作、光照和背景变化,用于扩充训练与测试场景。
这条路线有明确价值:过去为机器人建立仿真环境,常要激光扫描、专业相机、人工建模和逐项调参;如果少量日常影像就能生成可用场景,环境覆盖速度会显著提高。但发布材料展示的是环境与传感器数据生成,没有给出机器人策略在闭环训练、迁移到真实设备后的成功率提升。因此,“能生成模拟观测”和“能训练出更可靠的机器人”仍是两个需要分别验证的命题。


官方采集幕后:3–5 台普通相机从少数视角拍摄,页面中的交互演示再把动态瞬间重构到新角度。
World Labs 官方演示。它证明的是场景和传感器观测可被生成;发布页没有提供由此带来的机器人闭环策略成功率。
点击播放两段机器人演示;把“生成训练环境”与“训练出的策略是否更可靠”分开判断。
多模态、自回归、扩散与 Transformer 各做什么
World Labs 把 Atlas 的架构称为“多模态自回归扩散 Transformer”。四个词分别对应不同职责:
- 多模态:当前输入输出类型包括文字、图像、相机位姿和三维深度图;视频被表示为图像序列。
- 自回归:整个任务被排成一个序列,模型一次生成一个新元素,并以前面已经出现的输入和输出为条件。换一种序列排列,就能把同一个模型用于生成、重建或模拟。
- 扩散:每个高维连续输出通过逐步去噪生成。Atlas 使用 rectified flow;推理时可以改变去噪步数,在速度与质量之间取舍。
- Transformer:负责对序列中的跨模态关系建模,也让系统能够借用大语言模型服务中的 KV cache、缓存路由与分离式推理等工程方法。
这不是把语言模型和视频模型简单拼接。Atlas 的核心设计是让不同模态共享带三维位置的上下文,再用自回归顺序决定“接下来生成哪种元素”。它从视频模型继承连续视觉生成能力,也从语言模型继承可扩展的序列建模与服务方式。
官方基准说明了什么
World Labs 公布了两组自测结果。
相机控制测试把一张输入图与 1 到 3 段电影运镜组合起来,由第三方人类评分者判断哪一个模型更符合目标轨迹。Atlas 相对五个对比模型的偏好率如下:
| 对比模型 | 评分者选择 Atlas 的比例 |
|---|---|
| MiniMax H3 | 75% |
| Gemini Omni Flash | 81% |
| Happy Horse 1.1 | 86% |
| FLUX 3 | 93% |
| Seedance 2.5 | 94% |
Atlas 在测试中直接接收原生相机轨迹;其他模型不接受这种输入,只能通过 pan、truck、crane 等文字术语描述运镜。这个对比证明了“原生相机接口在相机跟随任务上有优势”,却不是一般视频质量的全面排名。官方也承认,更复杂的提示工程或多模态提示可能改善对比模型结果。页面没有公布评分人数、样本数、置信区间、生成成本或延迟。
三维重建测试要求模型根据带相机位姿的稀疏图像,为每个输入像素预测对应的三维点。官方以平均绝对相对点图误差衡量,越低越好,并称所有基线都在统一协议下复现:
| 模型 | 7 个数据集平均误差(AbsRel ×10⁻³) |
|---|---|
| Atlas | 25.3 |
| Pi3X(posed) | 28.7 |
| π³ | 34.7 |
| VGGT-Ω 1B | 36.4 |
| Depth Anything 3 | 39.3 |
| MapAnything | 47.7 |
页面还列出了 DTU、ETH3D、KITTI、NRGBD、7-Scenes、Tanks and Temples 与 ScanNet 的分项结果;Atlas 在多数项目中误差最低,在 Tanks and Temples 上与 Pi3X 同为 42.4。结果支持 Atlas 具备有竞争力的几何预测能力,但目前材料仍是公司博客,而非附带完整训练细节、模型权重、代码和可复现实验的论文。
早期访问阶段还缺哪些答案
Atlas 已展示出一条清楚的技术路线,但公开材料没有回答几个直接影响实际使用的问题:
- 模型规模、训练数据组成、训练计算量与数据授权方式;
- 一分钟 1440p 视频的生成时长、硬件需求、价格与失败率;
- 多次沿不同轨迹生成时,场景一致性能保持多远、多复杂;
- 生成区域与观测区域是否有可靠的置信度或可视化标记;
- 动态场景中的遮挡、非刚体运动和长时物理一致性上限;
- 导出的点云和 Gaussian Splatting 在尺寸、碰撞、编辑与仿真引擎中的可用程度;
- Real-to-Sim 数据是否能稳定提高真实机器人策略的成功率。
World Labs 称 Atlas 从零预训练,并观察到训练计算增加时性能持续提高。但公开页面没有给出缩放曲线或对应数值,这一部分目前应理解为公司的研发判断。
Atlas 的方向已经足够明确:它把生成式视觉模型从“根据一段描述造一段画面”,推进到“在一个带坐标的空间上下文里,按指定观察者轨迹持续生成世界”。如果后续 API 能把相机、深度、显式三维和时间控制稳定地开放出来,影视预演、游戏场景搭建、空间设计和机器人仿真会第一次共享一套生成底座。真正决定它能否进入生产环境的,将是可复现的空间一致性、运行成本,以及系统能否清楚标出哪些部分来自观测、哪些部分来自想象。
Atlas: A World Model for Spatial Intelligence
Introducing Atlas, our new omni world model for spatial intelligence.
World models generate, reconstruct, and simulate any possible world. They understand how worlds appear, behave, and evolve so that we can render imagined worlds for creative users, simulate the real world in high fidelity, and help robots plan actions. At World Labs, we build these general purpose world models in pursuit of spatial intelligence.
Today we are introducing Atlas, our next-generation world model. Atlas is an omni model that we pretrained from scratch to natively operate on text, images, video, and 3D. It is a multimodal autoregressive diffusion transformer: all inputs are combined into a shared spatial context. Atlas uses that context to generate what comes next, staying consistent in 3D with everything it has seen and imagining what lies beyond it. Atlas is built to scale: its performance improves with increased training compute, and we expect this trend to hold as we continue scaling.
Atlas can perform a broad range of tasks spanning world generation, reconstruction, and simulation:
- Camera-Controlled Generation: Atlas generates images and videos from one or more images with pixel-perfect camera control, outputting up to 1 minute of video at 1440p.
- Spatial Reconstruction: Atlas reconstructs real world scenes from one to dozens of input images. It generates both image frames from novel views and explicit 3D outputs, outperforming state-of-the-art models specialized for 3D reconstruction.
- Space-Time Simulation: Atlas models space and time from input videos, reframing videos for dramatic visual effects and enabling Real-to-Sim workflows for robotics.
- Image Generation: Atlas generates images and 360 panoramas from text; it can follow complex prompts, render text, and generate a wide variety of visual styles.
Atlas will power future versions of Marble and other products from World Labs.
Camera-Controlled Generation
Atlas takes one or more reference images and generates new views at any camera position and angle you specify. Generated views match the content and geometry of the input images, smoothly extrapolating beyond them to imagine parts of the scene not visible in the inputs.
Atlas handles a broad range of scene types, visual styles, and camera motions.
Pixel-Perfect Camera Control
Atlas uses precise camera geometry as a native input type, going beyond coarse text-based instructions for camera control. This lets you frame every shot and control every motion.
In the examples here, Atlas generates a complete scene from a single input image. It uses the content of the input image along with its broad world knowledge to imagine what the scene should look like from new angles. For example, it generates the back side of the robot, and it guesses that there should be a grassy lawn next to the pool.
From a single image, Atlas generates views from any angle. Drag to change the view.
Generating with Spatial Context
Similar to an LLM, Atlas first encodes its inputs into a context, then generates outputs conditioned on the context. However, Atlas is unique because each image is grounded at a 3D position in space; this forms a spatial context.
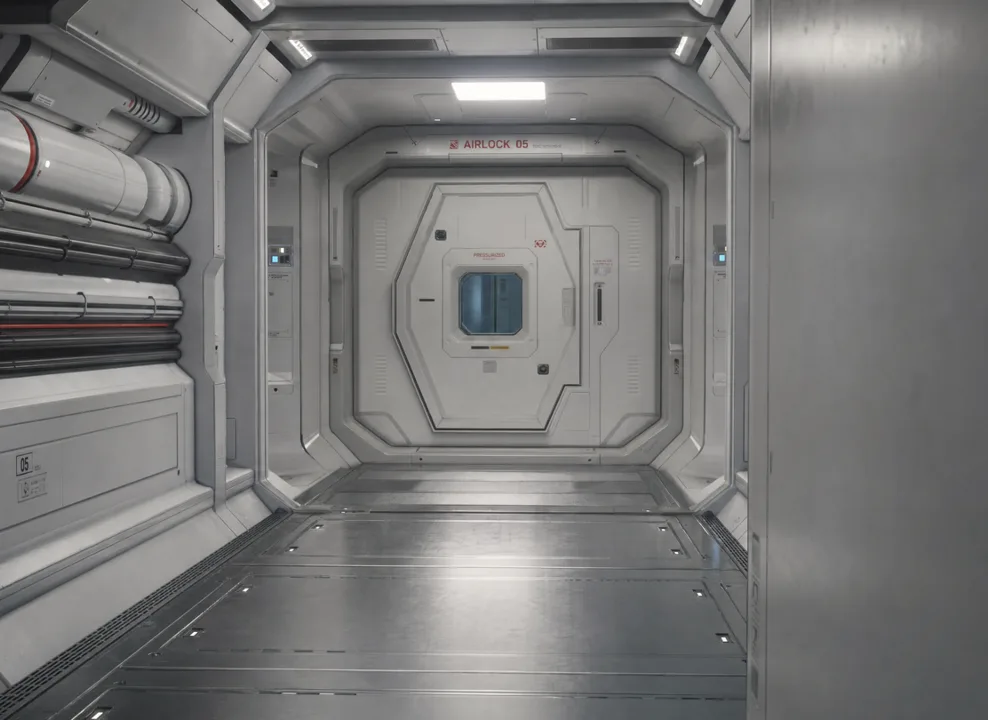
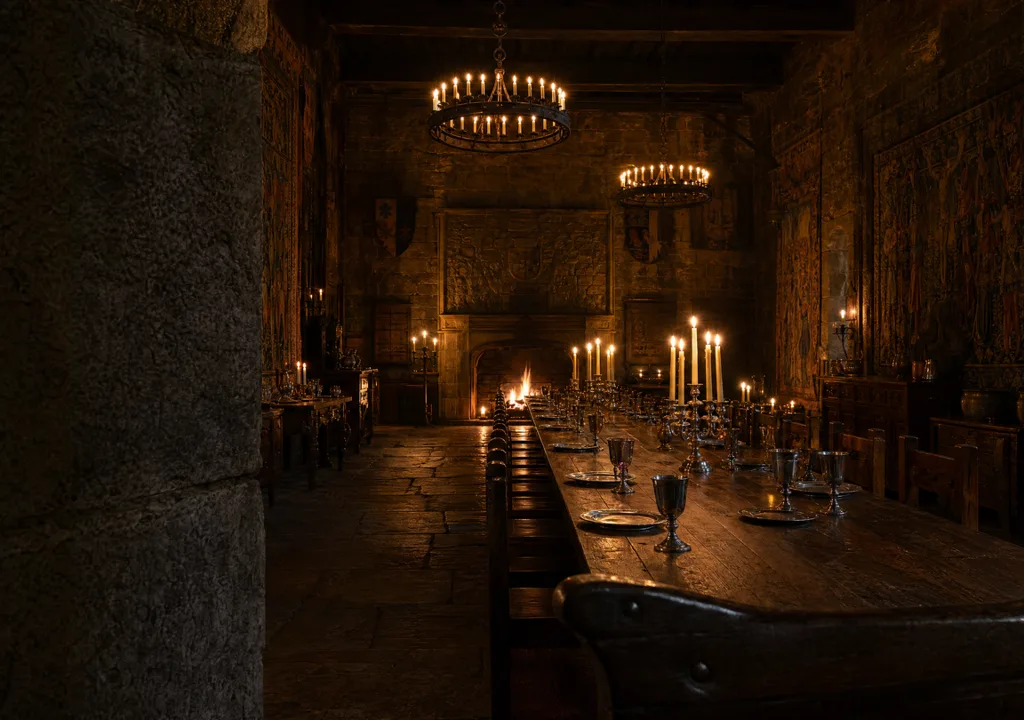
Managing this spatial context unlocks entirely new kinds of creative control. For example, you can place two unrelated reference images in the context and position them in 3D space; Atlas then generates a world that smoothly interpolates between them.
These examples demonstrate the model's world knowledge and creativity; it imagines doorways, hallways, nooks, and other transitions between otherwise unrelated image pairs.
Controllable Long Videos
Atlas lets you generate long videos with precise control by combining camera movement and spatial context management. You design every scene and every camera angle. This puts you in the director's chair: you are staging the scene, not pulling the lever of a slot machine.
In the example below, we generate a 1 minute video at 1440p resolution using a small number of reference images. We hand-design a camera path through the scene, and Atlas generates a coherent world. The rest of the videos on this page have been compressed to optimize page performance.
Spatial Reconstruction
Atlas reconstructs real-world spaces from one or more input images. It does not require special capture equipment or hundreds of dense views to faithfully reconstruct objects and scenes. We believe Atlas is a major step forward toward solving the problem of novel view synthesis from sparse input images, a decades-old fundamental problem in 3D computer vision.
Reconstructing from Multiple Images
Atlas can take a variable number of input views of a scene. When parts of the world are not visible in the input views, Atlas imagines a plausible way to fill in the gaps by drawing from its rich world knowledge.
But sometimes you do not want imagination; you might want an exact reconstruction of a real-world location. Passing more input images gives Atlas more context: the more it sees, the less it imagines. Atlas typically gives faithful reconstructions with as few as two or three images, outperforming state-of-the-art results by models specially trained only for 3D reconstruction. However, Atlas can also make use of over a hundred input images in its spatial context, allowing for faithful recreation of real world environments.
In the first example below, Atlas generates an aerial view of the scene from just a single ground-level photo. The garden visible in the single input photo is accurately recreated in the model output, but the rest of the scene is imagined. After adding a second real-world input image of the cottage next to the garden, the model's output shows both the garden and the cottage, but it still imagines the house to the left; with a third input image of the main house, the entire scene is accurately depicted.
In the second example, we build up Stanford's Main Quad piece by piece, beginning with the grassy main entrance and ending with the colorful mosaics decorating the facade of Memorial Church. Though Atlas only receives two to twenty-five ground-level input images, it can generate paths from aerial views flying far above the campus.
Reconstructing Diverse Paths
Atlas can generate many different trajectories through the same scene, giving new perspectives on the same input images. No matter how many times you change the camera path, the scene stays consistent.
In the example below, we show that given a small set of input images, Atlas can generate multiple camera paths through the same scene. Different camera paths can emphasize various parts of the scene or change moods by varying in speed, length, or complexity.
Atlas can generate many different paths through the same scene using a small set of input images.
Explicit 3D Outputs
In the results above you have seen Atlas output 2D images and videos, which are sufficient for some applications. But workflows in robotics, gaming, design, VFX, and beyond often require explicit 3D outputs. Atlas natively operates on both 2D image frames and 3D depth maps, enabling it to output worlds as point clouds or 3D Gaussian splats.
From one image, Atlas generates new views and 3D geometry, then converts to 3D Gaussian splats
From a single input image, Atlas produces a full 3D world by jointly generating new views and estimating their geometry. From a video of a real space, it predicts the depth of every frame and combines them into a 3D reconstruction. In either case, Atlas fills in regions that no camera ever saw.
Atlas can reconstruct 3D point clouds from input videos
Point clouds estimate a scene's geometry, but 3D Gaussian splats make it usable. Atlas fills the remaining gaps and turns the point cloud into a complete splat scene that renders on-device at high resolution and frame rates. This is the same representation used in Marble, enabling Atlas to integrate naturally with the rest of our products.
Explore Gaussian splat scenes reconstructed by Atlas
Space-Time Simulation
Atlas serves as a world simulator. It understands both the spatial structure of the world and how the world evolves over time. Combining its spatial and temporal abilities leads to new applications for VFX, robotics, and beyond.
Reframing Video
Atlas turns a handful of ordinary cameras into a "bullet time" multiview capture studio. With footage from as few as three cameras, Atlas can freeze time and reframe shots, letting you view events from impossible angles.
Real-world videos can be reframed from new camera angles without an expensive capture studio
Notably, these shots did not require professional photographers or specialized equipment. Each of them was filmed by a few engineers and researchers with ordinary cell phones on tripods and clamps that fit in a backpack. Atlas reconstructs the scene from three to five camera views, after which you can reframe shots however you like.
Behind the scenes: the clips above were captured using just a few cell phones and action cameras
Robotics Simulation
Atlas opens up new ways to scale Real-to-Sim for both navigation and manipulation.
You have already seen Atlas reconstruct a space in explicit 3D from a few images. For robotics, reconstruction is only half the job: as a simulated robot moves through space, Atlas also generates the RGB and depth data its sensors would observe along the way. The world and the robot's view of it come from the same model.
In these examples, we captured two large environments with a cell phone video, using 24 frames each for reconstruction. Scanning spaces like these traditionally requires elaborate and expensive equipment. We then simulate different kinds of robots navigating different paths and use Atlas to generate images from the perspective of the robot's body-mounted cameras.
Atlas reconstructs spaces and aids in simulating robot navigation
Robotic manipulation goes a step further. From a few casual recordings, Atlas aids in building a simulation that also captures how objects move and interact. Once a task is simulated, you can vary it easily: change the objects, their positions, the robot's motion, the lighting, and the background. The result is diverse training data and testing environments for robotics at scale.
Atlas enables Real-to-Sim from just a few real-world recordings, recreating physical interactions with rigid, articulated, and deformable objects while supporting controllable variations.
Image Generation
The primary focus of Atlas is world modeling, and every image is a window to a possible world. Though image generation is not its primary focus, Atlas is a capable image generator: it follows complex prompts, renders text, and generates a wide variety of visual styles.
Atlas also generates 360 images from text or image prompts, where again it can generate a wide variety of scene types and visual styles.
Technical Details
Model Architecture
Atlas is an omni model designed to handle many tasks and many kinds of input and output data in a single unified architecture, putting spatial control at the heart of the model. These goals require us to depart from standard architectures used by both LLMs and video models, and design a new base architecture to serve as the foundation of future world models.
Atlas is a multimodal autoregressive diffusion transformer. Its inputs are grounded in 3D space to form a spatial context, and it generates multimodal outputs conditioned on its context.
Atlas is a multimodal autoregressive diffusion transformer. It operates on multimodal sequences, generating each new element of the sequence one at a time. These architectural properties work together to achieve our goals, and taken together they enable a new paradigm of generation based on a spatial context. We unpack these ideas in turn:
- Multimodal: Atlas can natively process many different data types. At present it can operate on text, images, camera poses, and 3D depth maps; videos are represented as sequences of images. Each image and depth map is conditioned on an explicit camera pose, making spatial control a central component of the architecture.
- Autoregressive: Atlas operates on sequences of elements, where each element is one of the multimodal data types above. Each output is generated one at a time, conditioned on earlier parts of the sequence. This flexible design naturally adapts to a wide variety of tasks: each task is just a different kind of sequence, where inputs are followed by outputs.
- Diffusion: Atlas is a rectified flow model that generates outputs by gradually denoising them. Diffusion models excel at modeling high-dimensional continuous data like images and video, and can naturally trade off speed and quality by varying the number of denoising steps used during inference.
- Transformer: The transformer architecture consists primarily of large matrix multiply operations and is well-adapted to modern hardware. It is a robust backbone for world modeling.
Atlas is a blend of ideas from modern LLMs and video models. It can benefit from architectural, algorithmic, and systems advances used in both types of models.
Like an LLM, it is an autoregressive transformer, so it can take advantage of innovations used to serve and accelerate LLMs including KV-caching, cache-aware routing, disaggregated serving, and more. Like a modern image or video model, it is a latent diffusion model and can make use of algorithms such as diffusion distillation, classifier-free guidance, shifted noise schedules, and advances in VAE design.
Benchmarks
Atlas is an omni model for world modeling that performs many tasks. There is thus no single benchmark that fully captures its generality. We highlight quantitative evaluations of Atlas on two key tasks: camera-conditioned generation and 3D reconstruction. On both tasks it outperforms more specialized models.
We compare against a selection of top-performing video models for camera-conditioned generation. In each trial, we pair a single input image with a sequence of one to three cinematic camera motions (pan, truck, crane, etc.).
We prompt each model with a single input image and a target camera path. For Atlas, we encode the camera path using its native camera input format. Other models do not accept cameras as a native input format, so we describe the camera path in the input text prompt, using standard cinematic terms. It is possible that more sophisticated prompt engineering or creative multimodal prompts could improve camera following for some models, but we use text as it is the most common input modality for describing camera motions.
Third-party human raters judge which model better follows the intended camera path. These results confirm that Atlas outperforms recent video models at camera-controlled generation, and this advantage grows as camera trajectories become more complex.
We additionally evaluate Atlas on the task of 3D reconstruction from sparse input views. In each trial, the model receives a set of images and their camera poses, and predicts a 3D point corresponding to each input pixel. This problem has attracted much interest in the academic community, and many specialist reconstruction models have been developed in recent years.
Atlas is an omni model which performs both generation and reconstruction. Despite its generality, Atlas outperforms the best specialized open-source reconstruction models.
We evaluate on several state-of-the-art benchmarks for this task, reproducing the results for all baselines to ensure a common and fair evaluation protocol across all methods.
Model Scaling
Most progress in modern AI has been driven by scaling. Models improve in large part by scaling up simple algorithms to make use of more data and compute.
We see strong evidence that Atlas will continue to improve with scale. We pretrained Atlas from scratch on a large diverse corpus of multimodal data. Over the course of development, we trained a series of models of increasing size and training compute, and found that each new level of compute unlocked new model capabilities. We are confident that our future world models will follow this trend, dramatically improving their capabilities as we continue to scale.
Build with Atlas
Atlas is entering early access with select partners. If you would like to build with it, request access below and we will reach out. We are excited to see what you build, and to work with you to make Atlas the go-to world model for generating, reconstructing, and simulating any world.
We are also hiring across research and engineering to advance spatial intelligence.
This post was produced by the World Labs team. Please cite as:
@article{worldlabs2026atlas,
    author = {World Labs Team},
    title = {Atlas: A World Model for Spatial Intelligence},
    journal = {World Labs Blog},
    year = {2026},
    note = {https://www.worldlabs.ai/blog/atlas},
}