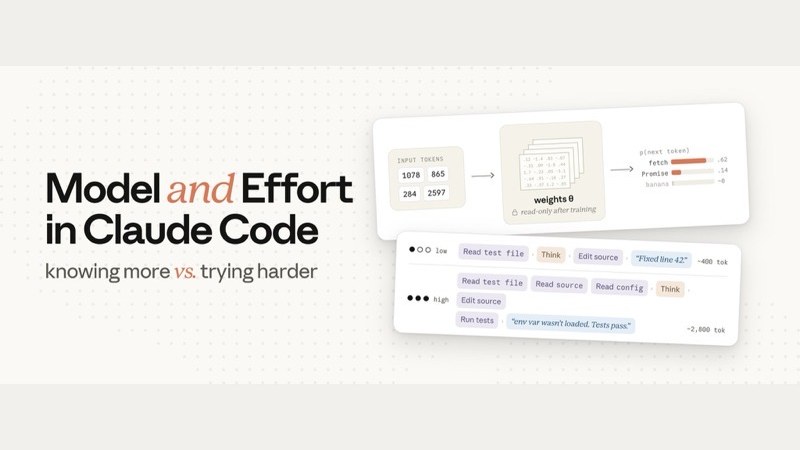
Claude Code 团队教你如何用好这两个旋钮:一个管它「会不会」,一个管它「愿不愿做够」
- Anthropic 面向开发者的账号 @ClaudeDevs 于 2026 年 7 月 8 日发布长文,作者是 Claude Code 团队成员 Lydia Hallie(@lydiahallie)。
- effort(努力程度)控制这次任务里 Claude 整体做多少活:多想、多读文件、多跑测试、多验证、多步推进多远再问你。API 侧常见五档:low / medium / high / xhigh / max;多数任务用模型默认档即可。
- 模型设置决定用哪一套训练好的冻结权重,也就是「知道什么」;effort 决定「做多彻底」。答错了先查上下文,再问:是「不会」还是「没用力」?
- 角色类比:Fable 像专科医生,Opus 像专家,Sonnet 像靠谱全科;effort 是他们愿意在你这单上花多少时间。
- 简单任务大模型更贵;难的多步任务大模型有时总账更低,也能做完小模型做不完的活。Opus 4.8 默认 effort 在测试里约等于 4.7 默认 token 量,效果更好。
两个旋钮,看起来都在「把答案变好」
2026 年 7 月 8 日,Anthropic 开发者账号 @ClaudeDevs 发了一篇 Claude Code 长文,作者是 Claude Code 团队成员 Lydia Hallie。
effort 是什么:同一模型,这单活做到多彻底
在 Claude Code 里,effort(努力程度)是和模型选择并排的设置。它不改模型「会不会」,只告诉同一套模型:这回你愿意多下多少功夫再交卷。常见误区是把 effort 理解成「想得更久」;其实它管的是整趟活做多彻底。
原文写得很直白:effort 控制的是这次请求里 Claude 整体做多少工作,不只包括想多久,还包括:
多开几份源码、配置、日志,还是只看你塞进对话框的那几段
改完跑不跑测试、复不复查结论、会不会自己再扫一眼边界情况
多步任务一口气推多远,还是很快停下来问你补上下文
先不先写计划、计划多深,找到答案后还要不要多验一步
API 文档里,effort 是行为信号,不是硬 token 上限:低档遇到真难题仍可能思考,但同一道题上会比高档「想得少、动得少」。官方列出的档位从省到狠大致是五档(Claude Code 界面里还会看到和多智能体权限绑在一起的 ultracode 一类入口,那是产品侧组合,不是多出一个 API 档名)。
任务固定:「线上登录接口偶尔返回 500,帮我查。」下面五档按官方 low → max 排列;条形只表达相对高低,不是实测 token 数。默认先看 high(API 不设 effort 时的行为档)。
原文建议:多数任务直接用该模型的默认 effort。默认是团队认为「大多数人愿意为这类任务花多少 token」的那一档。把它当整体偏好的手动覆盖:你长期要快或长期要抠时再动,不必每个任务拧一次。另:Opus 4.8 默认 effort 在团队测试里,大约用和 Opus 4.7 默认相近的 token,效果更好。调高了仍糊弄、漏读漏测,才是「没用力」信号;简单改文案却天天 max,多半是浪费。
模型换的是「知道什么」,effort 换的是「做多少」
模型更大,按行业常用基准,能力更强。这点原文直接认了。effort 则不换「会不会」,只改「这趟做多彻底」。
effort 高:更愿意自己读、自己验、自己推,再交卷。effort 低:更愿意先问你补上下文,而不是自己烧 token 去猜。
从你按下回车开始,请求里发生了什么
Claude Code 会把你的消息、系统提示、工具定义、CLAUDE.md、对话历史、当前上下文里的文件,打成一次 API 请求发出去。

模型并不直接「读中文句子」。服务器上先做 tokenization(分词):文本切成小块,每块映射成词表里的整数。原文举例:const 可能是 1978,await 可能是 4293。从这一刻起,提示词对模型来说就是一串整数。

模型的工作是:根据当前这一串 token,给词表里每个可能的下一个 token 打概率,再从中取样。在「const x = await」后面,「fetch」概率会很高,「banana」接近零。

把输入变成概率的是 weights(权重 / 参数):训练时写进模型、规模到数十亿级的矩阵数字。预测一个 token,就是把输入在这些矩阵上做一长串运算,读出末尾概率。权重里装着模型「知道」的东西;推理时权重是只读的。你的 prompt、CLAUDE.md、上下文都改不了权重,只是在「转向」下一次预测。

TypeScript、常见框架、一般编程常识,都是训练时写进权重的。把你的真实代码放进上下文,是 steering(转向):对这一次请求很管用,但不是往权重里「教」新知识。训练时还不存在的库,权重里没有;你可以贴文档让它用,只影响这一次。幻觉也是权重生成了「看起来像对」的 token 串,不是查表查失败。
所以换模型 = 换另一套冻结权重来处理你的请求。模型也不是一次写出整段答案,而是逐 token 预测:写出一个,接到序列末尾,再整串重算下一个。200 个 token 的回复 = 权重上走 200 遍。等待时间和输出费用,大量来自这个循环。

模型设置还决定每个输出 token 的单价。它不直接决定「生成多少个 token」。同样一句提示,Claude 决定做多少活,输出量可以差很多。控制那块的,是 effort。
思考、调工具、跟你说话,都是同一类输出 token
Claude Code 干活时,吐出来的 token 大致分三类:思考(streaming 里看到的推理)、工具调用(Read / Edit 等结构化块)、对你说的话(计划、进度、总结)。
三类都是同一个生成循环里的普通输出 token,按同样费率计费。思考 token 会留在这一轮后续上下文里:写代码时,更早的推理已经像「读过的文件」一样进输入了。

effort 等级会作为请求的一部分发给模型。模型在训练里学过各档 effort 该怎么表现,这些行为也写在冻结权重里。到了线上,effort 只是模型要响应的又一输入,和你的提示词一样:规定它要多彻底、多有把握才算任务完成。每一轮都会重新权衡;更高把握通常要花更多 token。

高 effort 时,Claude 常先写计划,且计划更深更广。计划不是锁死的:工具结果回来后,它会更新「进展到哪了、结果多有把握」。调试计划里三条假设,第一步就找到 bug,往往就明说后两条不必做,任务列表也会中途改写。
高 effort 也更爱多验一步:已经找到答案还复查,或仍扫一遍本可跳过的假设。但原文强调:训练时专门盯着「过度思考」,不会因为 effort 拧满,就在简单任务上硬刷用量;刷用量会伤实效。
日常怎么拧档,见上文「先搞懂 effort」;这里只补机制:档位作为请求输入,和提示词一样进入冻结权重学过的行为。
先查上下文,再分「不会」还是「没用力」
Claude 搞砸时,第一反应不该是改设置,而该看你给了什么:提示是否糊、工具是否对、技能是否齐。
若你在不该高 effort 的任务上硬抬 effort,问题通常在更上游:上下文、CLAUDE.md、任务怎么拆。
上下文已经清楚仍错,再问这一句:
是它不够会,还是不够用力?

问题本身难:隐蔽 bug、陌生领域、架构取舍。小模型再塞上下文仍自信地错,就上更大模型。大模型也更扛模糊;小模型更适合你能写死执行步骤的指令。
- 该用大:难、糊、反复自信错
- 该用小:机械改动、上下文里已有答案、描述精确的例行活
该读的文件没读、该跑的测试没跑、该复查的没复查。尤其是你把 effort 调到低于默认时最相关。
- 抬 effort:明显偷懒、漏验、半途就交
- 别抬:上下文烂、任务糊,先修上游
专科医生、专家、全科:谁来,以及待多久
作者用的类比:Fable 是几乎别人搞不定才叫的专科;Opus 是专家;Sonnet 是很强的全科。effort 决定他们在你这单上待多久。
别人卡住再叫。低 effort 也能看出别人看不出的点。单价最高,留给真需要的任务。
低 effort 像跟专家聊五分钟:代码库外的模式和坑他自带,但只会快扫,不会每文件细抠。
高 effort 像全科花一下午:编程功底扎实,会读、会跑、会复查,把你这份代码摸透。
模型设置 ≈ 多能干;effort 设置 ≈ 多彻底。没有 universally better 的组合。多数真实任务两边都要一点:Opus 低 effort ≠ Sonnet 高 effort 的简单替代,Fable 也不是日常默认。
简单任务和很难的任务,账单逻辑会反过来
模型、effort、token 消耗怎么缠在一起,取决于任务难不难。
例行活、同一 effort
大小模型一般都能做对。大模型常多走几步验证,token 更多,且单价更高。所以例行阶段降到小模型,能省真钱,质量往往不损。

难的多步活
小模型要在能力上限附近死磕,迭代烧得多;大模型用更少步数就能到同一质量。单价更高,但单任务总成本有时反而更低。更关键:有些活只有大模型做得到,effort 拧满也救不了小模型。
Fable 在长、多步任务上甩开距离最明显。团队测试里,它能完成 Opus / Sonnet 在任意 effort 下都够不着的活;单价也最高,所以更要留给真正需要的工作。

effort 决定 Claude 愿意沿曲线走多远,不等于它一定要走到那么远才收工。effort 塑造用量,但不是硬天花板。系统里真正的硬截断是 max_tokens:撞上会中途切断,偏钝,主要给 API 开发者。更软的约束如 task budgets、或提示里要求简短,是训练过会跟着走的指导:接近限额时倾向收束,而不是撞墙。
| 场景 | 更划算的倾向 | 原因(按原文) |
|---|---|---|
| 例行、描述清楚的改动 | 较小模型 + 默认 effort | 两边都能对;大模型多验、单价高 |
| 难、多步、模糊 | 较大模型,effort 用默认或按需抬 | 少轮次到质量线;有时总 token 更少;有的活只有大模型够得着 |
| 明显漏读漏测 | 先抬 effort(尤其低于默认时) | 问题是彻底性,不是权重里的知识 |
| 小模型自信错、上下文已足 | 换更大模型 | 问题是能力上限,不是再多读几遍 |
一句话记住,再回去拧旋钮
effort 改的是 Claude 做多少活;模型改的是 Claude 知道什么。
结果不满意时:先给清楚提示、对的工具和技能、以及自验路径。仍不对,再问:是不会,还是没用力?不会是模型问题,没用力是 effort 问题。
「Effort changes how much work Claude does. The model changes what Claude knows.」
两个都像「让答案更好」的旋钮:一个管它「会不会」,一个管它「愿不愿做够」
Claude Code 团队拆开一对容易混的设置,换模型是换它的脑子,调 effort 是改它这趟愿意做多彻底。一页带图讲完。
↓ 一页读完 · 有一张会动的图
Claude Code 是 Anthropic 给程序员用的 AI 编程助手(在电脑终端里帮你写代码、查 bug)。它有两个能拧的设置,拧了都感觉「答案更好」,很容易当成一回事。
一个换的是它「知道什么」,另一个换的是它这趟「做多少」。
换哪一套「冻结权重」(模型训练完就固定、推理时只能读不能改的一大堆参数,装着它「知道」的东西)。换模型 = 换个更强或更弱的脑子,能力、知识、见过多少坑。
同一个脑子,这趟活愿意多读几个文件、跑不跑测试、复不复查、自己推进多远,还是很快停下来问你。它管「做多彻底」,不是「想得更久」。
高 effort:「读了登录相关的好几处代码,复现了偶发报错,跑测试确认,根因是连接超时没重试。」
同一句话交给它,「做多少」能差很远。那到底分几档?
小互让 Claude Code 查一个 bug:「线上登录功能偶尔返回 500(服务器报错,用户登不上)。」同一个 bug,effort 五档各做多少活,
「多花 token(词元,模型处理文字的最小单位)」没体感,换成钱就有了:同一个 bug,高 effort 大约烧低 effort 约 7 倍的 token,多花的钱,换它自己读完、验完、复查完,而不是丢个补丁再回头问你。
animateMotion 沿轨道跑,越高档轨道越长、跑得越久,一眼看出「越彻底越慢越贵」,和 ④ 的 7× 呼应。场景全程挂在小互查「登录 500」上。
- **④ 数字自洽**:赛道条 84% 对 12%,除下来 ≈ 7,和数字卡「约 7×」算得上账;op-race-note 里点明这 7× 是原文示意图非真实 benchmark,把「哪些话别全信」压进这一行 + why 框,没单开收尾澄清节。
- **成本反转、角色类比**:成本反转折进 ④ 的 why 一句;角色类比(Fable/Opus/Sonnet)判断属正文可展开的细节,一页纸里不单开一节以免超屏,若你想让它在一页纸也露脸,我可以在 ② 或 ④ 加一行轻点,告诉我。
要不要我把它按 jiedu-explainer 的入库路径接上(写进这篇的一页纸 tab 并重建站点)?还是你先在预览里看动效对不对再定。
帮我查查!
不行把日志发我。
到底该拧哪个?
总行了吧!
就交卷了!
换更大的模型。
把 effort 抬高。
- × 那个 7×,是原文自己画的示意图
- × 成本曲线,不是真实测试
- × 也没第三方复现过
再动手拧旋钮。
effort 改「它做多少活」